はじめに
#2〜#4 のフィルタは、係数を人間が設計しました。#5〜#7 のカルマンフィルタとパーティクルフィルタは、モデルを人間が与えました。どちらも、設計に必要な情報が手元にあることが前提です。
実際の対象では、この前提が崩れることがあります。商用電源のハムは周波数も振幅も揺れます。ケーブルや部屋の伝達特性は測ってみるまで分かりません。モータの PWM がセンサへ乗り移る経路は、配線を変えるたびに変わります。係数を決めるための情報が無い、あるいは使っている間に変わる対象です。
#4 の固定ノッチ(Q = 30)で 50 Hz のハムを消している場面を例にします。周波数がわずか 0.3 Hz ずれると、次の図のように出力へ漏れます。
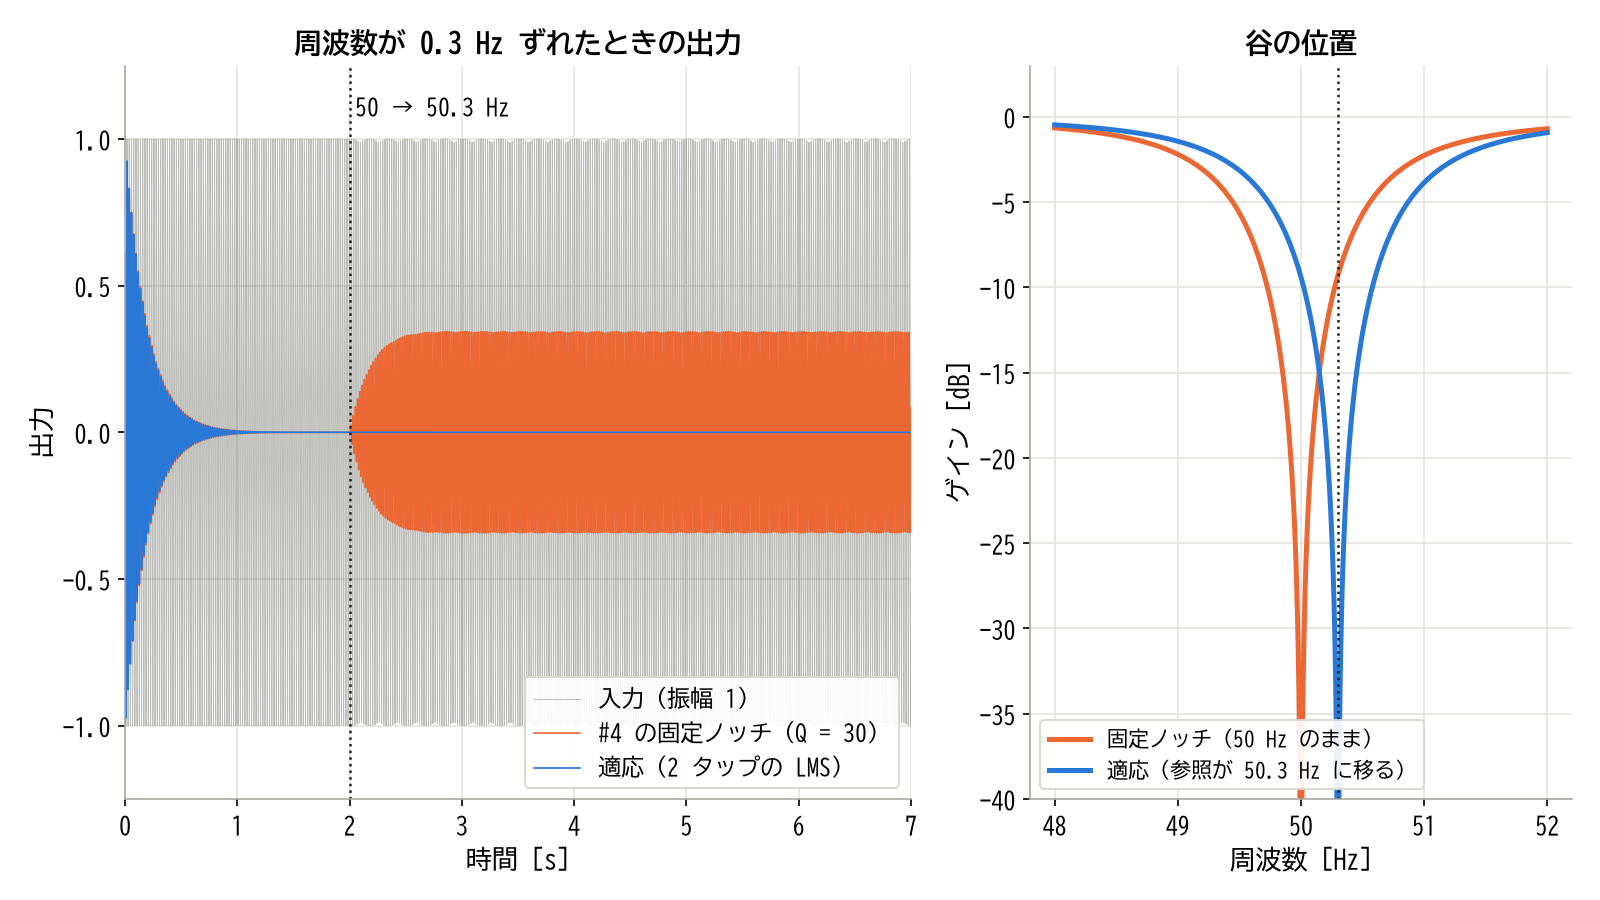
左:固定ノッチは 2 秒の周波数変化のあと振幅 0.34 まで漏れる。適応フィルタは 0 のまま。右:固定の谷は 50 Hz に残り、適応の谷は参照に合わせて移る
左の図のオレンジが固定ノッチです。50 Hz の間は出力がほぼ 0 ですが、2 秒で 50.3 Hz に変わると振幅 0.34(−9.3 dB)まで漏れます。谷が狭いほど信号は残りますが、ずれには弱くなります。青が適応フィルタです。立ち上がりに学習の時間がかかるものの、周波数が変わっても出力は 0 のままです。右の図のように、谷そのものが動くからです。
適応フィルタは、係数を設計せず、入力と誤差から学習させるフィルタです。必要なのは「何に近づければよいか」という目標の信号だけで、対象の式は要りません。
この記事のゴールは、参照信号(消したいものと相関のある信号)や目標信号が手に入る対象に対して適応フィルタの構成を選び、タップ数とステップサイズを式から決め、正しく学習しているかを数字で判定できるようになることです。2 乗平均誤差の碗の形から始めて LMS、NLMS、RLS を 1 段ずつ導出し、手計算で確かめ、周波数と制御工学の道具で読みます。そのうえで、ハムのキャンセル、PWM の経路同定、線スペクトルの抽出を設計します。実機は使わず、すべて計算と数値シミュレーションで示します。
- #1 基礎編 — サンプリング、伝達関数、ボード線図、効き目の測り方、C の骨格
- #2 ローパス — 移動平均、1 次 IIR、2 次バターワースを同じカットオフで比べる
- #3 ハイパス — DC とドリフトを消す
- #4 バンドパスとノッチ — Q と Audio EQ Cookbook で狙った周波数を扱う
- #5 カルマンフィルタ — モデルと分散で切り分ける
- #6 EKF・UKF — 線形でない対象へ広げる
- #7 パーティクルフィルタ — 分布をサンプルで持つ
- #8 適応フィルタ(この記事) — 入力と誤差から係数を学習する
- #9 以降 用途別のフィルタ(予定)
この記事で分かること: 適応フィルタが固定フィルタやカルマンフィルタと何が違うのか、2 乗平均誤差がなぜ碗の形になるのか、LMS の 1 行の更新式がどこから出るのか、速さと定常誤差がなぜ交換関係になるのか、NLMS と RLS は LMS の何を直したのか、RLS がカルマンフィルタとどう対応するのか、正弦波を参照にした LMS がなぜノッチになるのか、そして LMS、NLMS、RLS を何にどう使い分けるかの勘所が分かります。
読み終えたときにできること: 目標の信号と参照の信号を決めて 4 つの構成から 1 つを選び、誤調整(定常で増える誤差の割合)から μ や λ を逆算し、Python と C で動かせます。学習曲線、誤調整、ERLE(打ち消し量)で設計を判定できます。
#1 の FIR、#4 のノッチ、#5 のカルマンの 5 本の式を読んだ方を想定しています。ステップ n、サンプリング周期 T、伝達関数 H(z) は連載の記法のままです。適応フィルタの標準の記法に合わせるので、次の文字は #5〜#7 と意味が違います。
- w:この記事では FIR の係数ベクトル。#5〜#7 のプロセスノイズではない
- R:この記事では太字で入力の相関行列。#5 の測定ノイズ分散ではない
- p:この記事では太字で相互相関ベクトル。#6 の位置ではない
- λ:この記事では RLS の忘却係数。#6、#7 の λ とは別物
- δ:この記事では RLS の初期化の定数。#7 のデルタ関数ではない
- M:この記事ではタップ数(係数の個数)。#7 の粒子の数 N とも #5 の測定の数とも別物
- y:この記事ではフィルタの出力。#5 の測定に当たるのは目標信号 d
- ν:この記事では R の固有値。#6 のイノベーションではない
- ζ:この記事ではラグランジュの未定乗数。#7 の Liu と West の調整の数ではない
- ε:この記事では NLMS の正則化。#7 の標準正規乱数ではない
- κ:この記事ではガウス入力の解析に出る和。#6 の UKF の κ ではない
- η:この記事では FxLMS の係数をまとめた複素数の包絡線。#7 のラオ・ブラックウェル化の乱数ではない
- h:この記事では設計例 2 の未知の経路のインパルス応答。#6、#7 の観測関数ではない
Q はノッチの鋭さを指します。カルマンの共分散の Q はカルマンとの対応の節にだけ出るので、その場で断ります。入力の PSD は #1 の記法で S_x(\omega) 、能動騒音制御の 2 次経路は #1 の H(z)、h[n] の流儀で H_s(z) 、 h_s[n] と書きます。逆行列の補題の一般の行列は太字の B です。
🧭 適応フィルタとは
適応フィルタは、目標の信号に近づくように、自分の係数をサンプルごとに更新するフィルタです。定義を 1 文で書きます。
出力 y と目標信号 d の誤差 e = d − y の 2 乗平均が小さくなるように、係数 w を毎サンプル更新する FIR フィルタ。係数の更新の規則が LMS、NLMS、RLS の違いになる。
語をほどきます。
- FIR フィルタ:入力の直近 M サンプルに係数を掛けて足すフィルタ(#1)。過去の出力を戻さないので、係数がどんな値でもフィルタ自身は不安定にならない。発散が起きるとすれば、係数の更新のほう
- タップ:FIR の係数 1 個とそれに掛かる遅延の 1 段。M タップは係数が M 個あるという意味
- 目標信号 d:「出力がこうなってほしい」という信号。希望応答とも呼ぶ
- 誤差 e:目標と出力の差。適応フィルタが学習に使う唯一の手がかり
- 参照信号:消したいものと相関があり、消したい当の信号とは別に手に入る信号。入力 x として使う
- ステップサイズ μ:1 回の更新でどれだけ係数を動かすかの大きさ
フィルタの形は FIR のままです。#1 の式と違うのは、係数が定数ではなく時間で変わることだけです。入力の直近 M サンプルを縦に並べたベクトルと、係数のベクトルを次のように書きます。
\mathbf{x}[n] = \begin{bmatrix} x[n] \\ x[n-1] \\ \vdots \\ x[n-M+1] \end{bmatrix} \mathbf{w}[n] = \begin{bmatrix} w_0[n] \\ w_1[n] \\ \vdots \\ w_{M-1}[n] \end{bmatrix}出力と誤差はこうなります。
\begin{aligned} y[n] &= \mathbf{w}[n]^{\mathsf{T}}\mathbf{x}[n] \\ &= \sum_{k=0}^{M-1} w_k[n]\,x[n-k] \\ e[n] &= d[n] - y[n] \end{aligned}T の肩文字は転置(縦と横を入れ替える操作)で、 \mathbf{w}^{\mathsf{T}}\mathbf{x} は対応する要素を掛けて足した内積です。サンプリング周期の T とは別の、立体の T です。太字はベクトルや行列、細字はただの数を表します。
何を渡すと何が返るのか
#1 の固定 FIR との差を並べます。
| 区分 | 固定 FIR | 適応フィルタ |
|---|---|---|
| 入力 | x | x と目標信号 d |
| 設計するもの | 係数そのもの | タップ数と更新の規則 |
| 出力 | y | y と誤差 e と係数 w |
| 係数 | 定数 | サンプルごとに変わる |
| 時間で見た性質 | 線形時不変 | 線形でも時不変でもない |
目標信号 d が要ることと、係数が出力になることが大きな違いです。経路を調べたいなら学習後の係数が答えですし、妨害を消したいなら誤差 e が答えです。どの信号を「出力」として使うかは、次の 4 つの構成で変わります。
カルマンフィルタとの違いも見ておきます。#5 は状態方程式と Q、R を与えて状態を推定しました。適応フィルタは対象の式を持ちません。FIR で表せる関係があることだけを仮定し、その係数をデータから求めます。
4 つの構成
適応フィルタの使い方は、Widrow の分類で 4 つに整理されます。同じ LMS でも、何を x にして何を d にするかで役割が変わります。 次の図の赤い線が誤差で、適応フィルタの係数を動かします。
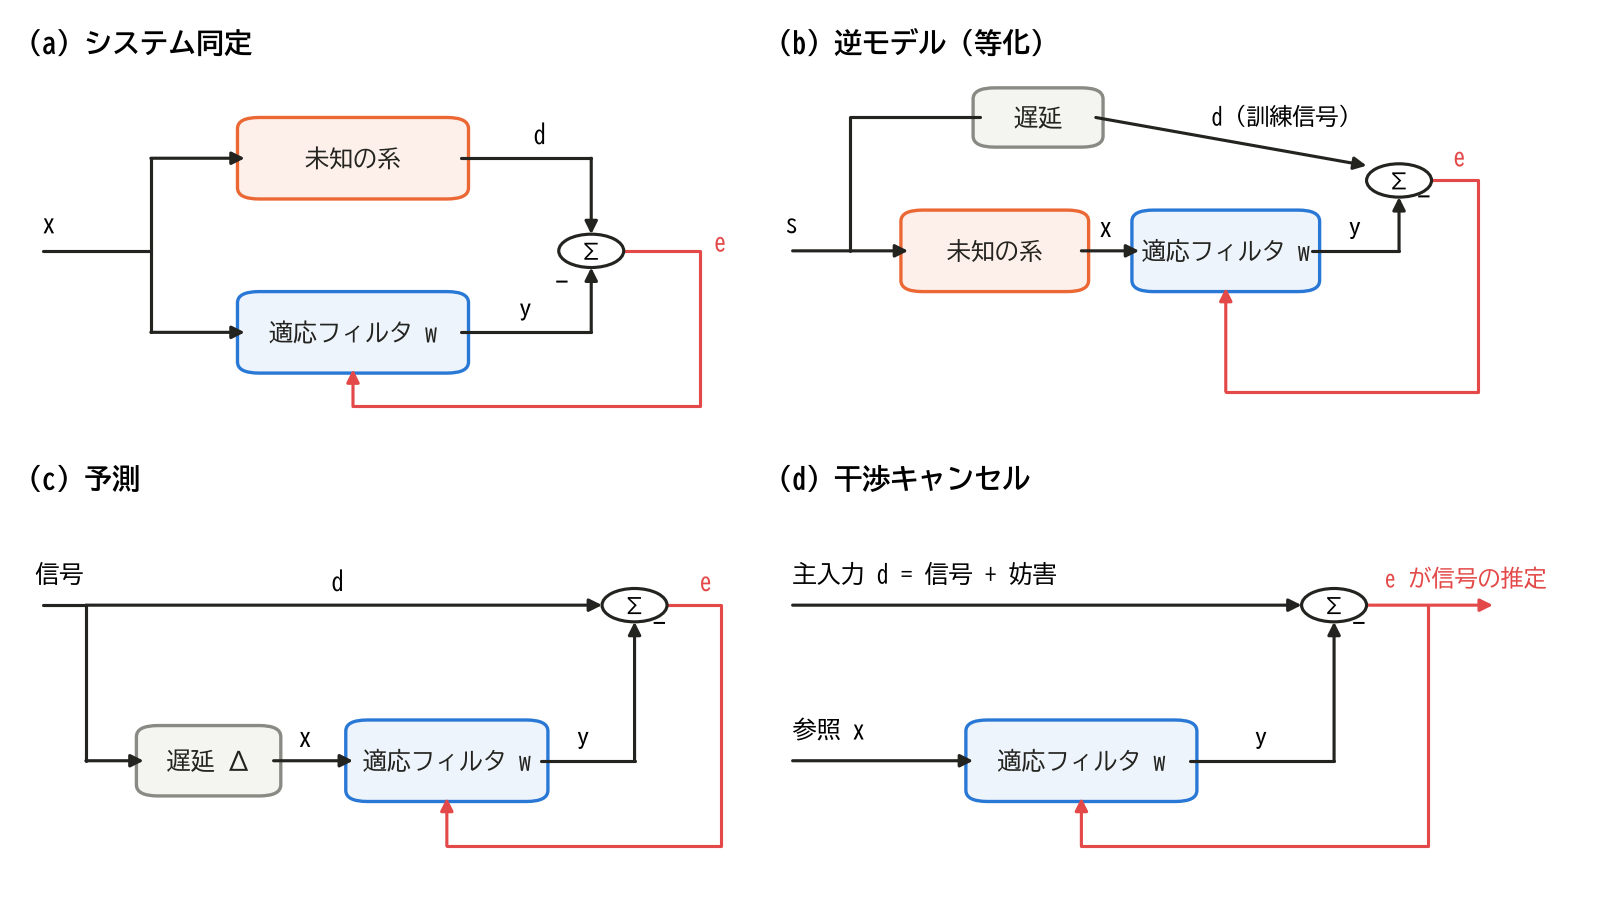
(a) 未知の系をまねる。(b) 未知の系を打ち消す。(c) 過去から現在を当てる。(d) 妨害だけを引き算する
4 つの構成は、次のように読みます。
| 構成 | x | d | 使う出力 |
|---|---|---|---|
| (a) システム同定 | 未知の系の入力 | 未知の系の出力 | 係数 w、または y |
| (b) 逆モデル(等化) | 未知の系の出力 | 遅延した元の信号 | y |
| (c) 予測 | 遅延した信号 | 現在の信号 | y または e |
| (d) 干渉キャンセル | 参照信号 | 信号+妨害 | e |
(a) は、同じ入力を未知の系と適応フィルタへ通し、出力が一致するように学習します。一致すれば、係数が未知の系のインパルス応答(#1 で見た、入力が 1 サンプルだけのときの応答)に近づきます。(b) は通信路のゆがみを打ち消す等化器の形です。等化は、伝送路で崩れた波形を元に戻す処理です。(c) は、入力を遅らせて、過去の値から現在の値を当てさせます。当てられる部分は周期的な成分で、当てられない部分がノイズです。(d) は、妨害と相関のある参照 x から妨害だけを作って引きます。信号は x と無相関なので引かれず、誤差 e に残ります。誤差が答えになる、少し不思議な構成です。
名前の由来
LMS(Least Mean Squares、最小 2 乗平均)は、Widrow と Hoff が 1959 年に考案し、1960 年の論文「Adaptive Switching Circuits」で発表した更新則です。論文の題が示すとおり、もとはパターン認識の回路の話で、入力に重みを掛けて足す素子に例を見せて学習させるものでした。この素子は Adaline(adaptive linear threshold logic element)と呼ばれています。今のニューラルネットの勾配学習の、ごく早い例です。
適応ノイズキャンセルは、Widrow らの 1975 年の Proc. IEEE の論文で体系化されました。そこには 60 Hz のハムの除去、胎児の心電図の分離、正弦波を参照にした適応ノッチ、適応線スペクトル強調器の原型まで、この記事の題材の多くが並んでいます。
NLMS(Normalized LMS、正規化 LMS)は、入力の電力で割る形で、Nagumo と Noda の 1967 年の論文「A learning method for system identification」に帰されるのが通例です。
RLS(Recursive Least Squares、再帰的最小 2 乗)の土台の最小 2 乗法は、Gauss が 1809 年の『天体運動論』で論じた古い方法です。データが増えるたびに解を更新する逐次形は、Plackett の 1950 年の論文で扱われています。
前提
適応フィルタがうまく働くのは、次の条件がそろうときです。
- 目標信号が手に入る:d が無ければ誤差を計算できない。訓練の間だけ d を用意する使い方もある
- 参照と目標に相関がある:干渉キャンセルなら、参照は妨害と相関があり、信号とは無相関
- FIR で表せる長さ:未知の系のインパルス応答が M タップの内に収まる
- ゆっくりしか変わらない:対象の変化が学習の速さより遅い
- 入力が十分に豊か:係数を区別できるだけの周波数成分が入力にある(持続的励振と呼ぶ)
3 が破れると、はみ出した分は誤差に残ります。4 が破れると、追いつけません。5 が破れた場合の話は、設計例 2 と落とし穴で見ます。
🥣 最小 2 乗とウィーナー解
LMS を導くために、まず「理想の係数」を求めます。統計がすべて分かっているなら、最も良い固定の係数は式で解けます。それがウィーナー解で、適応フィルタが目指す的です。
2 乗平均誤差
係数 w を固定して、誤差の 2 乗の平均を計算します。E[ ] は期待値(平均)です。 e = d - \mathbf{w}^{\mathsf{T}}\mathbf{x} を 2 乗します。
e^2 = d^2 - 2d\,\mathbf{w}^{\mathsf{T}}\mathbf{x} + \mathbf{w}^{\mathsf{T}}\mathbf{x}\,\mathbf{x}^{\mathsf{T}}\mathbf{w}最後の項は、 (\mathbf{w}^{\mathsf{T}}\mathbf{x})^2 を (\mathbf{w}^{\mathsf{T}}\mathbf{x})(\mathbf{x}^{\mathsf{T}}\mathbf{w}) と書き直したものです。期待値を取ると w は定数なので外へ出ます。
J(\mathbf{w}) = E[e^2] = \sigma_d^2 - 2\,\mathbf{w}^{\mathsf{T}}\mathbf{p} + \mathbf{w}^{\mathsf{T}}\mathbf{R}\,\mathbf{w} \mathbf{R} = E[\mathbf{x}\,\mathbf{x}^{\mathsf{T}}],\quad \mathbf{p} = E[\mathbf{x}\,d]記号を整理します。
| 記号 | 大きさ | 意味 |
|---|---|---|
| \mathbf{x} | M × 1 | 入力の直近 M サンプル |
| \mathbf{w} | M × 1 | FIR の係数 |
| d、e | 数 | 目標信号、誤差 |
| \sigma_d^2 | 数 | 目標信号の電力 E[d^2] |
| \mathbf{R} | M × M | 入力の相関行列 |
| \mathbf{p} | M × 1 | 入力と目標の相互相関ベクトル |
| J | 数 | 2 乗平均誤差 |
相関行列 R は、入力のどの 2 サンプルがどれだけ一緒に動くかを並べた行列です。定常な入力(統計が時間で変わらない入力)なら、i 行 j 列の値は間の距離 |i − j| だけで決まります。対角は入力の電力 P_x = E[x^2] です。相互相関ベクトル p は、入力の各サンプルが目標とどれだけ一緒に動くかです。
正規方程式とウィーナー解
J を w で微分して 0 と置きます。ベクトルでの微分は、各要素で偏微分して並べたものです。 \mathbf{w}^{\mathsf{T}}\mathbf{p} の微分は p、 \mathbf{w}^{\mathsf{T}}\mathbf{R}\mathbf{w} の微分は R が対称なので 2\mathbf{R}\mathbf{w} です。
\nabla J(\mathbf{w}) = -2\mathbf{p} + 2\mathbf{R}\,\mathbf{w}\nabla は勾配で、J が最も急に増える向きを指すベクトルです。これを 0 にする条件が正規方程式です。ウィーナー・ホップ方程式とも呼びます。
\mathbf{R}\,\mathbf{w}_o = \mathbf{p}R に逆行列があれば、最適な係数は次の式で決まります。これがウィーナー解です。
\mathbf{w}_o = \mathbf{R}^{-1}\mathbf{p},\quad J_{\min} = \sigma_d^2 - \mathbf{p}^{\mathsf{T}}\mathbf{w}_oJ_{\min} は、どんな固定の M タップ FIR を使っても残る誤差です。システム同定なら d に乗った観測ノイズ、干渉キャンセルなら本来の信号がこれに当たります。
式の読み方を 1 つ。 \mathbf{p} は「目標と入力の関係」、 \mathbf{R}^{-1} は「入力のサンプル同士の絡みをほどく操作」です。入力が白色(サンプル同士が無相関)なら R は P_x\mathbf{I} で、 \mathbf{w}_o = \mathbf{p}/P_x になります。相互相関を電力で割っただけです。I は単位行列(対角が 1 で他が 0 の行列)です。
ウィーナー解は計算できる式ですが、実際には R と p が分かりません。分かっていても、変化する対象では計算し直し続けることになります。そこで、解を直接計算せず、データを見ながら少しずつ w を動かして底へ下りる方法を考えます。
J は w の 2 次の碗
J を \mathbf{w}_o の周りで書き直します。 \tilde{\mathbf{w}} = \mathbf{w} - \mathbf{w}_o を代入して正規方程式を使うと、1 次の項が消えて次の形になります。
J(\mathbf{w}) = J_{\min} + \tilde{\mathbf{w}}^{\mathsf{T}}\mathbf{R}\,\tilde{\mathbf{w}}R は相関行列なので、0 でないベクトルで挟んだ値は負になりません。つまり J は w の 2 次関数で、底が 1 つだけの碗の形です。局所解(途中の小さな谷)がありません。次の図は M = 2 の例です。 \mathbf{R} = \begin{bmatrix}1 & 0.7\\0.7 & 1\end{bmatrix} 、 \mathbf{w}_o = [0.6,\ 0.2]^{\mathsf{T}} 、 J_{\min} = 0.05 としました。
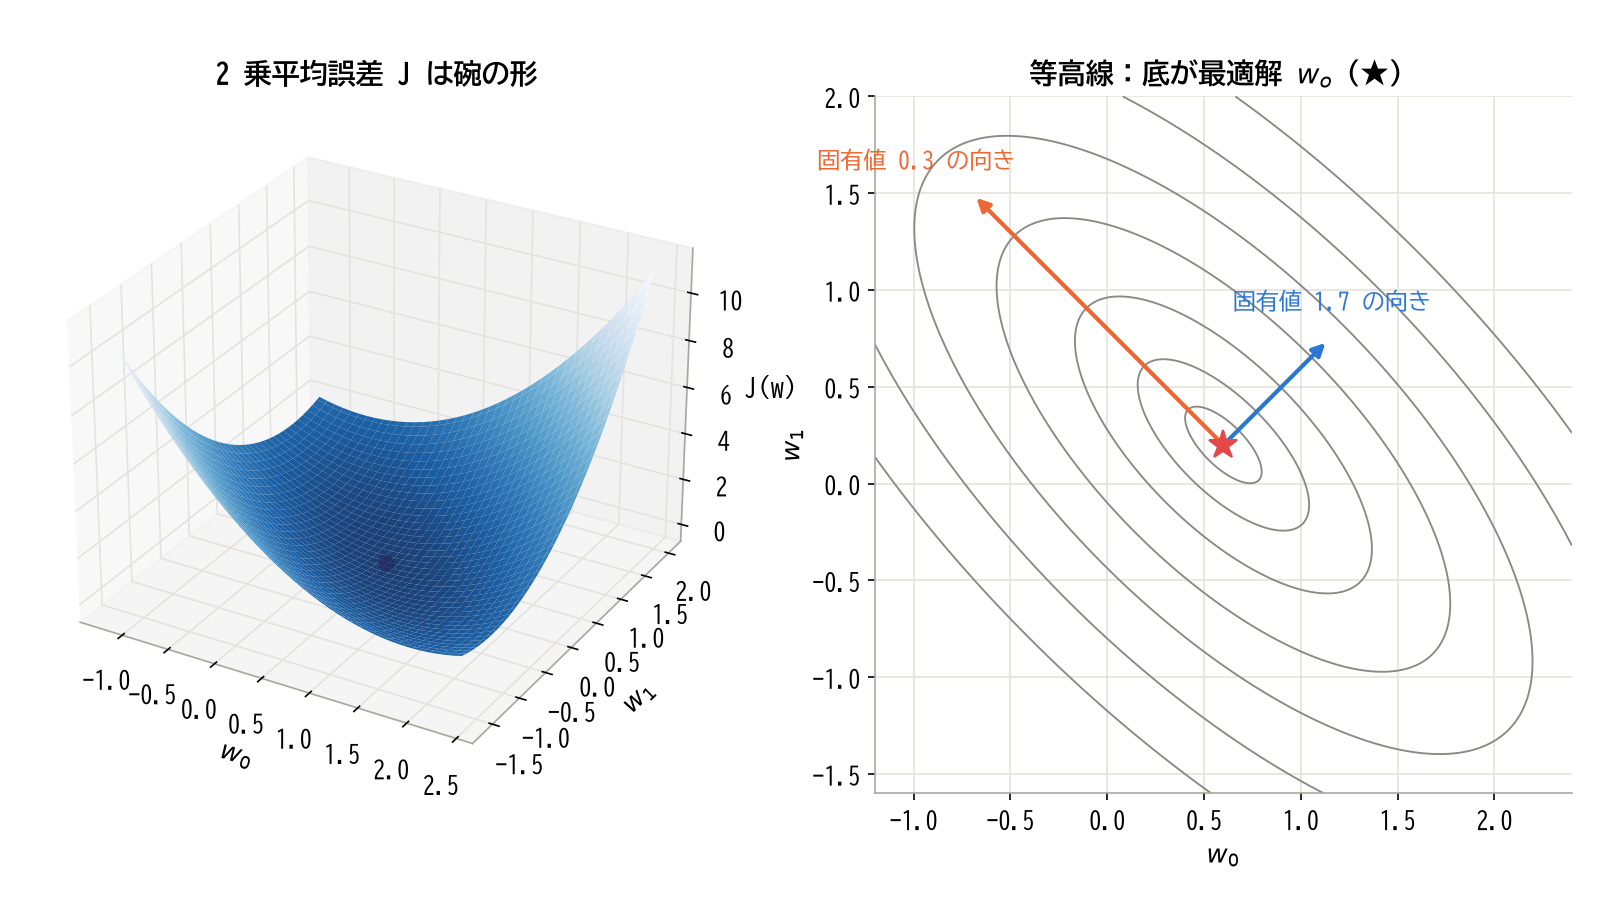
右の等高線は楕円。短軸の向きは急で(固有値 1.7)、長軸の向きはゆるい(固有値 0.3)。★ がウィーナー解
右の図の楕円の形を読みます。固有ベクトルは、行列を掛けても向きが変わらない特別な向きで、固有値はそのときの伸び率です。R の固有値を \nu_i (i = 1〜M)と書きます。この記事の λ は忘却係数に使うので、固有値には ν を使います。#6 のイノベーション ν とは別物です。固有値が大きい向きは碗の壁が急で、小さい向きはゆるい坂です。この例の固有値は 1.7 と 0.3 で、等高線の楕円の軸の比は \sqrt{1.7/0.3} \approx 2.4 です。
固有値の最大と最小の比を固有値の広がりと呼び、χ と書きます。
\chi = \frac{\nu_{\max}}{\nu_{\min}}χ = 1 なら等高線は円、χ が大きいほど細長い楕円です。これが、次の小節で収束の速さを決めます。
最急降下法と収束の定理
最急降下法は、今いる場所の勾配の逆向きへ少しずつ下りる方法です。R と p が分かっているとして、勾配 \nabla J = -2(\mathbf{p} - \mathbf{R}\mathbf{w}) の逆向きへ、 \mu/2 倍だけ進みます。
\mathbf{w}[n+1] = \mathbf{w}[n] + \mu\left(\mathbf{p} - \mathbf{R}\,\mathbf{w}[n]\right)\mathbf{p} = \mathbf{R}\mathbf{w}_o を入れて、最適解からのずれ \tilde{\mathbf{w}} の式にします。
\tilde{\mathbf{w}}[n+1] = (\mathbf{I} - \mu\mathbf{R})\,\tilde{\mathbf{w}}[n]ベクトルの式なので、R の固有ベクトルの向きへ分解します。その向きの成分を c_i とすると、R は \nu_i 倍になるだけなので、M 本の独立な 1 次の式に分かれます。
\begin{aligned} c_i[n+1] &= (1 - \mu\nu_i)\,c_i[n] \\ c_i[n] &= (1 - \mu\nu_i)^n\,c_i[0] \end{aligned}各向きは、公比 1 - \mu\nu_i の等比数列です。 |1 - \mu\nu_i| < 1 がすべての i で成り立てば 0 に収束します。
0 < \mu < 2/\nu_{\max} のとき、かつそのときに限り、すべての初期値で w[n] はウィーナー解へ収束する。μ が小さいとき、係数の向き i の時定数は 1/(\mu\nu_i) サンプル、誤差の電力の時定数はその半分の 1/(2\mu\nu_i) サンプルである。
時定数の式は、 (1-\mu\nu_i)^n \approx e^{-\mu\nu_i n} から来ます。J はずれの 2 乗で決まるので、指数が 2 倍になって時定数は半分です。
上限は最大の固有値で決まり、遅さは最小の固有値で決まります。 μ は 2/\nu_{\max} より小さくしなければならないので、 \mu = 1/\nu_{\max} のように取ると、最も遅い向きの時定数は誤差の電力で \chi/2 サンプルです。固有値の広がりがそのまま収束の遅さになります。 次の図で、白色の入力(χ = 1)と有色の入力(χ = 100)を比べます。有色は、白色と違って周波数ごとの電力に偏りがあることを指します。μ はどちらも 0.9/\nu_{\max} です。
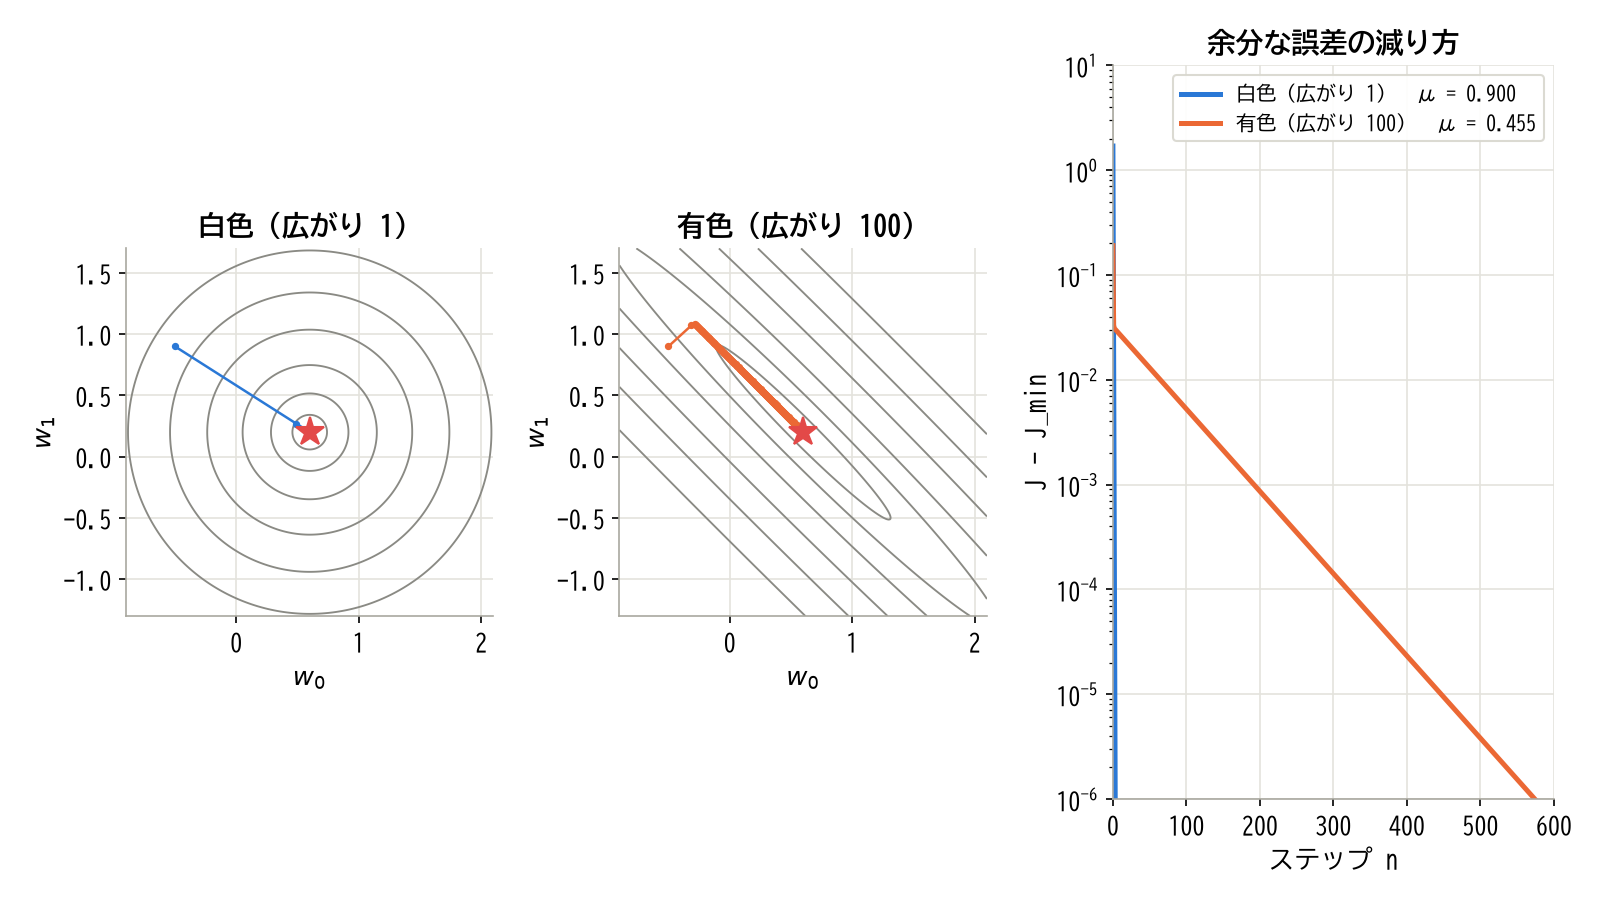
左の白色は 1 歩で底のそばへ着く。中央の有色は谷へ落ちたあと、ゆるい坂を長い時間かけて進む。右で傾きの差を見る
中央の図の経路に注目してください。急な向きは 1 歩で片付き、ゆるい向きの成分が残ります。χ = 100 の例では \nu_{\min} = 0.0198 、μ = 0.4545 で、誤差の電力の時定数は 55.6 サンプルです。余分な誤差が 1000 分の 1 になるまでに、白色は 2 ステップ、有色は 284 ステップかかりました。
破る例も確かめます。同じ有色の入力で \mu = 2.05/\nu_{\max} にすると、公比は −1.05 で、余分な誤差は 60 ステップで 0.19 から 55 まで増えました。定理の上限の外です。
固有値の広がりはスペクトルの山谷の比
固有値の広がりは行列の話に見えますが、周波数で読み替えられます。定常な入力の R は、対角に沿って同じ値が並ぶ Toeplitz 行列です。Grenander と Szegő の『Toeplitz Forms and Their Applications』の結果によると、R の固有値は、入力の PSD(#1 で見た、周波数ごとの電力)の最小値と最大値の間に入ります。M が大きくなると、固有値の最大と最小はその両端に近づきます。
\min_{\omega} S_x(\omega) \le \nu_i \le \max_{\omega} S_x(\omega) \chi \le \frac{\max_{\omega} S_x(\omega)}{\min_{\omega} S_x(\omega)}S_x(\omega) は入力の PSD、ω は 1 サンプルあたりの角周波数です。固有値の広がりは、入力のスペクトルの山と谷の比です。 白色ノイズはスペクトルが平らなので χ = 1 です。低い周波数に電力が集まった信号や、数本の線スペクトルしかない信号は χ が大きくなります。実際の信号の多くは有色です。音声や、ゆっくり変わるセンサの値、PWM の指令は、どれもスペクトルに大きな山谷があります。
🧮 LMS の導出
最急降下法には R と p が要りました。これらは期待値なので手元にありません。LMS は、この期待値を今の 1 サンプルの値で置き換えるという、大胆な近似です。
期待値を瞬時値で置き換える
勾配は \nabla J = -2(\mathbf{p} - \mathbf{R}\mathbf{w}) = -2E[\mathbf{x}\,e] と書けます。 e = d - \mathbf{x}^{\mathsf{T}}\mathbf{w} なので、 E[\mathbf{x}e] = \mathbf{p} - \mathbf{R}\mathbf{w} だからです。ここの期待値を外し、今の値 \mathbf{x}[n]\,e[n] を使います。
\mathbf{w}[n+1] = \mathbf{w}[n] + \mu,e[n],\mathbf{x}[n]
これで全部です。y を計算し、e を計算し、 \mu e\,\mathbf{x} を足す。M タップなら 1 サンプルあたり積和が 2M 回で、行列の計算はありません。
| 記号 | 意味 |
|---|---|
| \mathbf{w}[n] | 時刻 n の係数 |
| \mathbf{x}[n] | 入力の直近 M サンプル |
| e[n] | 今の誤差 d[n] - \mathbf{w}[n]^{\mathsf{T}}\mathbf{x}[n] |
| μ | ステップサイズ |
確率的勾配とは、このように 1 サンプルで見積もった勾配のことです。向きは毎回ばらつきますが、平均すると本当の勾配の向きです。
意味も素直です。誤差が正なら出力が足りないので、入力と同じ符号の向きへ係数を動かして出力を増やします。誤差が 0 に近づくと更新も止まります。ただし、d にノイズがある限り誤差は 0 にならないので、係数はウィーナー解の周りで揺れ続けます。
文献を読むときの注意が 1 つあります。Widrow の論文は更新を \mathbf{w} + 2\mu e\,\mathbf{x} と書きます。この記事の μ は、Widrow の μ の 2 倍です。CMSIS-DSP など実装の多くは、この記事と同じ 2 が付かない形です。
平均の収束
更新式から、係数の平均がどう動くかを求めます。解析を簡単にするために、独立性の仮定を置きます。係数 w[n] は過去のデータで決まるので、今の入力 x[n] とは独立だ、と見なす仮定です。厳密には成り立ちませんが、μ が小さいほどよい近似です。
目標を d = \mathbf{w}_o^{\mathsf{T}}\mathbf{x} + v と書きます。v は x と無相関の、平均 0 で電力 J_{\min} の成分です。 e = v - \mathbf{x}^{\mathsf{T}}\tilde{\mathbf{w}} を更新式へ入れて、期待値を取ります。
E[\tilde{\mathbf{w}}[n+1]] = (\mathbf{I} - \mu\mathbf{R})\,E[\tilde{\mathbf{w}}[n]]最急降下法と同じ式です。LMS の係数の平均は最急降下法の経路をたどります。 平均が収束する条件も同じ 0 < \mu < 2/\nu_{\max} で、固有値の広がりで遅くなるのも同じです。
μ の目安と本当の上限
固有値を計算しなくて済むように、目安を作ります。固有値の和は R の対角の和(トレース)に等しいので、 \sum_i\nu_i = \mathrm{tr}\,\mathbf{R} = MP_x です。固有値は負でないので \nu_{\max} \le MP_x が成り立ち、次の目安が得られます。
0 < \mu < \frac{2}{MP_x}これは手元で測れる入力の電力だけで書けるので便利です。ただし、これは平均が発散しない条件で、誤差の 2 乗が有限にとどまる条件ではありません。 2 乗の条件はもっと厳しくなります。
入力が白色のガウス分布(ベル形の分布)なら、4 次のモーメント(値の 4 乗の平均)を 2 次に分解して解析できます(Horowitz と Senne、Feuer と Weinstein の解析)。独立性の仮定のもとで計算すると、定常の誤差は次の κ を使って書けます。
\frac{J - J_{\min}}{J_{\min}} = \frac{\kappa}{1-\kappa} \kappa = \sum_{i=1}^{M}\frac{\mu\nu_i}{2 - 2\mu\nu_i}κ < 1 が有限にとどまる条件です。白色なら \nu_i = P_x で、次の上限になります。
0 < \mu < \frac{2}{(M+2)\,P_x}M = 8、 P_x = 1 なら、目安の 0.25 に対して上限は 0.2 です。M = 2 なら 1 に対して 0.5 で、差はもっと大きくなります。計算で確かめた結果が次の図です。
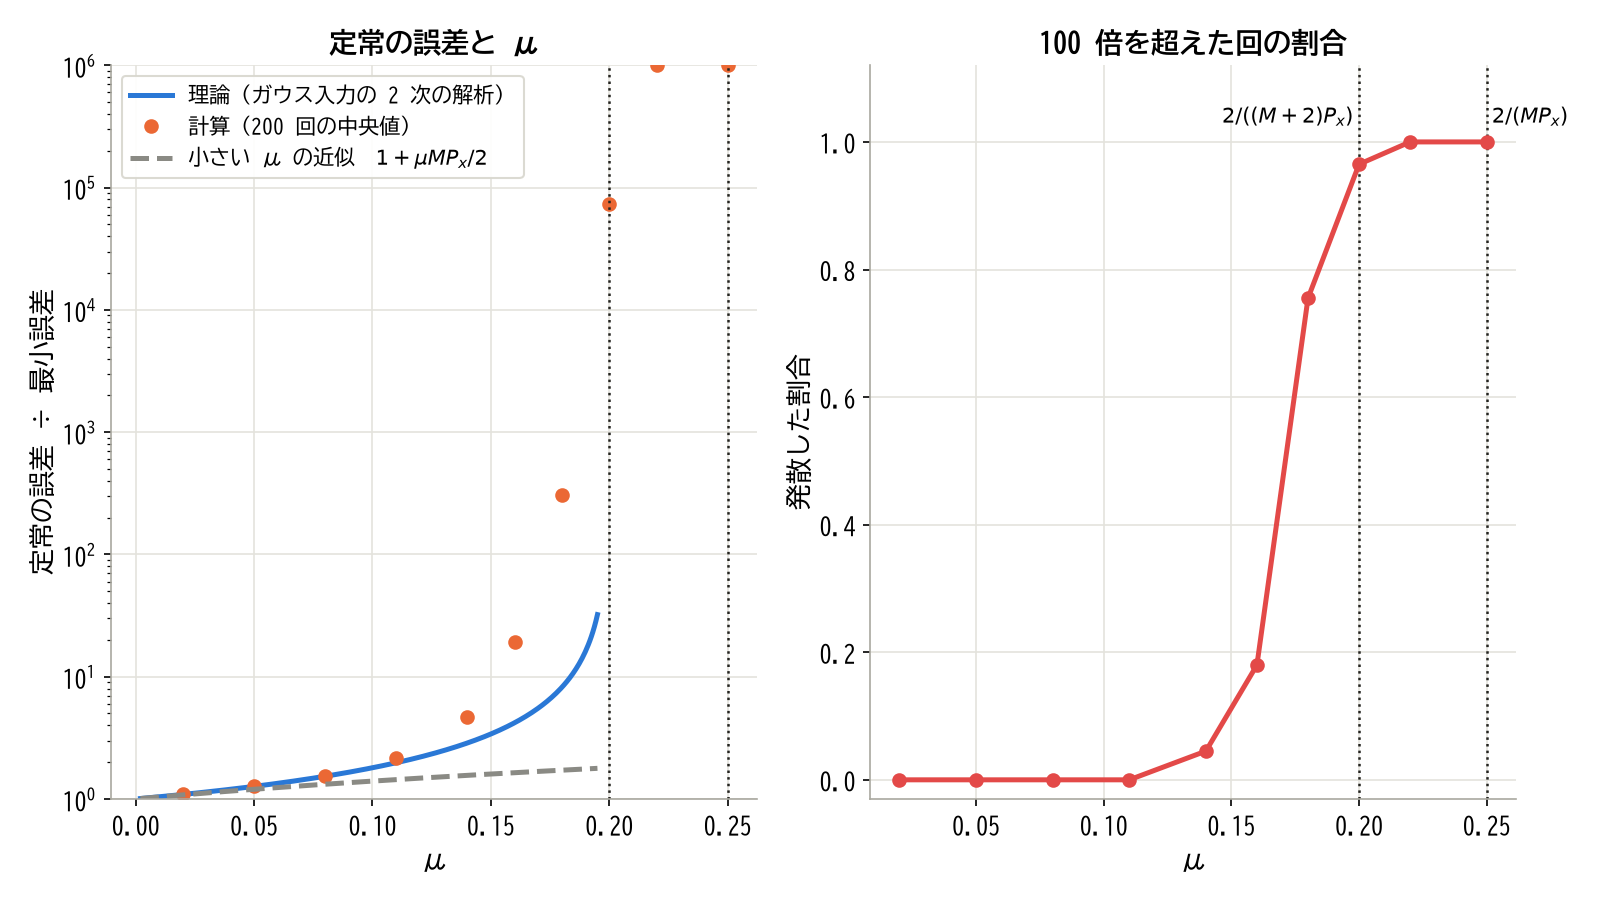
M = 8 の白色ガウス入力。左の点が 200 回の中央値、右が誤差が 100 倍を超えた回の割合。目安 2/(MP_x) の手前で、ほぼすべての回が発散する
μ = 0.11 までは理論と計算が合います。0.14 を超えると、中央値が理論より先に上がり始めます。μ = 0.14 で 200 回のうち 4.5 %、0.18 で 76 %、0.2 で 97 % の回が発散しました。独立性の仮定が崩れることと、ときどき大きな入力が来て 1 回の更新で跳ねることが効いています。目安の 2/(MP_x) は「ここまで使える」線ではなく、「ここより先は必ず危ない」線です。 実用では、この 1/10〜1/5 くらいから始めます。
誤調整:速さと精度の交換
LMS の係数は底で止まらず揺れ続けるので、定常の誤差は J_{\min} より少し大きくなります。この増えた割合を誤調整(misadjustment)と呼び、 \mathcal{M} と書きます。
\mathcal{M} = \frac{J_{\infty} - J_{\min}}{J_{\min}}J_\infty は定常の誤差の電力です。導出は係数のずれの大きさの収支で書けます。更新式の両辺の長さの 2 乗を取ります。
\begin{aligned} \|\tilde{\mathbf{w}}[n+1]\|^2 &= \|\tilde{\mathbf{w}}[n]\|^2 \\ &\quad + 2\mu\,e\,\mathbf{x}^{\mathsf{T}}\tilde{\mathbf{w}}[n] \\ &\quad + \mu^2 e^2\|\mathbf{x}\|^2 \end{aligned}\|\mathbf{x}\|^2 = \mathbf{x}^{\mathsf{T}}\mathbf{x} はベクトルの長さの 2 乗です。定常では左辺と右辺の平均が釣り合うので、残り 2 項の平均の和が 0 になります。第 2 項は e = v - \mathbf{x}^{\mathsf{T}}\tilde{\mathbf{w}} と v の無相関から -2\mu J_{\text{ex}} になります。 J_{\text{ex}} = J_\infty - J_{\min} が余分な誤差です。第 3 項は e と x がほぼ独立として \mu^2 J_\infty MP_x です。
2\mu J_{\text{ex}} = \mu^2 (J_{\min} + J_{\text{ex}})\,MP_xμ が小さければ右辺の J_{\text{ex}} は無視できて、次の式になります。
\mathcal{M} \approx \frac{\mu MP_x}{2}Widrow らの 1976 年の論文の結果(Widrow の μ で \mu\,\mathrm{tr}\,\mathbf{R} )と同じです。
μ を大きくすると速くなりますが、定常の誤差が増えます。 時定数は μ に反比例し、誤調整は μ に比例します。掛け算すると μ が消えます。白色の入力では、誤差の電力の時定数を \tau = 1/(2\mu P_x) として、次の関係になります。
\mathcal{M}\,\tau \approx \frac{M}{4}速さと精度の積はタップ数だけで決まり、μ では動かせません。 次の図は、M = 8、 P_x = 1 、観測ノイズの電力 0.01 の同定で μ を 3 通りに振ったものです。
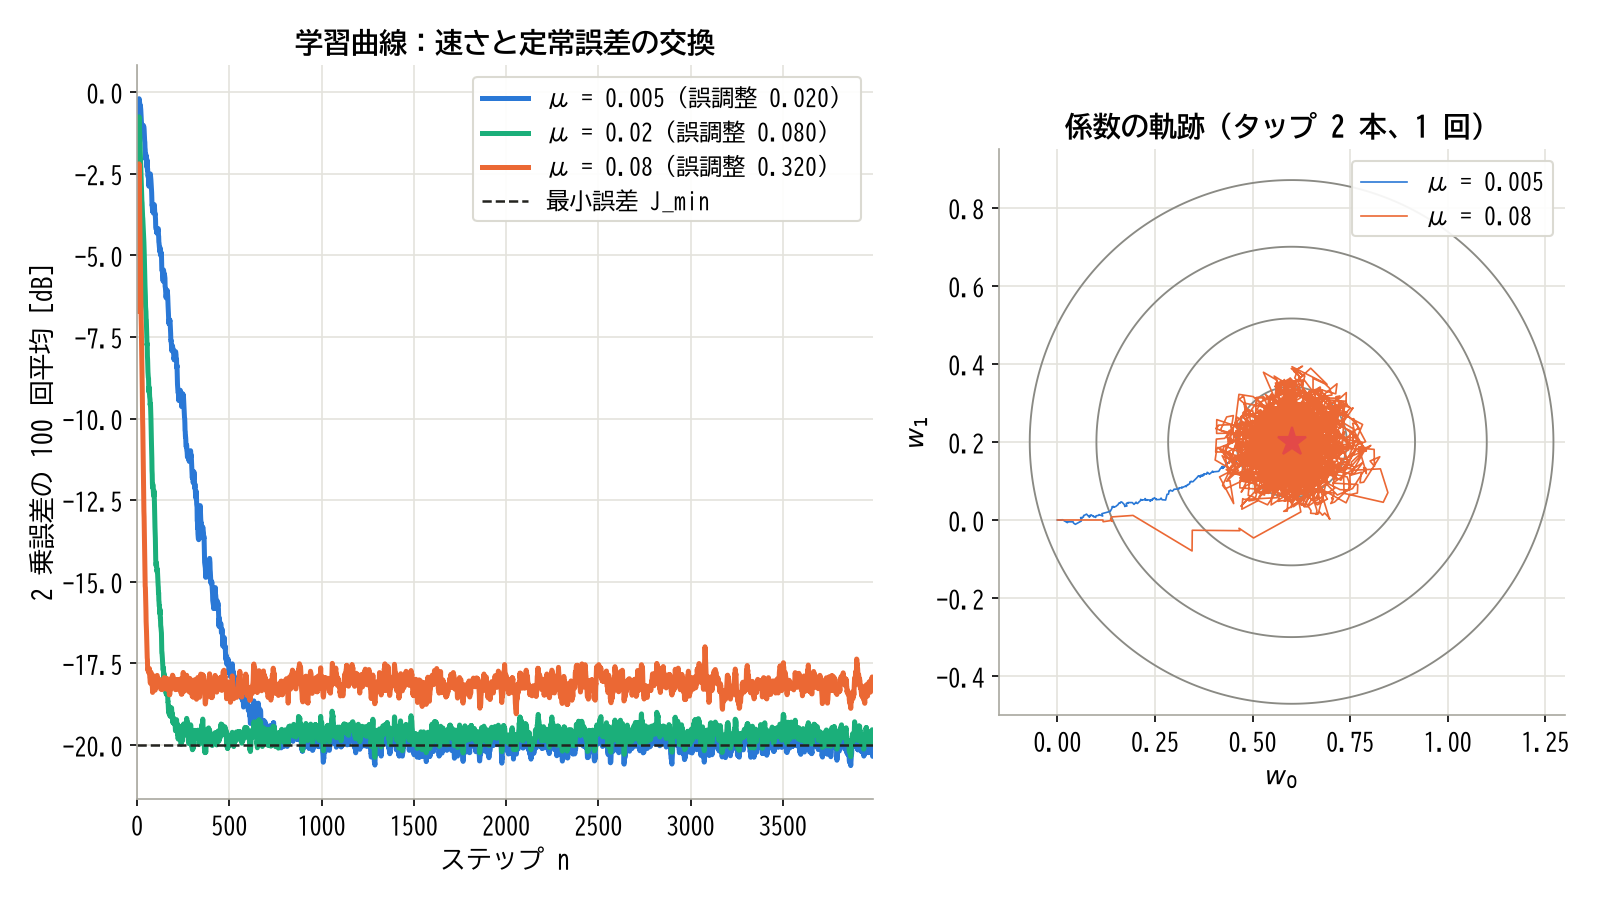
左:μ を大きくすると速いが、落ち着く高さが上がる。右:μ = 0.08 の係数は最適解の周りで大きく揺れ続ける(別の条件のタップ 2 本の例)
左の曲線は、乱数の違う 100 回の 2 乗誤差を平均したもので、学習曲線と呼びます。1 回だけだとばらつきが大きいので、平均で見ます。μ を変えた結果を、理論と並べます。
| μ | 小さい μ の式 | ガウスの式 | 計算 |
|---|---|---|---|
| 0.005 | 0.020 | 0.021 | 0.018 |
| 0.02 | 0.080 | 0.089 | 0.085 |
| 0.08 | 0.320 | 0.533 | 0.545 |
3 dB 以内に入るまでのステップ数は、順に 472、132、48 でした。μ = 0.08 は上限 0.2 の 4 割で、小さい μ の式はもう合いません。ガウスの式の \kappa/(1-\kappa) なら合います。
手計算で 3 ステップ回す
数字で 1 度たどります。M = 2、μ = 0.1、係数の初期値は 0 とします。未知の系を \mathbf{w}_o = [0.6,\ 0.2]^{\mathsf{T}} として、ノイズなしの d を作ります。
| n | x[n] | d[n] |
|---|---|---|
| 0 | 1 | 0.6 |
| 1 | 0.5 | 0.5 |
| 2 | −0.5 | −0.2 |
n より前の x は 0 です。d は 0.6\,x[n] + 0.2\,x[n-1] で計算しました。
n = 0。 \mathbf{x}[0] = [1,\ 0]^{\mathsf{T}} 、y = 0、e = 0.6 です。
\begin{aligned} \mathbf{w}[1] &= \begin{bmatrix}0\\0\end{bmatrix} + 0.1\times 0.6\begin{bmatrix}1\\0\end{bmatrix} \\ &= \begin{bmatrix}0.06\\0\end{bmatrix} \end{aligned}n = 1。 \mathbf{x}[1] = [0.5,\ 1]^{\mathsf{T}} 、y = 0.06 × 0.5 = 0.03、e = 0.5 − 0.03 = 0.47 です。
\begin{aligned} \mathbf{w}[2] &= \begin{bmatrix}0.06\\0\end{bmatrix} + 0.047\begin{bmatrix}0.5\\1\end{bmatrix} \\ &= \begin{bmatrix}0.0835\\0.047\end{bmatrix} \end{aligned}n = 2。 \mathbf{x}[2] = [-0.5,\ 0.5]^{\mathsf{T}} 、y = −0.04175 + 0.0235 = −0.01825、e = −0.2 + 0.01825 = −0.18175 です。
\begin{aligned} \mathbf{w}[3] &= \begin{bmatrix}0.0835\\0.047\end{bmatrix} - 0.018175\begin{bmatrix}-0.5\\0.5\end{bmatrix} \\ &= \begin{bmatrix}0.0925875\\0.0379125\end{bmatrix} \end{aligned}n = 2 の更新で w_1 が 0.047 から 0.038 へ、真の 0.2 から遠ざかる向きへ動きました。1 回ごとの向きは正しいとは限りません。平均で正しい向きへ進みます。この値は、実装の章の Python と C の出力と一致します。
ここまでの整理
ここまでをまとめます。LMS は、碗の底へ向かう最急降下法の勾配を 1 サンプルで見積もったものです。平均の経路は最急降下法と同じで、固有値の広がりで遅くなります。上限は 2 乗の条件で決まり、定常では誤調整が残ります。
残る不満は 2 つあります。μ の適切な値が入力の電力で変わることと、有色の入力で遅いことです。1 つ目を直すのが NLMS、2 つ目まで直すのが RLS です。
📏 NLMS の導出
LMS の更新量は入力の大きさに比例します。入力が 10 倍の振幅になると、更新量も 10 倍、誤差も 10 倍で、実質のループのゲインは 100 倍です。μ の上限は入力の電力に反比例しました。入力の大きさが読めない対象では、μ を決められません。
最小ノルムの射影として導く
NLMS は、LMS を手直しするのではなく、次の問いから導けます。
今のデータ 1 組にぴったり合う係数のうち、今の係数からいちばん近いものはどれか。
式で書きます。更新後の係数で計算した誤差を事後誤差と呼びます。それを 0 にするという条件のもとで、係数の変化量の大きさを最小にします。
\min_{\mathbf{w}[n+1]}\ \|\mathbf{w}[n+1] - \mathbf{w}[n]\|^2 \text{条件:}\ d[n] = \mathbf{w}[n+1]^{\mathsf{T}}\mathbf{x}[n]条件つきの最小化なので、ラグランジュの未定乗数 ζ を導入します。これは条件の式に掛ける補助の数で、解くと条件を満たすように決まります。
\begin{aligned} \mathcal{L} &= \|\mathbf{w}[n+1] - \mathbf{w}[n]\|^2 \\ &\quad + \zeta\left(d[n] - \mathbf{w}[n+1]^{\mathsf{T}}\mathbf{x}[n]\right) \end{aligned}\mathbf{w}[n+1] で微分して 0 と置きます。
2\left(\mathbf{w}[n+1] - \mathbf{w}[n]\right) - \zeta\,\mathbf{x}[n] = 0 \mathbf{w}[n+1] = \mathbf{w}[n] + \frac{\zeta}{2}\mathbf{x}[n]変化の向きは x[n] です。これを条件の式へ代入します。
d[n] = \mathbf{w}[n]^{\mathsf{T}}\mathbf{x}[n] + \frac{\zeta}{2}\|\mathbf{x}[n]\|^2 \frac{\zeta}{2} = \frac{e[n]}{\|\mathbf{x}[n]\|^2}ここで e[n] は更新前の誤差です。ζ を戻すと更新式が出ます。幾何で読むと、 d = \mathbf{w}^{\mathsf{T}}\mathbf{x} を満たす w の集合は x に垂直な平面で、今の w からその平面へ垂線を下ろした足が更新後の w です。これを射影と呼びます。
1 回で平面まで飛ぶと、ノイズまで全部取り込むので、 \tilde{\mu} を掛けて手前で止めます。ゼロ割りを避ける小さな数 ε も足します。
\mathbf{w}[n+1] = \mathbf{w}[n] + \dfrac{\tilde{\mu}}{\varepsilon + |\mathbf{x}[n]|^2},e[n],\mathbf{x}[n]
| 記号 | 意味 |
|---|---|
| \tilde{\mu} | 正規化ステップサイズ。0 より大きく 2 より小さい |
| ε | 正則化。入力が 0 のときに割り算が壊れないための小さな正の数 |
| \lVert\mathbf{x}[n]\rVert^2 | 直近 M サンプルの電力の和 |
\tilde{\mu} = 1 、ε = 0 なら、更新のあとの事後誤差はちょうど 0 です。一般には (1-\tilde{\mu})\,e[n] になります。LMS の μ が、サンプルごとに \tilde{\mu}/\|\mathbf{x}\|^2 に置き換わった形です。 \|\mathbf{x}\|^2 \approx MP_x なので、LMS の \mu = \tilde{\mu}/(MP_x) に対応します。
安定条件が入力の電力に依らない
ノイズがない場合に、ずれの長さを計算します。 e = -\mathbf{x}^{\mathsf{T}}\tilde{\mathbf{w}} 、ε = 0 として、更新式の長さの 2 乗を取ります。
\begin{aligned} \|\tilde{\mathbf{w}}[n+1]\|^2 &= \|\tilde{\mathbf{w}}[n]\|^2 \\ &\quad + 2\tilde{\mu}\frac{e\,\mathbf{x}^{\mathsf{T}}\tilde{\mathbf{w}}[n]}{\|\mathbf{x}\|^2} \\ &\quad + \tilde{\mu}^2\frac{e^2}{\|\mathbf{x}\|^2} \\ &= \|\tilde{\mathbf{w}}[n]\|^2 \\ &\quad - \tilde{\mu}(2-\tilde{\mu})\frac{e^2}{\|\mathbf{x}\|^2} \end{aligned}0 < \tilde{\mu} < 2 なら右辺の第 2 項が必ず引き算になり、ずれは増えません。この条件に入力の電力は出てきません。 また、 \tilde{\mu}(2-\tilde{\mu}) が最大になる \tilde{\mu} = 1 が最速です。
誤調整は、白色の入力で M が大きいとき、次の式が目安です。
\mathcal{M} \approx \frac{\tilde{\mu}}{2-\tilde{\mu}}\tilde{\mu} = 1 で誤調整は 1、つまり定常の誤差は最小誤差の 2 倍です。 \tilde{\mu} = 0.1 なら 0.05 です。誤調整がタップ数に依らないことも LMS との違いです。
手計算:同じデータで
LMS と同じデータで、 \tilde{\mu} = 0.5 、ε = 0 とします。
n = 0。 \|\mathbf{x}[0]\|^2 = 1 、e = 0.6 なので、 \mathbf{w}[1] = 0.5 \times 0.6 \times [1,\ 0]^{\mathsf{T}} = [0.3,\ 0]^{\mathsf{T}} です。
n = 1。 \|\mathbf{x}[1]\|^2 = 1.25 、y = 0.15、e = 0.35 です。
\begin{aligned} \mathbf{w}[2] &= \begin{bmatrix}0.3\\0\end{bmatrix} + \frac{0.5\times 0.35}{1.25}\begin{bmatrix}0.5\\1\end{bmatrix} \\ &= \begin{bmatrix}0.37\\0.14\end{bmatrix} \end{aligned}n = 2。 \|\mathbf{x}[2]\|^2 = 0.5 、y = −0.115、e = −0.085 です。更新の係数は 0.5 × (−0.085) ÷ 0.5 = −0.085 です。
\begin{aligned} \mathbf{w}[3] &= \begin{bmatrix}0.37\\0.14\end{bmatrix} - 0.085\begin{bmatrix}-0.5\\0.5\end{bmatrix} \\ &= \begin{bmatrix}0.4125\\0.0975\end{bmatrix} \end{aligned}3 ステップで LMS の [0.093,\ 0.038]^{\mathsf{T}} より、ずっと [0.6,\ 0.2]^{\mathsf{T}} に近づきました。
破る例:入力の電力が途中で 10 倍になる
M = 8 の同定で、途中で入力の電力を 10 倍にします。LMS は μ = 0.03、NLMS は \tilde{\mu} = 0.3 とします。最初の電力では、どちらも同じくらいの速さです。
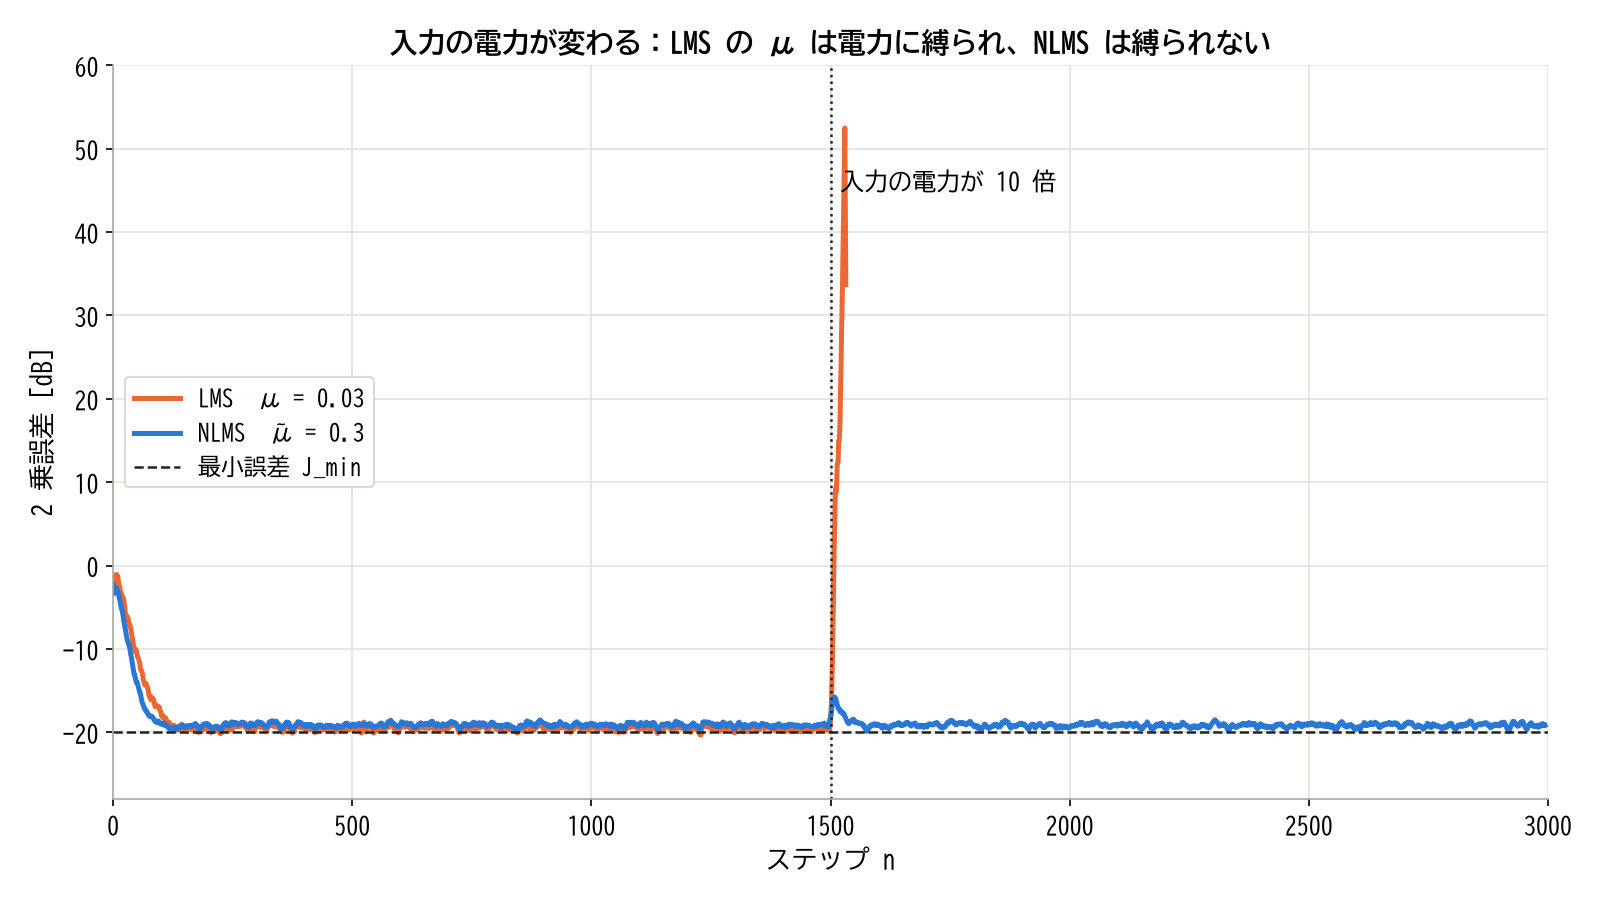
n = 1500 で入力の電力を 10 倍にした例。LMS は 2 乗誤差が 60 dB 近くまで増えて発散し、NLMS は変わらない
n = 1500 より前の 2 乗誤差の平均は、LMS が -19.4 dB、NLMS が -19.1 dB でそろっています。電力が 10 倍になると、LMS の上限 2/((M+2)P_x) は 0.2 から 0.02 へ下がり、μ = 0.03 はその外に出ます。誤差は増え続け、59 dB を超えました。NLMS は電力で割っているので、実質のステップは自動で 1/10 になり、誤差は -19.1 dB のままです。LMS の μ は入力の電力に縛られ、NLMS の \tilde{\mu} は縛られません。
⚡ RLS の導出
NLMS でも、有色の入力の遅さは残ります。原因は、碗が細長いのに勾配の向きへ下りていることでした。碗の形(R)を知っていれば、最初から底の方向へ向かえます。 RLS は R の逆行列を逐次更新することで、これを実現します。
忘却つきの最小 2 乗
LMS は期待値の近似でした。RLS は期待値を使わず、手元のデータ全部に対する最小 2 乗を毎サンプル解きます。古いデータの重みを下げるために、忘却係数 λ を掛けます。J は 2 乗平均誤差でしたが、ここでは期待値の代わりに重みつきの和を取った版を J_\lambda[n] と書きます。
J_\lambda[n] = \sum_{i=1}^{n}\lambda^{\,n-i}\left(d[i] - \mathbf{w}^{\mathsf{T}}\mathbf{x}[i]\right)^2λ は 1 以下で 1 に近い数です。1 サンプル前のデータの重みは λ 倍、2 サンプル前は λ² 倍です。重みの和は約 1/(1-\lambda) なので、実質このサンプル数の窓で平均していることになります。λ = 0.999 なら約 1000 サンプルです。
w で微分して 0 と置くと、ウィーナー解と同じ形の正規方程式が出ます。期待値が、重みつきの和に置き換わっただけです。
\mathbf{R}[n]\,\mathbf{w}[n] = \mathbf{p}[n] \begin{aligned} \mathbf{R}[n] &= \sum_{i=1}^{n}\lambda^{n-i}\mathbf{x}[i]\mathbf{x}[i]^{\mathsf{T}} \\ &= \lambda\mathbf{R}[n-1] + \mathbf{x}[n]\mathbf{x}[n]^{\mathsf{T}} \\ \mathbf{p}[n] &= \sum_{i=1}^{n}\lambda^{n-i}\mathbf{x}[i]\,d[i] \\ &= \lambda\mathbf{p}[n-1] + \mathbf{x}[n]\,d[n] \end{aligned}和の 1 個ずつの増分が、右の再帰の式です。毎サンプル \mathbf{R}[n]^{-1} を計算すれば解けますが、M × M の逆行列は重すぎます。
逆行列の補題で P を更新する
\mathbf{R}[n] は前の時刻の行列に \mathbf{x}\mathbf{x}^{\mathsf{T}} を足しただけです。行列に「縦ベクトル × 横ベクトル」を足したものの逆行列には、次の公式があります。これが逆行列の補題(Sherman–Morrison の公式)です。
(\mathbf{B} + \mathbf{u}\mathbf{u}^{\mathsf{T}})^{-1} = \mathbf{B}^{-1} - \frac{\mathbf{B}^{-1}\mathbf{u}\mathbf{u}^{\mathsf{T}}\mathbf{B}^{-1}}{1 + \mathbf{u}^{\mathsf{T}}\mathbf{B}^{-1}\mathbf{u}}右辺に \mathbf{B} + \mathbf{u}\mathbf{u}^{\mathsf{T}} を掛けると単位行列になることで確かめられます。
ここで \mathbf{P}[n] = \mathbf{R}[n]^{-1} と置きます。B に \lambda\mathbf{R}[n-1] 、u に \mathbf{x}[n] を当てはめると、 \mathbf{B}^{-1} = \mathbf{P}[n-1]/\lambda なので、分母と分子を整理して次の式になります。
\begin{aligned} \mathbf{P}[n] = \frac{1}{\lambda}\Bigl(&\mathbf{P}[n-1] \\ &- \frac{\mathbf{P}[n-1]\mathbf{x}\mathbf{x}^{\mathsf{T}}\mathbf{P}[n-1]}{\lambda + \mathbf{x}^{\mathsf{T}}\mathbf{P}[n-1]\mathbf{x}}\Bigr) \end{aligned}カッコの中の分数の前半を K[n] という名前のベクトルにします。
\mathbf{K}[n] = \frac{\mathbf{P}[n-1]\,\mathbf{x}[n]}{\lambda + \mathbf{x}[n]^{\mathsf{T}}\mathbf{P}[n-1]\,\mathbf{x}[n]}この K は、 \mathbf{P}[n]\mathbf{x}[n] に等しくなります。P の更新式の右から x を掛けて整理すれば確かめられます。
あとは係数の更新です。 \mathbf{w}[n] = \mathbf{P}[n]\mathbf{p}[n] に p の再帰を入れます。
\mathbf{w}[n] = \lambda\mathbf{P}[n]\mathbf{p}[n-1] + \mathbf{P}[n]\mathbf{x}[n]\,d[n]第 1 項の \lambda\mathbf{P}[n] は、P の更新式から \mathbf{P}[n-1] - \mathbf{K}\mathbf{x}^{\mathsf{T}}\mathbf{P}[n-1] です。これに \mathbf{p}[n-1] を掛けると、 \mathbf{P}[n-1]\mathbf{p}[n-1] = \mathbf{w}[n-1] なので \mathbf{w}[n-1] - \mathbf{K}\mathbf{x}^{\mathsf{T}}\mathbf{w}[n-1] になります。第 2 項は \mathbf{K}\,d[n] です。合わせると、まとまります。
\begin{aligned} \mathbf{w}[n] &= \mathbf{w}[n-1] \\ &\quad + \mathbf{K}[n]\left(d[n] - \mathbf{w}[n-1]^{\mathsf{T}}\mathbf{x}[n]\right) \end{aligned}カッコの中は、前の時刻の係数で計算した誤差 e_{\text{prior}}[n] です。事前誤差と呼びます。
初期値は \mathbf{w}[0] = \mathbf{0} 、 \mathbf{P}[0] = \delta^{-1}\mathbf{I} 。各ステップで次を計算する。
\mathbf{K}[n] = \dfrac{\mathbf{P}[n-1]\mathbf{x}[n]}{\lambda + \mathbf{x}[n]^{\mathsf{T}}\mathbf{P}[n-1]\mathbf{x}[n]}
e_{\text{prior}}[n] = d[n] - \mathbf{w}[n-1]^{\mathsf{T}}\mathbf{x}[n]
\mathbf{w}[n] = \mathbf{w}[n-1] + \mathbf{K}[n],e_{\text{prior}}[n]
\mathbf{P}[n] = \left(\mathbf{P}[n-1] - \mathbf{K}[n]\mathbf{x}[n]^{\mathsf{T}}\mathbf{P}[n-1]\right)/\lambda
| 記号 | 大きさ | 意味 |
|---|---|---|
| λ | 数 | 忘却係数。0.99〜1 |
| \mathbf{P}[n] | M × M | 重みつき相関行列の逆行列 |
| \mathbf{K}[n] | M × 1 | ゲイン |
| e_{\text{prior}} | 数 | 更新前の係数で計算した誤差 |
| δ | 数 | 初期化の小さな正の数 |
δ の意味。 \mathbf{R}[0] = \delta\mathbf{I} から始めたのと同じです。厳密には、最初の式に \delta\|\mathbf{w}\|^2 の項を足した正則化つきの最小 2 乗を解いています。δ が小さいほど、最初のデータを強く信じます。
性質
LMS の \mu e\,\mathbf{x} と見比べると、スカラーの μ が行列 P に変わった形です。 \mathbf{P} \approx \mathbf{R}^{-1} が勾配を掛け直すので、碗の楕円が円に引き直され、固有値の広がりの影響が消えます。
- 収束:教科書(Haykin の『Adaptive Filter Theory』)の結論として、平均 2 乗の意味で約 2M サンプルで収束し、速さは固有値の広がりに依らない
- 誤調整: \mathcal{M} \approx (1-\lambda)M/(1+\lambda) (λ < 1)。λ = 1 で定常なら 0 に向かう
- 計算量:1 サンプルあたり積和が M² のオーダー。メモリも M × M の行列を持つ
計算量の表記 O(M^2) は、M が 2 倍になると計算が 4 倍になることを表します。LMS は O(M) なので、M = 32 なら RLS の負荷は 1 桁以上重くなります。
手計算で 1 ステップ
同じデータで、λ = 1、 \mathbf{P}[0] = 100\,\mathbf{I} (δ = 0.01)とします。 \mathbf{x}[0] = [1,\ 0]^{\mathsf{T}} 、d = 0.6 です。 \mathbf{P}\mathbf{x} = [100,\ 0]^{\mathsf{T}} 、 \mathbf{x}^{\mathsf{T}}\mathbf{P}\mathbf{x} = 100 なので、次のようになります。
\mathbf{K} = \frac{1}{1 + 100}\begin{bmatrix}100\\0\end{bmatrix} = \begin{bmatrix}0.990099\\0\end{bmatrix}事前誤差は 0.6 で、係数は次の値です。
\mathbf{w}[1] = 0.6\begin{bmatrix}0.990099\\0\end{bmatrix} = \begin{bmatrix}0.594059\\0\end{bmatrix}1 歩で w_0 が真の 0.6 のすぐそばまで来ました。P の左上は 100 - 0.990099 \times 100 = 0.990099 、右下は 100 のままです。「 w_0 はもう分かった、 w_1 はまだ分からない」という状態です。続けて n = 1 を計算すると \mathbf{w}[2] = [0.595052,\ 0.200469]^{\mathsf{T}} になり、2 サンプルで 2 つの係数がほぼ決まります。 未知数 2 つに式 2 本だからです。
#5 のカルマンとの対応
RLS の P と K は、#5 のカルマンフィルタの P と K と同じ役割です。文字が同じなのは偶然ではありません。RLS は、係数を状態とみなしたカルマンフィルタです。 係数を状態と見ると、次のモデルになります。
\begin{aligned} \mathbf{w}[n] &= \mathbf{w}[n-1] + \boldsymbol{\xi}[n] \\ d[n] &= \mathbf{x}[n]^{\mathsf{T}}\mathbf{w}[n] + v[n] \end{aligned}\boldsymbol{\xi} が #5 のプロセスノイズに当たります(この記事では w を係数に使うので、文字を替えました)。v は #5 の測定ノイズで、分散を 1 と置きます。観測行列が x[n] の転置で、時刻ごとに変わります。#5 の 5 本の式に、 A = I 、 C = \mathbf{x}[n]^{\mathsf{T}} 、測定ノイズの分散 1 を入れて、RLS と並べます。ここの Q は #5 のプロセスノイズの共分散です。
| #5 のカルマン | RLS |
|---|---|
| 状態 \hat{x} | 係数 \mathbf{w} |
| 測定 y[n] | 目標信号 d[n] |
| 観測行列 C | \mathbf{x}[n]^{\mathsf{T}} |
| 測定ノイズ分散 R | 1 |
| \hat{x}^-[n] = A\hat{x}[n-1] | 係数は持ち越し |
| P^-[n] = AP[n-1]A^{\mathsf{T}} + Q | \mathbf{P}[n-1]/\lambda |
| K の式 | 手順 1(分子と分母を λ で揃える) |
| \hat{x} の更新 | 手順 3 |
| P の更新 | 手順 4 |
K の行だけ確かめます。 P^- = \mathbf{P}/\lambda をカルマンゲインへ入れて、分子と分母に λ を掛けます。
K = \frac{(\mathbf{P}/\lambda)\mathbf{x}}{\mathbf{x}^{\mathsf{T}}(\mathbf{P}/\lambda)\mathbf{x} + 1} = \frac{\mathbf{P}\mathbf{x}}{\mathbf{x}^{\mathsf{T}}\mathbf{P}\mathbf{x} + \lambda}RLS の手順 1 そのものです。λ = 1 なら Q = 0、つまり「係数は動かない」と仮定したカルマンフィルタです。 #5 の「Q = 0 なら K は 1/n」の話の、多次元の版です。
λ < 1 は、 P^- = \mathbf{P}/\lambda = \mathbf{P} + (1/\lambda - 1)\mathbf{P} なので、Q を P に比例させて (1/\lambda - 1)\mathbf{P}[n-1] にしたカルマンフィルタです。係数が少しずつ動くかもしれないので、不確かさを毎ステップ一定の割合で増やす、と読めます。固定の Q を置く本来のランダムウォークのモデル(今の値に独立な乱数を足し続けるモデル)とは同じではありませんが、役割は近いものです。
Sayed と Kailath の 1994 年の論文は、状態を \lambda^{-n/2}\mathbf{w} 、測定を \lambda^{-n/2}d[n] に変換すると、 A = \lambda^{-1/2}I 、Q = 0、測定ノイズの分散 1 のカルマンフィルタに厳密に対応づけられることを示しました。上の表はそれを A = I の形に読み替えたものです。計算でも、2000 ステップの全区間で RLS の係数と上の表のカルマンの差が 4\times 10^{-16} 以下で、丸め誤差の範囲で一致しました。
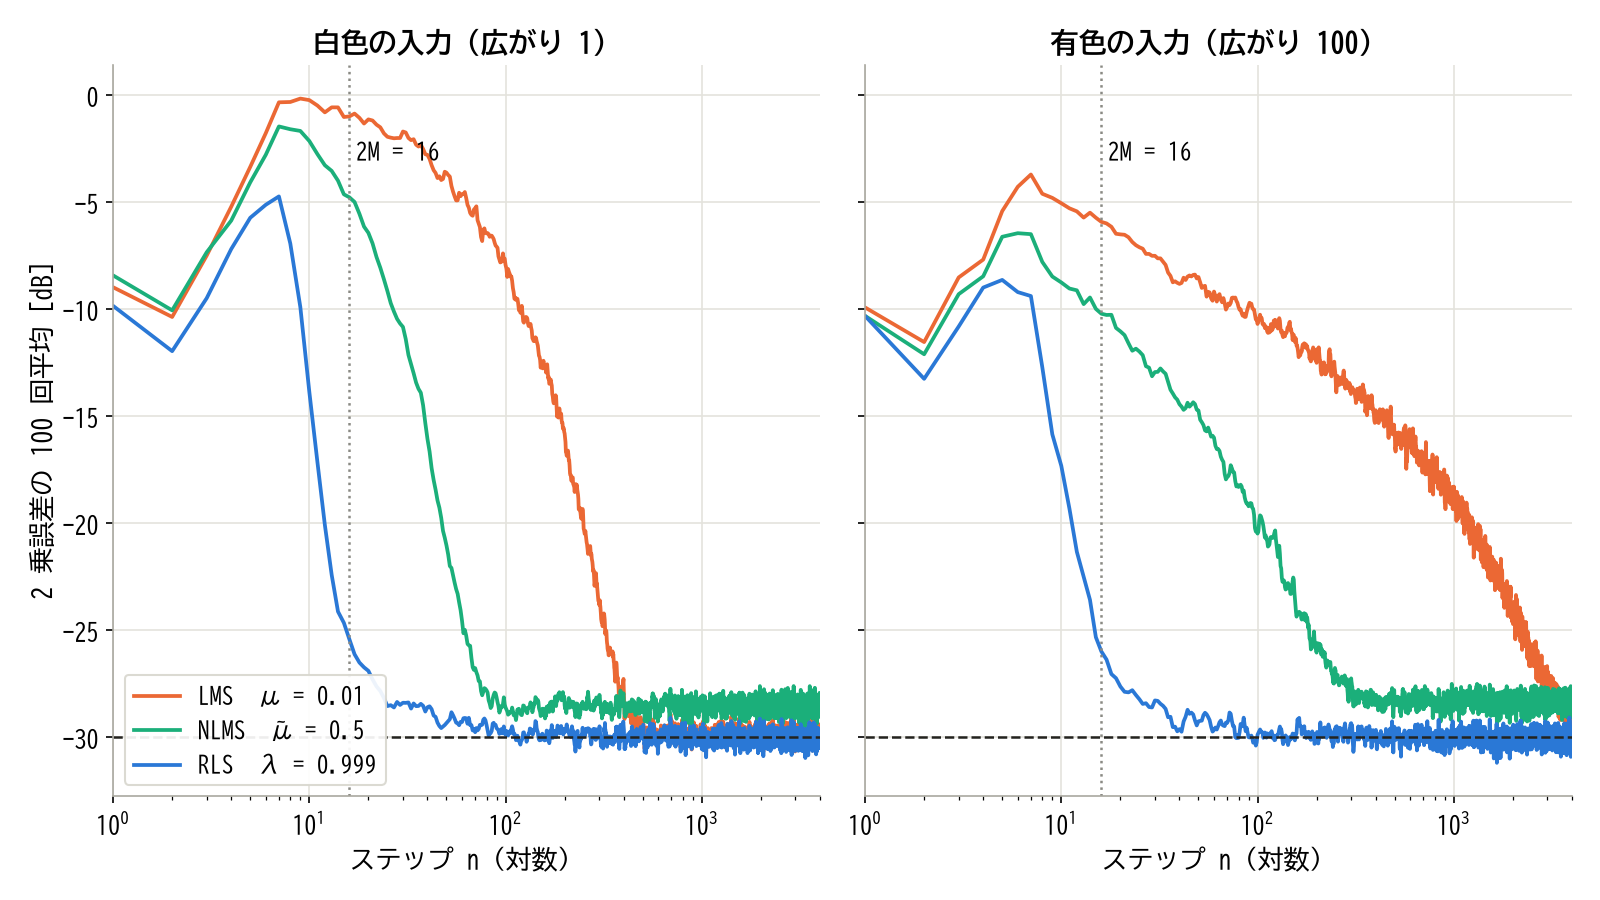
M = 8 の同定。左が白色、右が固有値の広がり 100 の有色の入力。RLS だけが広がりに関係なく 2M 付近で収束する
M = 8 の同定で、観測ノイズの電力は 0.001 です。有色の入力は、1 つ前の値に 0.89 を掛けてノイズを足した信号で、固有値の広がりは 100 です。係数の誤差が −20 dB に入るまでのステップ数を比べます。
| 入力 | LMS(μ = 0.01) | NLMS(0.5) | RLS(0.999) |
|---|---|---|---|
| 白色 | 244 | 45 | 11 |
| 有色(χ = 100) | 3043 | 215 | 14 |
LMS は白色の 12 倍かかりました。NLMS も 5 倍です。RLS は 11 ステップから 14 ステップで、どちらも 2M = 16 の内です。有色の入力で RLS が効くのは、P が碗の楕円を円に引き直すからです。 代わりに、1 サンプルの計算は桁が違います。定常の高さは、NLMS の \tilde{\mu} = 0.5 が誤調整 1/3 で少し高く、LMS と RLS はほぼ最小誤差です。
📊 周波数と制御工学の道具で見る
適応フィルタは線形でも時不変でもないので、#1 の伝達関数はそのままでは使えません。ただし、見方を工夫すると使えるようになります。適応のループを 1 次系として読むこと、正弦波の参照ならノッチとして厳密に書けること、経路が入ると位相余裕の問題になることの 3 つです。
適応ループは積分器を含むフィードバック
タップが 1 本の LMS を書き直します。入力の電力が P_x の白色で、目標を d = w_o x + v とします。
\begin{aligned} w[n+1] &= w[n] + \mu x[n]\,e[n] \\ e[n] &= w_o x[n] + v[n] - w[n]\,x[n] \end{aligned}平均を取ると、 x^2 が P_x に置き換わります。
\bar{w}[n+1] = (1 - \mu P_x)\,\bar{w}[n] + \mu P_x\,w_o\bar{w} は w の平均です。#2 の 1 次 IIR の y[n] = (1-\alpha)y[n-1] + \alpha x[n] と同じ形です。 \alpha = \mu P_x と読めます。
1 タップの LMS の係数の平均は、 \alpha = \mu P_x の 1 次ローパスで w_o を追いかける。極は 1 - \mu P_x 、時定数は 1/(\mu P_x) サンプル。μP_x がループのゲインに当たる。
μ = 0.01、 P_x = 1 、 w_o = 1 で確かめました。4000 回の平均で、100 ステップ後の係数は 0.633、式の 1 - 0.99^{100} は 0.634 です。300 ステップ後は 0.951 と 0.951 でした。
ブロック図で見ると、これはフィードバックループです。
z⁻¹ / (1 − z⁻¹)"] I -->|"係数 w"| X["× x"] X -->|"出力 y(符号を反転)"| S
誤差に μx を掛けて積分したものが係数で、係数に x を掛けたものが出力で、それを目標から引きます。ループのゲインは \mu x^2 で、平均は \mu P_x です。積分器があるので、定常の誤差の相関 E[e\,x] は 0 に追い込まれます。LMS は、誤差と入力の相関を 0 にする積分制御です。 ウィーナー解の条件 E[\mathbf{x}\,e] = 0 が、ループの平衡点になっています。
正弦波を参照にすると、ノッチに等価
適応フィルタは時変ですが、参照が正弦波なら線形時不変のノッチと厳密に等しくなります。 Widrow らの 1975 年の論文の結果です。Glover の 1977 年の論文は、これを正弦波の妨害の除去として詳しく扱いました。
タップは 2 本にして、遅延の代わりに cos と sin を入れます。ω₀ は参照の角周波数(1 サンプルあたりのラジアン)、 A_r は参照の振幅です。
\begin{aligned} x_1[n] &= A_r\cos\omega_0 n \\ x_2[n] &= A_r\sin\omega_0 n \end{aligned}LMS の更新 w_i[n+1] = w_i[n] + \mu\,e[n]\,x_i[n] を、初期値 0 から足し合わせます。
w_i[n] = \mu\sum_{k \lt n} e[k]\,x_i[k]出力は y[n] = w_1[n]x_1[n] + w_2[n]x_2[n] です。代入して和をまとめます。
\begin{aligned} y[n] = \mu\sum_{k \lt n} e[k]\bigl(&x_1[n]x_1[k] \\ &+ x_2[n]x_2[k]\bigr) \end{aligned}カッコの中が要点です。加法定理 \cos\theta_1\cos\theta_2 + \sin\theta_1\sin\theta_2 = \cos(\theta_1-\theta_2) で、時刻の差だけの式になります。
y[n] = \mu A_r^2\sum_{k \lt n} e[k]\cos\omega_0(n-k)係数は時間で動くのに、e から y への関係は n − k だけで決まります。 つまり、時不変のたたみ込みです。m = n − k と置いて z 変換します。
\begin{aligned} G(z) &= \frac{Y(z)}{E(z)} = \mu A_r^2\sum_{m=1}^{\infty}\cos(\omega_0 m)\,z^{-m} \\ &= \mu A_r^2\,\frac{z\cos\omega_0 - 1}{z^2 - 2z\cos\omega_0 + 1} \end{aligned}和の公式は、 \cos\omega_0 m を指数関数 2 つに分けて等比級数を足すと出ます。ω₀ に極があります。正弦波に共振する積分器です。e = d − y なので、d から e への伝達関数 H(z) = E(z)/D(z) はフィードバックの公式 1/(1 + G) です。
H(z) = \frac{z^2 - 2z\cos\omega_0 + 1}{z^2 - a_1 z + a_2} a_1 = (2 - \mu A_r^2)\cos\omega_0,\quad a_2 = 1 - \mu A_r^2Widrow の式 (64) で 2μ を μ に読み替えたものと同じです。 a_1 の符号は、#1 の分母の形 1 + a_1 z^{-1} + a_2 z^{-2} とは逆に取っています。形を読みます。
| 記号 | 値 | 意味 |
|---|---|---|
| 零点 | e^{\pm j\omega_0} | 単位円の上。ω₀ で完全に 0 |
| 極の半径 | \sqrt{1 - \mu A_r^2} | 零点の少し内側 |
| −3 dB の幅 | \mu A_r^2/T rad/s | Hz なら \mu A_r^2 f_s/(2\pi) |
| 時定数 | 2/(\mu A_r^2) サンプル | 極の半径 \approx 1 - \mu A_r^2/2 から |
f_s = 1/T はサンプリング周波数です。#4 のノッチと同じ形で、極と零点が同じ角度に並びます。ノッチの帯域幅が \mu A_r^2 で決まるので、適応ノッチの設計は μ の選択そのものです。Q は 2\pi f_0/(\mu A_r^2 f_s) で計算できます。表の幅の式は、極の半径から求めた近似です。
μ を 3 通りに振って、#4 の固定ノッチ(Q = 30)と重ねます。線は上の式、点は時間領域で LMS を動かして測ったゲインです。
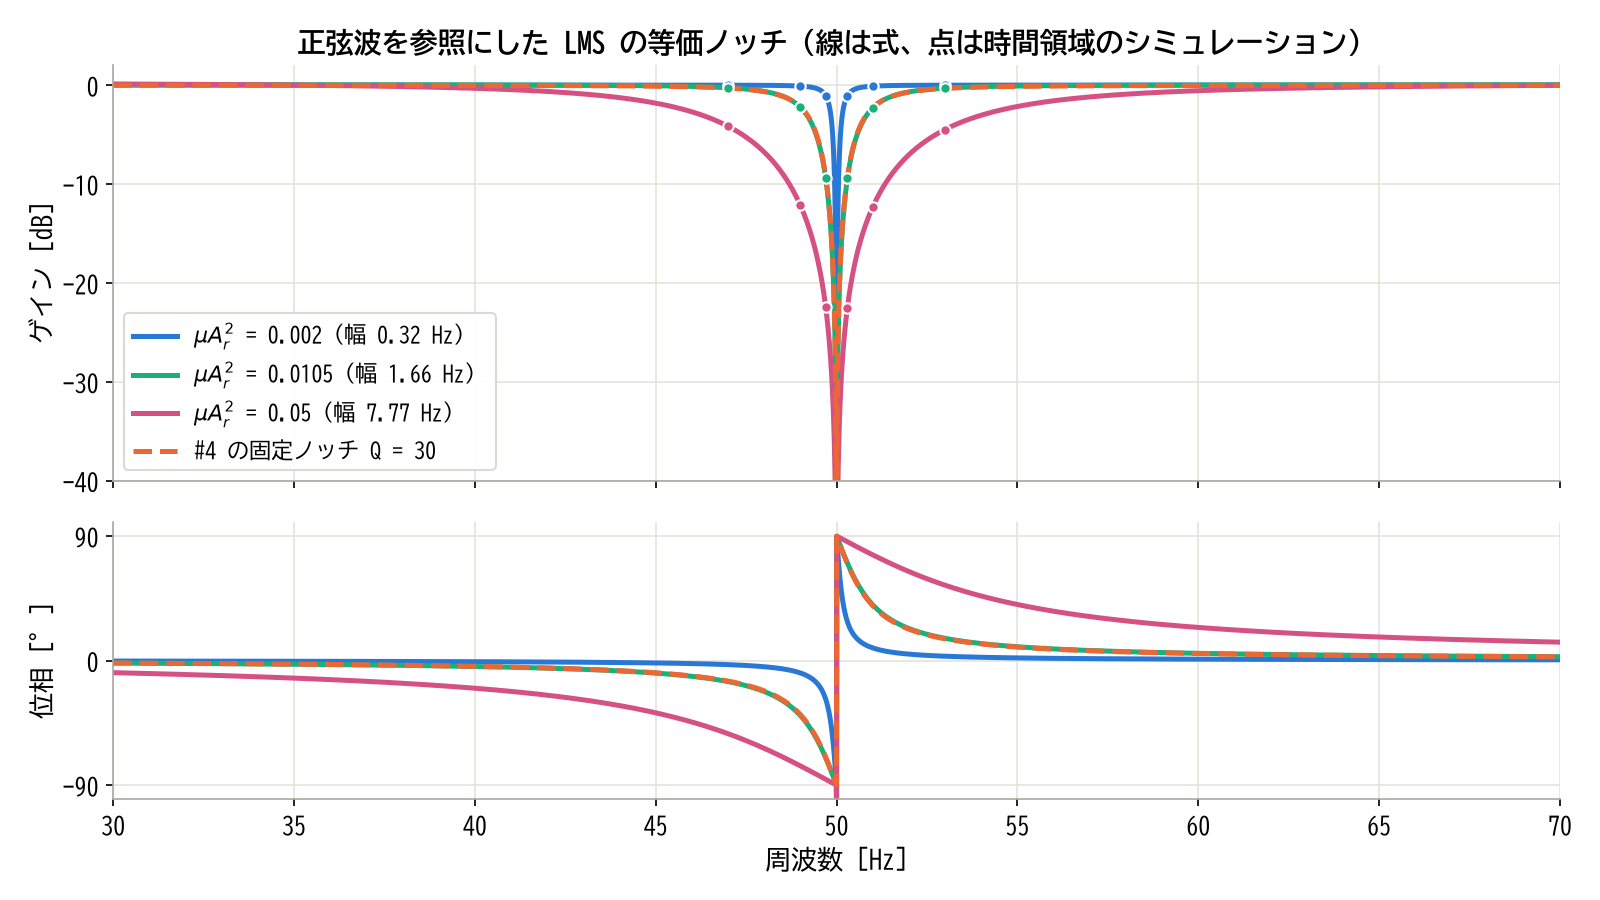
fs = 1 kHz、ω₀ は 50 Hz。μA_r² = 0.0105 は Q = 30 の固定ノッチとほぼ重なる。点は式からのずれが 1 dB の 10 億分の 1 以下
式と時間領域の差は 10^{-9} dB 以下でした。近似ではなく、厳密に一致します。数字を並べます。参照を 50 Hz に固定して、それぞれの周波数の入力を通したときのゲインです。幅は近似の式ではなく、H(z) から読んだ値です。
| μA_r² | 幅(Q) | 50.3 Hz | 48 Hz |
|---|---|---|---|
| 0.002 | 0.32 Hz(157) | −1.08 dB | −0.02 dB |
| 0.0105 | 1.66 Hz(30.1) | −9.44 dB | −0.63 dB |
| 0.05 | 7.77 Hz(6.4) | −22.5 dB | −6.77 dB |
| 固定 Q = 30 | 1.64 Hz | −9.30 dB | −0.65 dB |
時定数は順に 1 s、0.19 s、0.04 s です。μ を上げると、ノッチが広がって速く追従しますが、近くの信号も削ります。 μA_r² = 0.05 は 48 Hz の信号を −6.8 dB も削りました。#4 で見た Q のトレードオフが、μ の選び方として戻ってきています。
ではなぜ、はじめにの図で適応だけが漏れなかったのか。上の表の μA_r² = 0.0105 は、参照が 50 Hz のままなら固定ノッチと同じように 50.3 Hz で漏れます。はじめにの図は、参照の周波数も 50.3 Hz に動いた場合です。谷の中心 ω₀ が参照で決まるので、参照が電源に同期していれば谷が一緒に動きます。ハムの振幅と位相は LMS が学習します。これが固定ノッチとの本質的な違いで、Widrow の論文が「adaptive process maintains the null exactly at the reference frequency」と書いたことです。
もう 1 つ、Widrow の論文の観察を添えます。入力の周波数が参照と少し違うと、係数は 1 点に収束せず、差の周波数で回り続けます。それでも正弦波が打ち消せるのは、係数の回転が周波数を変換する役割を果たすからです。上の式の時不変性は、この回転を含めて成り立っています。
破る例:経路が入ると、位相誤差で発散する
適応フィルタの出力が、そのまま誤差の点に届くとは限りません。能動騒音制御(ANC)では、フィルタの出力がスピーカーから空間を伝わり、マイクで誤差になります。出力から誤差までの経路を 2 次経路 H_s(z) と呼びます。式はこうなります。
e[n] = d[n] - h_s[n] * y[n]*はたたみ込みです。e の勾配を w で計算すると、y が H_s を通る分、勾配の向きが H_s の分だけ回ります。普通の LMS のままだと、 H_s の位相で誤った向きへ更新します。そこで、参照を H_s の推定 \hat{H}_s に通してから更新に使います。
\mathbf{w}[n+1] = \mathbf{w}[n] + \mu,e[n],\mathbf{x}’[n] 。 \mathbf{x}’ は入力 x を推定した 2 次経路 \hat{H}_s に通した信号の直近 M サンプル。
「Filtered-x」の名は、Widrow、Shur、Shaffer の 1981 年の適応逆制御の論文にあります。同じ年に Burgess がダクトの能動消音のシミュレーションで同じ考えを示し、Morgan は 1980 年に、補助経路にフィルタがある相関キャンセルループの解析を発表しています。
単一の周波数で安定性を求めます。周波数 ω₀ の 2 次経路のゲインを g、位相の遅れを φ、推定のゲインを ĝ、位相の遅れを φ̂ とします。cos と sin の 2 タップの係数を、1 つの複素数 η(振幅と位相を持つ包絡線)にまとめ、2ω₀ の速い成分を無視すると、次の 1 次系になります。
\eta[n+1] = \left(1 - \beta e^{j\psi}\right)\eta[n] + (\text{一定値}) \beta = \frac{\mu A_r^2\,g\,\hat{g}}{2},\quad \psi = \hat{\phi} - \phiψ が推定の位相誤差です。極 1 - \beta e^{j\psi} の大きさが 1 より小さい条件を計算します。
|1 - \beta e^{j\psi}|^2 = 1 - 2\beta\cos\psi + \beta^2 < 1 \beta < 2\cos\psi\cos\psi > 0 、つまり推定の位相誤差が ±90° の内側でなければ、どんな小さな μ でも発散する。 内側でも、位相誤差が大きいほど収束は遅く、μ の上限は下がる。
制御の言葉で読むと分かりやすくなります。開ループは L(z) = \beta e^{j\psi}z^{-1}/(1-z^{-1}) で、積分器です。積分器の位相は交差の周波数で −90° なので、位相余裕(あと何度遅れると発振するかの余裕)は 90^\circ - |\psi| です。推定の位相誤差は、そのまま#2 で見た位相余裕を食います。
120 Hz の妨害を、fs = 1 kHz、経路のゲイン 0.8、遅延 5 サンプル、μ = 0.02 で消す例です。β = 0.0064 です。
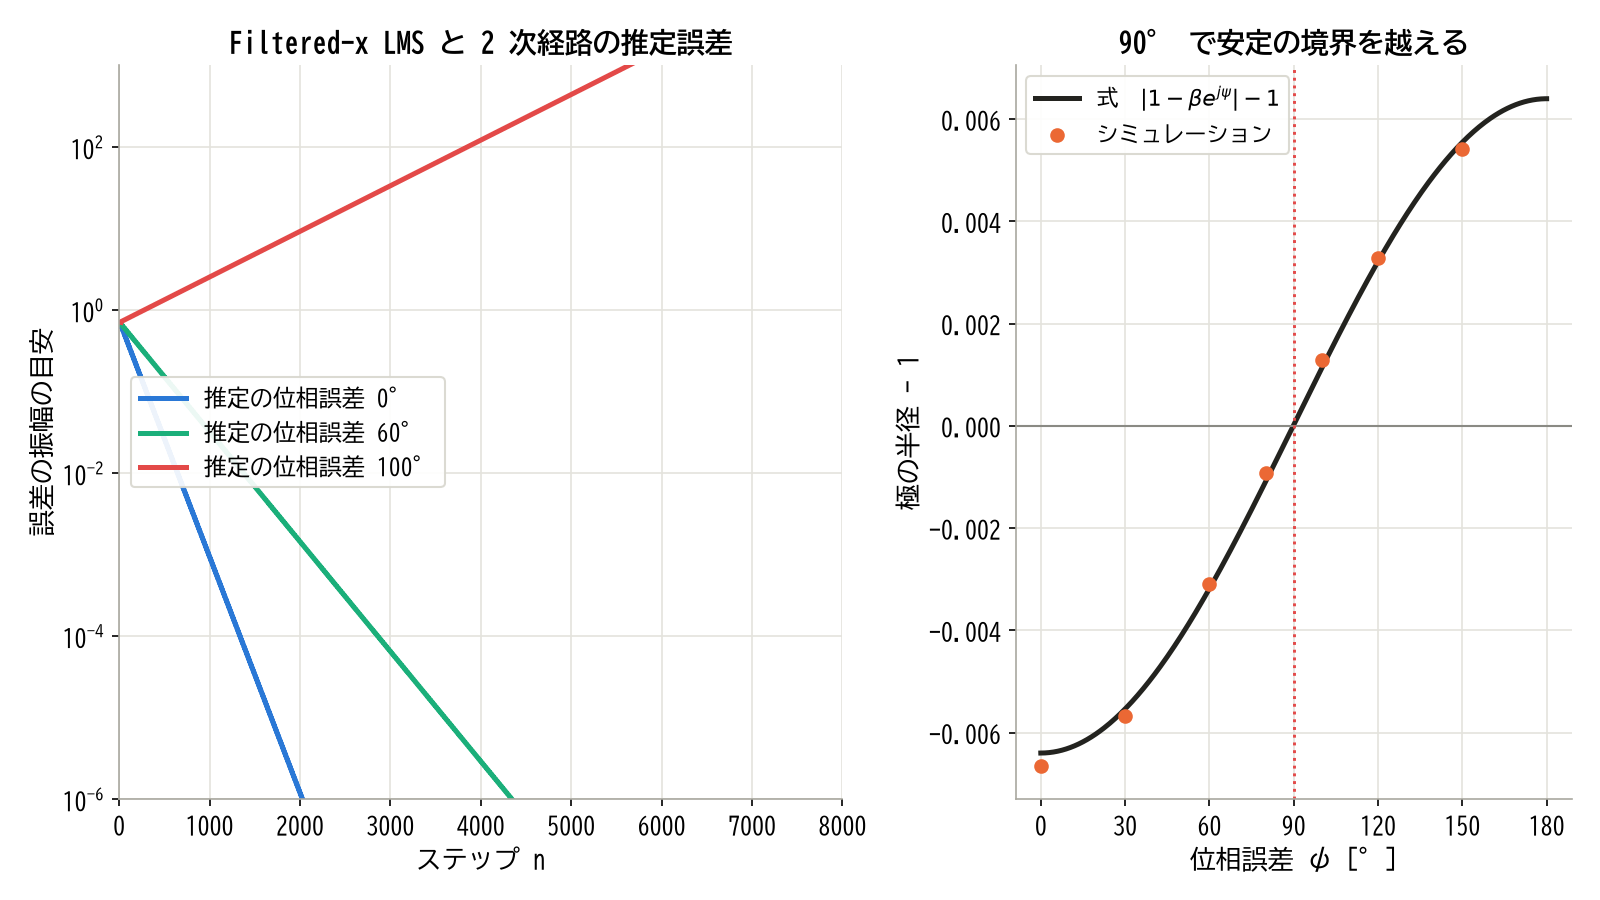
左:位相誤差 60° は遅いが収束し、100° は発散する。右:極の半径の式とシミュレーションの点。90° が安定の境界
位相誤差 0°、60°、100° の極の半径は 0.9936、0.9968、1.0011 で、100° だけ 1 を超えます。右の図で、シミュレーションから読んだ増え方は式と合っています。2 次経路の推定を使わない普通の LMS は、φ̂ = 0 と同じです。この例の 120 Hz では遅延 5 サンプルの位相が 216° あるので ψ は −216° です。推定のゲインを同じとすると、極の半径は 1.0052(シミュレーションで 1.0051)で発散します。
🛠️ 設計例
要件、構成、タップ数と μ または λ、初期値、検証の順に進めます。3 つとも合成信号で、実機の配線や部品の話はしません。
設計例 1:50 Hz ハムのキャンセル
要件。 fs = 1 kHz で計測する信号に、商用電源のハムが乗っています。計測信号は 0.7 Hz と 3.1 Hz のゆっくりした成分に、47 Hz の小さな成分を足したものです。ハムは基本波と 3 次高調波(基本波の 3 倍の周波数の成分)で、周波数は 49.8〜50.3 Hz で揺れ、振幅も揺れます。t = 30 s で振幅が 0.6 倍に変わります。求める性能は、残留ハムが −30 dB 以下、47 Hz の信号の減衰が 1 dB 以内、振幅の変化に 0.2 s 以内で追従することです。
構成。 干渉キャンセルです。d はセンサの値、x は電源に同期した正弦波です。参照は、電源の電圧波形に PLL(位相同期ループ。入力の位相に自分の発振を合わせ続ける仕組み)を掛けて作ることを想定します。妨害と周波数が同じ参照さえあれば、振幅と位相は学習できます。
タップ数と μ。 基本波だけなら 2 タップ(cos と sin)、3 次も消すなら 4 タップです。参照の振幅を A_r = 1 にすると、等価ノッチの式がそのまま使えます。
\begin{aligned} \text{帯域幅} &= \frac{\mu f_s}{2\pi} \\ \text{時定数} &= \frac{2}{\mu}\ \text{サンプル} \end{aligned}追従の要件から時定数 0.1 s、 \mu = 2/100 = 0.02 とします。帯域幅は 3.18 Hz です。47 Hz の減衰は等価ノッチの式で −0.95 dB なので、要件の内側です。μ は誤調整ではなく、ノッチの幅と追従時間から決めます。 参照が正弦波で、等価な伝達関数が分かっているからです。
初期値。 w = 0 です。t = 0 から 0.5 s ほどは学習の区間です。
検証。 #4 の固定ノッチ(Q = 30)と比べます。公平になるように、150 Hz にも同じ Q のノッチを入れた 2 段の例も用意しました。
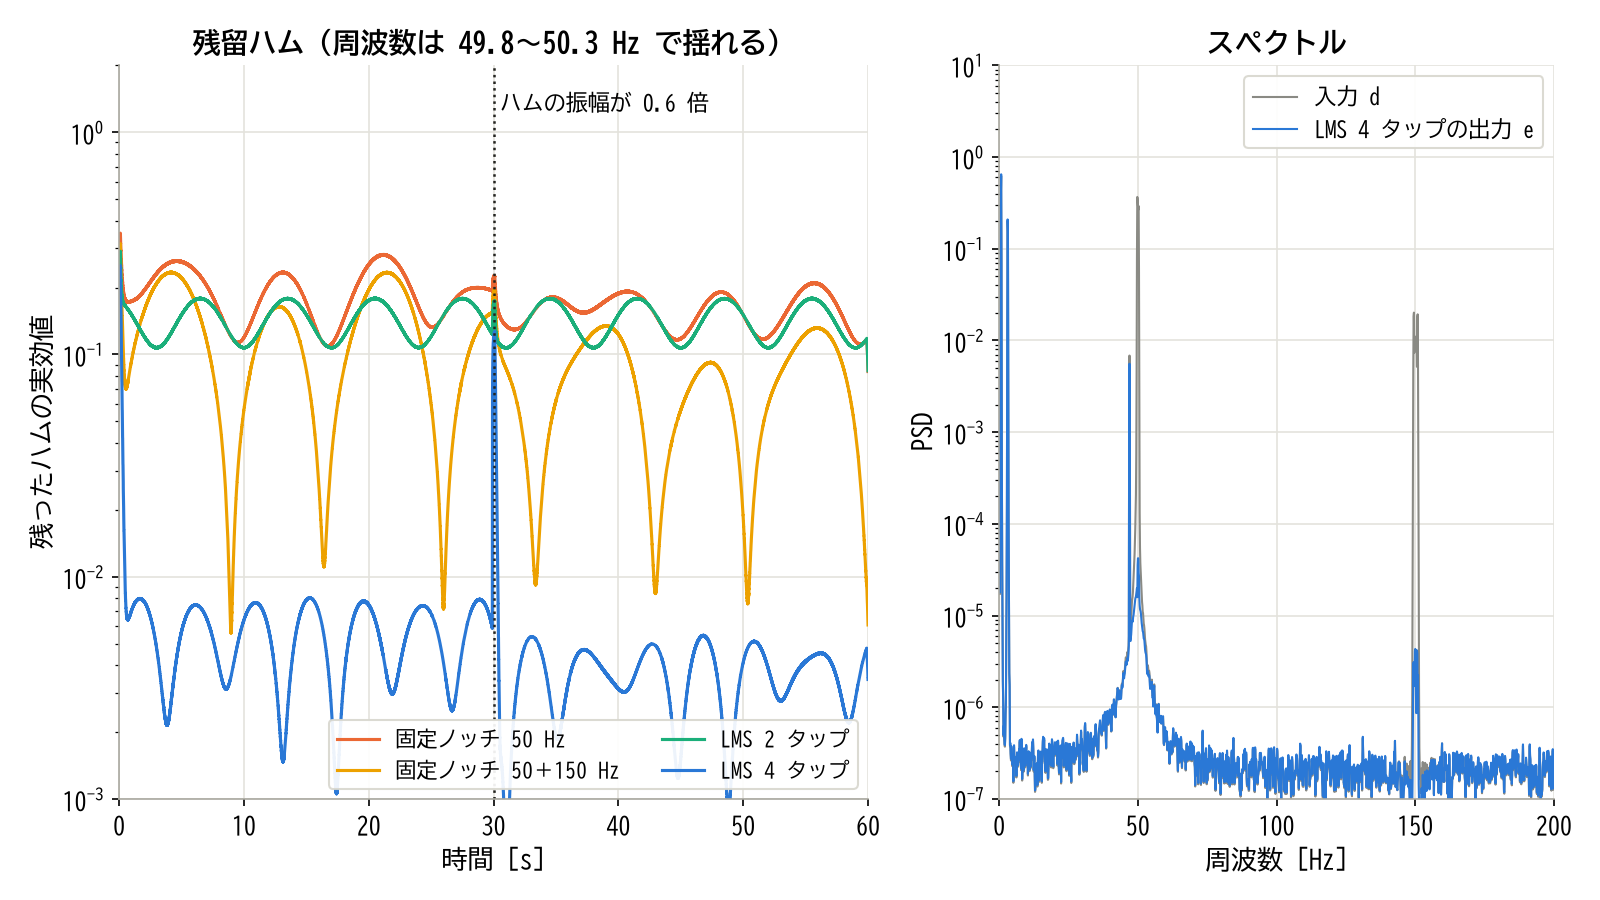
左:周波数が揺れると固定ノッチの残りが増減する。4 タップの LMS は 0.01 以下を保ち、振幅が変わった 30 秒の過渡も短い。右:50 Hz と 150 Hz の線が消え、47 Hz の信号は残る
LMS は、参照を固定すると d に対して線形です(e は d の線形な関数)。そこで、ハムと信号を別々に通すと、残留ハムと信号の歪みを分けて測れます。t > 5 s の結果です。
| 方式 | 残留ハム | 信号の歪み |
|---|---|---|
| 固定ノッチ 50 Hz | −8.7 dB | −33.2 dB |
| 固定ノッチ 50+150 Hz | −12.9 dB | −32.8 dB |
| LMS 2 タップ | −10.4 dB | −27.9 dB |
| LMS 4 タップ | −34.4 dB | −27.0 dB |
残留ハムはハムの入力電力に対する比、信号の歪みは信号の電力に対する比です。4 タップの LMS は要件の −30 dB を満たしました。2 タップは 150 Hz が丸ごと残るので、−10.4 dB で止まります。固定ノッチの −12.9 dB は、周波数の揺れで谷から外れている時間に決まります。LMS の信号の歪みが固定ノッチより 6 dB ほど悪いのは、谷の幅が 3.18 Hz と広いからです。 47 Hz の成分を少し削ります。
μ を動かすと、残留と歪みが交換になります。
| μ | 帯域幅 | 残留ハム | 信号の歪み |
|---|---|---|---|
| 0.005 | 0.80 Hz | −26.3 dB | −38.3 dB |
| 0.01 | 1.59 Hz | −30.6 dB | −32.4 dB |
| 0.02 | 3.18 Hz | −34.4 dB | −27.0 dB |
| 0.04 | 6.37 Hz | −37.9 dB | −22.5 dB |
| 0.08 | 12.7 Hz | −41.1 dB | −18.6 dB |
μ を上げるほどハムの振幅の変化に速く追いつき、残留が減ります。その分、信号も削ります。設計は、信号が谷の近くにどれだけあるかで決まります。47 Hz に何も無い信号なら、もっと μ を上げられます。
設計例 2:モータの PWM の経路同定とキャンセル
要件。 fs = 10 kHz で測るセンサに、モータの PWM の漏れが乗っています。PWM の指令(矩形波)は制御の側で分かっていますが、どの経路でどれだけ乗るかは分かりません。センサの本来の信号は、5 Hz の成分と白色ノイズで実効値 0.02、PWM の漏れの実効値は 0.25 です。求める性能は、0.5 s 以内に 30 dB 打ち消すことです。
構成。 システム同定です。x は PWM の指令、d はセンサの値で、未知の経路を学習して y を作り、d から引きます。e が本来の信号の推定になります。干渉キャンセルでもあり、学習後の係数は経路のインパルス応答でもあります。
ここでは経路を、800 Hz の 2 次ローパスと 1.5 kHz の共振を足した 32 タップの FIR として生成しました。PWM は周期 20 サンプル(500 Hz)の矩形波で、周期ごとのデューティ比(1 周期のうち ON の割合)を 0.2〜0.8 でランダムに変えます。指令の平均 0.5 は引いて x にします。x の電力は 0.25 です。
タップ数と μ。 経路の長さから M = 32 です。比較のために、3 方式の誤調整をそろえて 0.04 にします。
\mu = 0.01,\quad \tilde{\mu} = 0.08,\quad \lambda = 0.9975それぞれ \mu MP_x/2 = 0.04 、 \tilde{\mu}/(2-\tilde{\mu}) = 0.042 、 (1-\lambda)M/(1+\lambda) = 0.04 です。μ = 0.01 は LMS の上限 2/((M+2)P_x) = 0.235 の約 24 分の 1 で、十分小さい値です。誤調整を先に決めて、μ と λ を逆算します。
検証。 打ち消し量には ERLE(Echo Return Loss Enhancement)を使います。エコーキャンセラの分野の指標で、消したい成分の電力を、消し残りの電力で割ったものです。
\mathrm{ERLE} = 10\log_{10}\frac{E[(h*x)^2]}{E[(h*x - y)^2]}h[n] は未知の経路のインパルス応答です。シミュレーションでは真値が分かるので計算できます。実機の信号では e の電力から間接的に見積もることになります。20 回の平均を次の図に示します。
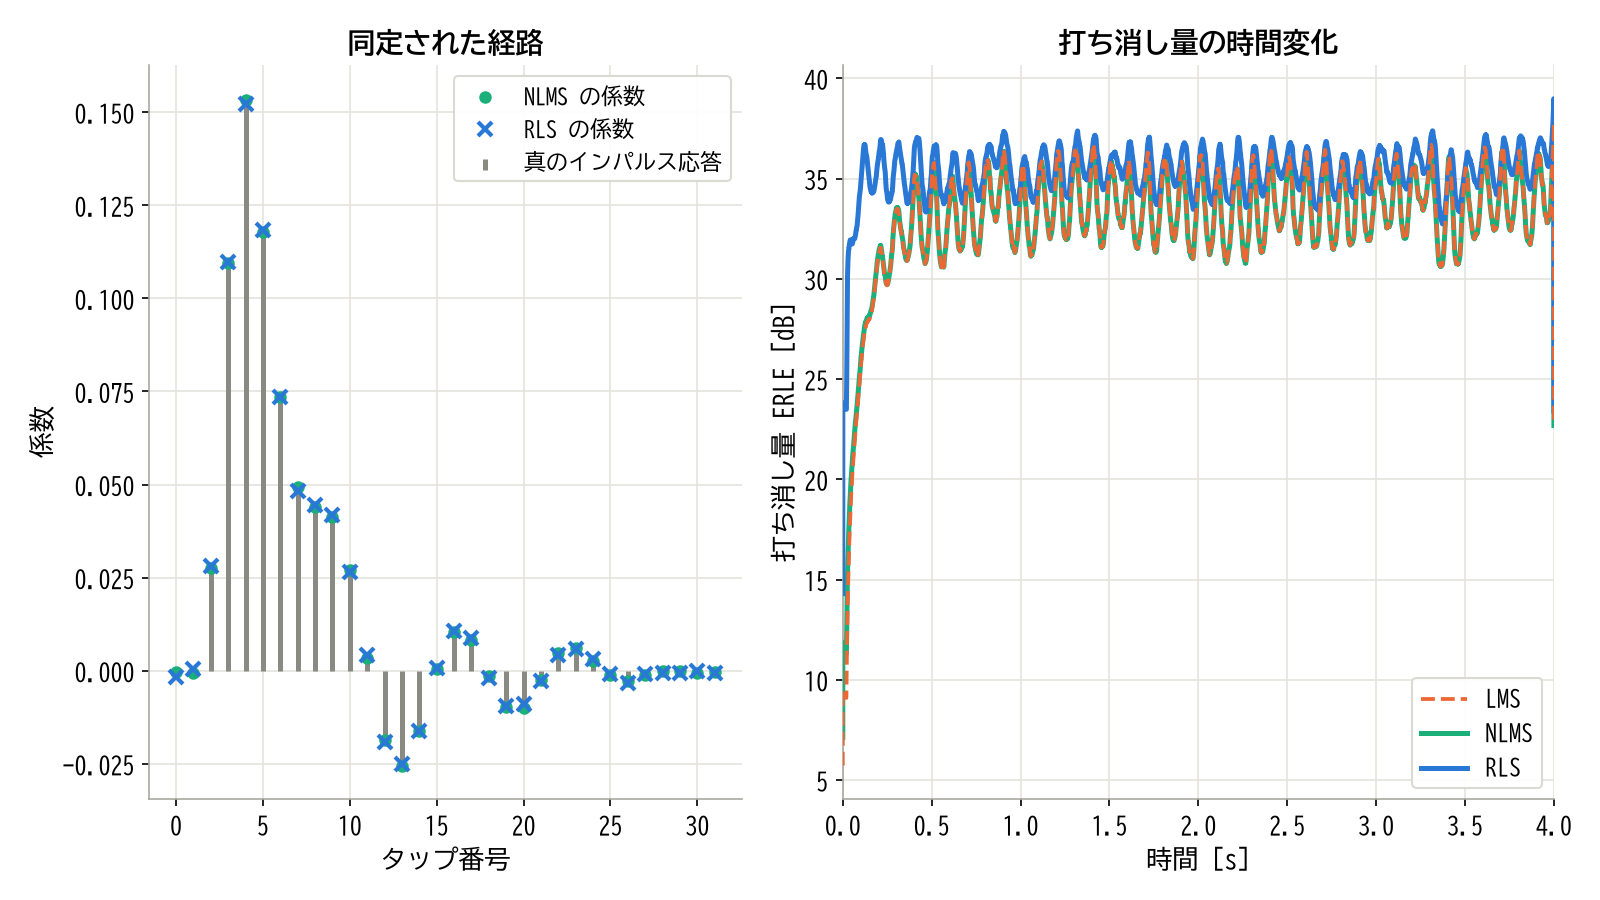
左:係数が真のインパルス応答に重なる。右:RLS は 0.03 秒ほどで 30 dB を超える。LMS(破線)と NLMS はほぼ重なる。揺れは本来の信号の 5 Hz の成分に合わせて 1 秒に 10 回出る
3 方式の数字を並べます。
| 方式 | 30 dB までの時間 | 最後の ERLE | 係数の誤差 |
|---|---|---|---|
| LMS | 0.19 s | 33.8 dB | −29.9 dB |
| NLMS | 0.18 s | 33.8 dB | −29.9 dB |
| RLS | 0.03 s | 35.8 dB | −24.7 dB |
時間は 40 ms の移動平均で読みました。係数の誤差は、ずれの長さの 2 乗を真の係数の長さの 2 乗で割った値です。3 方式とも要件の 0.5 s を満たしました。LMS と NLMS がほぼ同じなのは、x が ±0.5 の矩形波で、履歴が埋まったあとの \|\mathbf{x}\|^2 が常に 8 になるからです。NLMS の実質のステップは 0.08/8 = 0.01 で、LMS の μ と一致します。違うのは履歴が埋まるまでの最初の 32 サンプルだけです。この入力の固有値の広がりは 183 で、時間差はそのまま RLS の強みです。
破る例 1:指令がゆっくり変わる。 デューティ比をランダムではなく 1 秒周期の正弦波で動かすと、入力のスペクトルは 500 Hz とその高調波に集まります。固有値の広がりは 3085 になりました。
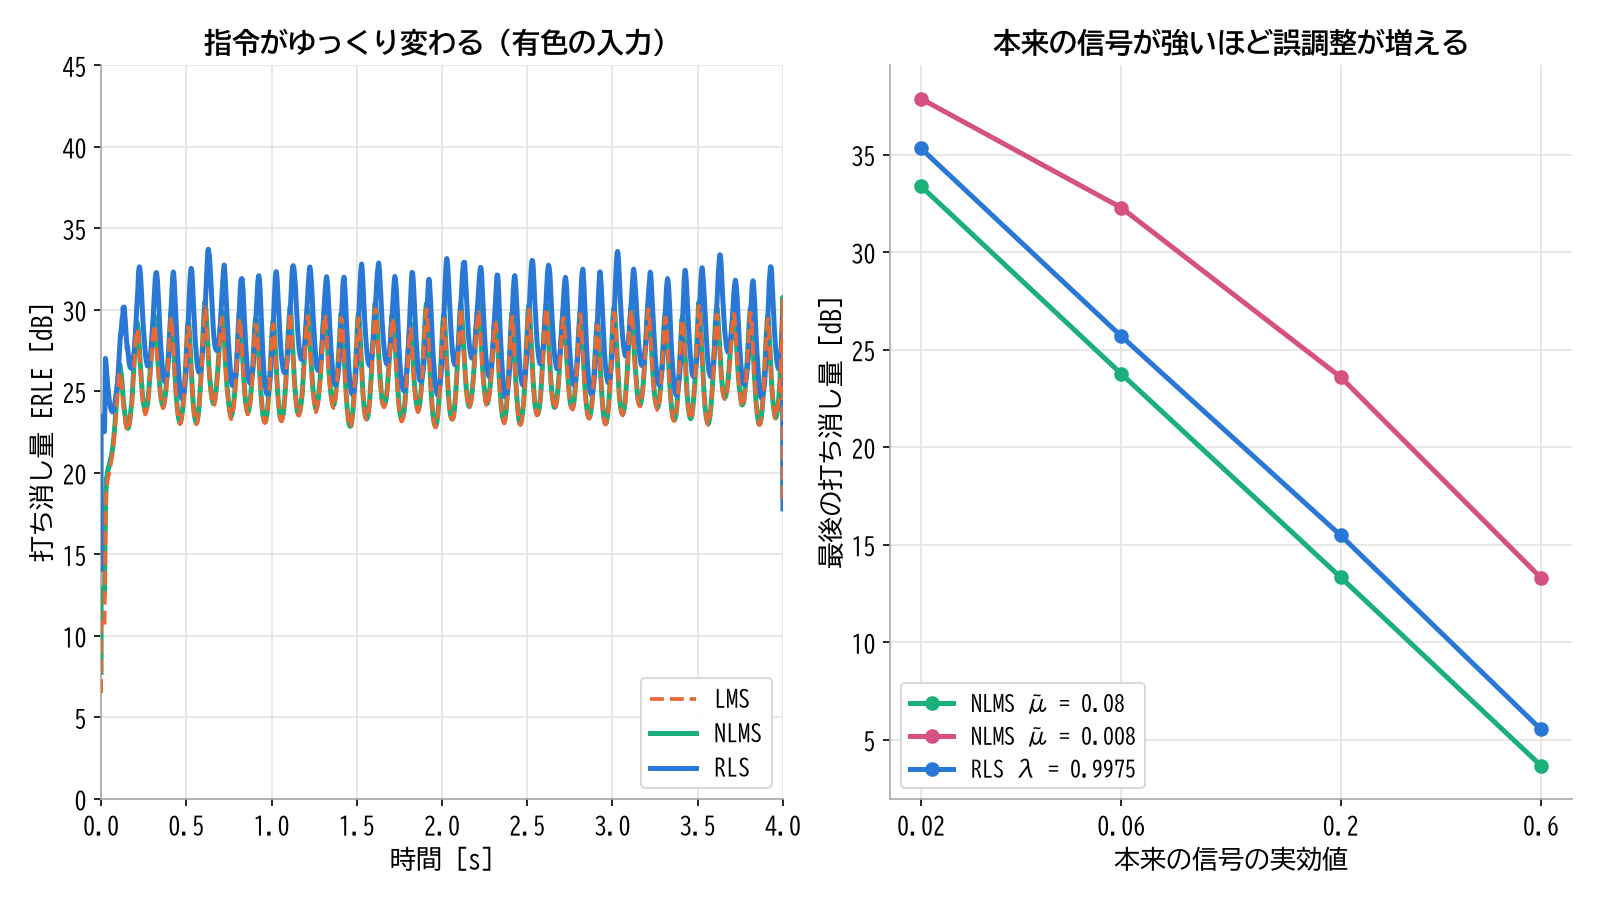
左:有色の入力でも打ち消しは効くが、経路そのものは当たらない。右:本来の信号が強いと、同じ μ̃ で打ち消し量が下がる
図の左の条件の数字です。
| 方式 | 20 dB までの時間 | 最後の ERLE | 係数の誤差 |
|---|---|---|---|
| LMS | 0.05 s | 25.6 dB | −7.8 dB |
| NLMS | 0.04 s | 25.7 dB | −10.0 dB |
| RLS | 0.02 s | 28.0 dB | −11.6 dB |
ERLE は 26 dB ほど出ているのに、係数の誤差は LMS で −7.8 dB しかありません。LMS と NLMS の係数の誤差の差は、最初の 32 サンプルの更新の違いが、入力の乏しい向きにそのまま残ったものです。打ち消しが効いていても、経路が当たっているとは限りません。 指令に含まれる周波数でだけ経路が合っていれば、消せるからです。消すだけならこれで足ります。ただし、別の指令に変わった瞬間に打ち消しが崩れます。経路そのものを知りたいなら、指令に微小な乱数を足すなどして入力を豊かにする必要があります。持続的励振の話です。
破る例 2:本来の信号が強い。 図の右です。信号が x と無相関でも、誤調整は J_{\min} 、つまり本来の信号の電力に比例します。
| 信号の実効値 | NLMS 0.08 | NLMS 0.008 | RLS 0.9975 |
|---|---|---|---|
| 0.02 | 33.4 dB | 37.9 dB | 35.3 dB |
| 0.06 | 23.8 dB | 32.3 dB | 25.7 dB |
| 0.2 | 13.3 dB | 23.6 dB | 15.5 dB |
| 0.6 | 3.7 dB | 13.3 dB | 5.5 dB |
実効値が 10 倍になると、打ち消し量は約 20 dB 下がります。 \tilde{\mu} を 1/10 にすると 10 dB 取り戻せますが、学習も 10 倍遅くなります。本来の信号は適応フィルタにとってはノイズです。 信号が強い区間では更新を止める、参照の帯域だけを通してから適応する、といった工夫が要ります。
設計例 3:参照が無いとき、遅延で作る ALE
要件。 回転機の振動の 1 本の線スペクトル(1 つの周波数に集中した成分)を、広帯域のノイズから取り出します。周波数は 40 秒で 120 Hz から 125 Hz へゆっくり動き、参照の信号はありません。振幅は 0.4 で、ノイズを合わせた入力の SNR(信号とノイズの電力比)は −10.9 dB です。
構成。 予測です。ALE(Adaptive Line Enhancer、適応線スペクトル強調器)と呼びます。入力を Δ サンプル遅らせて x にし、遅らせる前の入力を d にします。Widrow らの 1975 年の論文の「自己同調フィルタ」と、その付録で扱う線スペクトルの強調です。
なぜ参照なしで済むのか。周期的な成分は、遅らせても自分自身と相関が残ります。 一方、広帯域のノイズの相関は短いので、遅らせると切れます。Δ をノイズの相関の長さより長くすると、x と d で相関があるのは線スペクトルだけになります。適応フィルタは、x から d を当てようとして、線スペクトルの周波数に鋭い通過帯域を作ります。出力 y が線スペクトル、誤差 e がノイズです。
タップ数と μ̃。 ノイズは 8 サンプルの移動平均で相関の長さは 8 なので、Δ = 16 とします。M は周波数の分解能(おおよそ fs/M)と増幅の度合いで決まります。M = 64 とします。周波数の動きが遅いので \tilde{\mu} = 0.01 です。
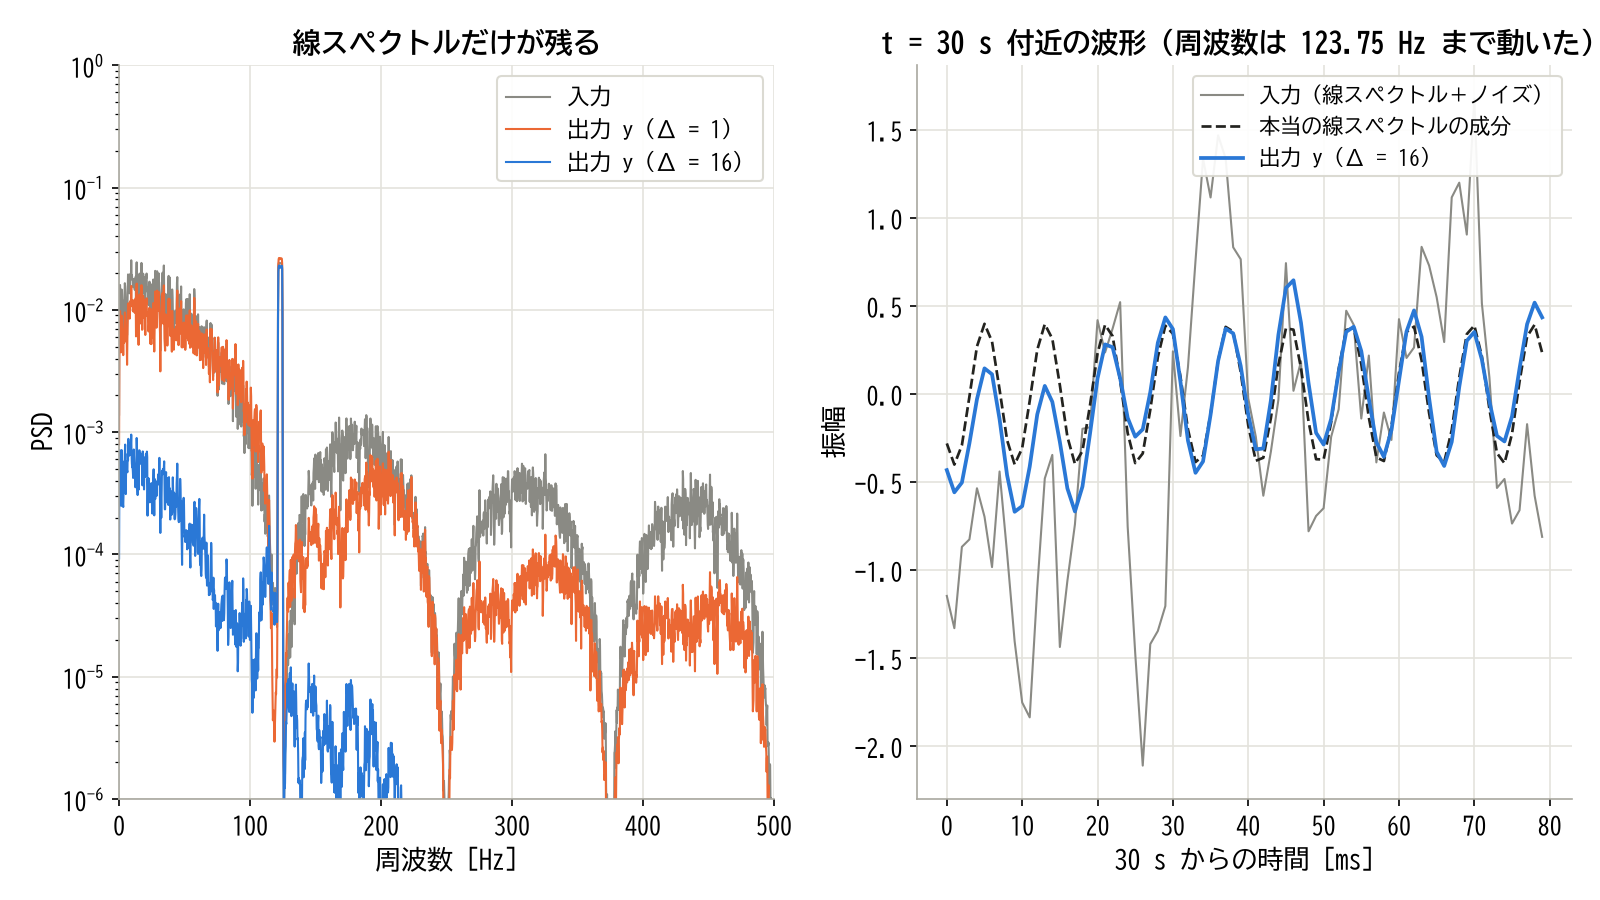
左:Δ = 16 ならノイズが下がって線だけが残る。Δ = 1 はノイズの相関が切れないので下がらない。右:30 秒付近の波形
t > 10 s の区間で、線の成分とノイズの成分を分けて測りました。
| Δ | 出力の SNR | 線のゲイン | ノイズの比 |
|---|---|---|---|
| 16 | +4.7 dB | 0.97 | −15.8 dB |
| 1 | −9.0 dB | 1.04 | −1.5 dB |
Δ = 16 では SNR が 15.6 dB 改善しました。周波数が動いても追従します。破る例の Δ = 1 は、ノイズの相関が残るので、ノイズの予測できる分まで出力へ通ります。 線の周波数そのものを求めたいときは、出力のピークを数えるか、#9 以降で扱う Goertzel で狙った周波数の振幅を測ります。
✅ 検証
適応フィルタは「動いているように見える」だけでは判定できません。真値が分かるシミュレーションでの検証を先に済ませ、次に実際の信号で測れる指標へ移ります。
誤調整:理論と計算
M = 16、白色ガウス入力、観測ノイズの電力 0.01 で、定常の誤差を 100 回平均して誤調整を求めました。
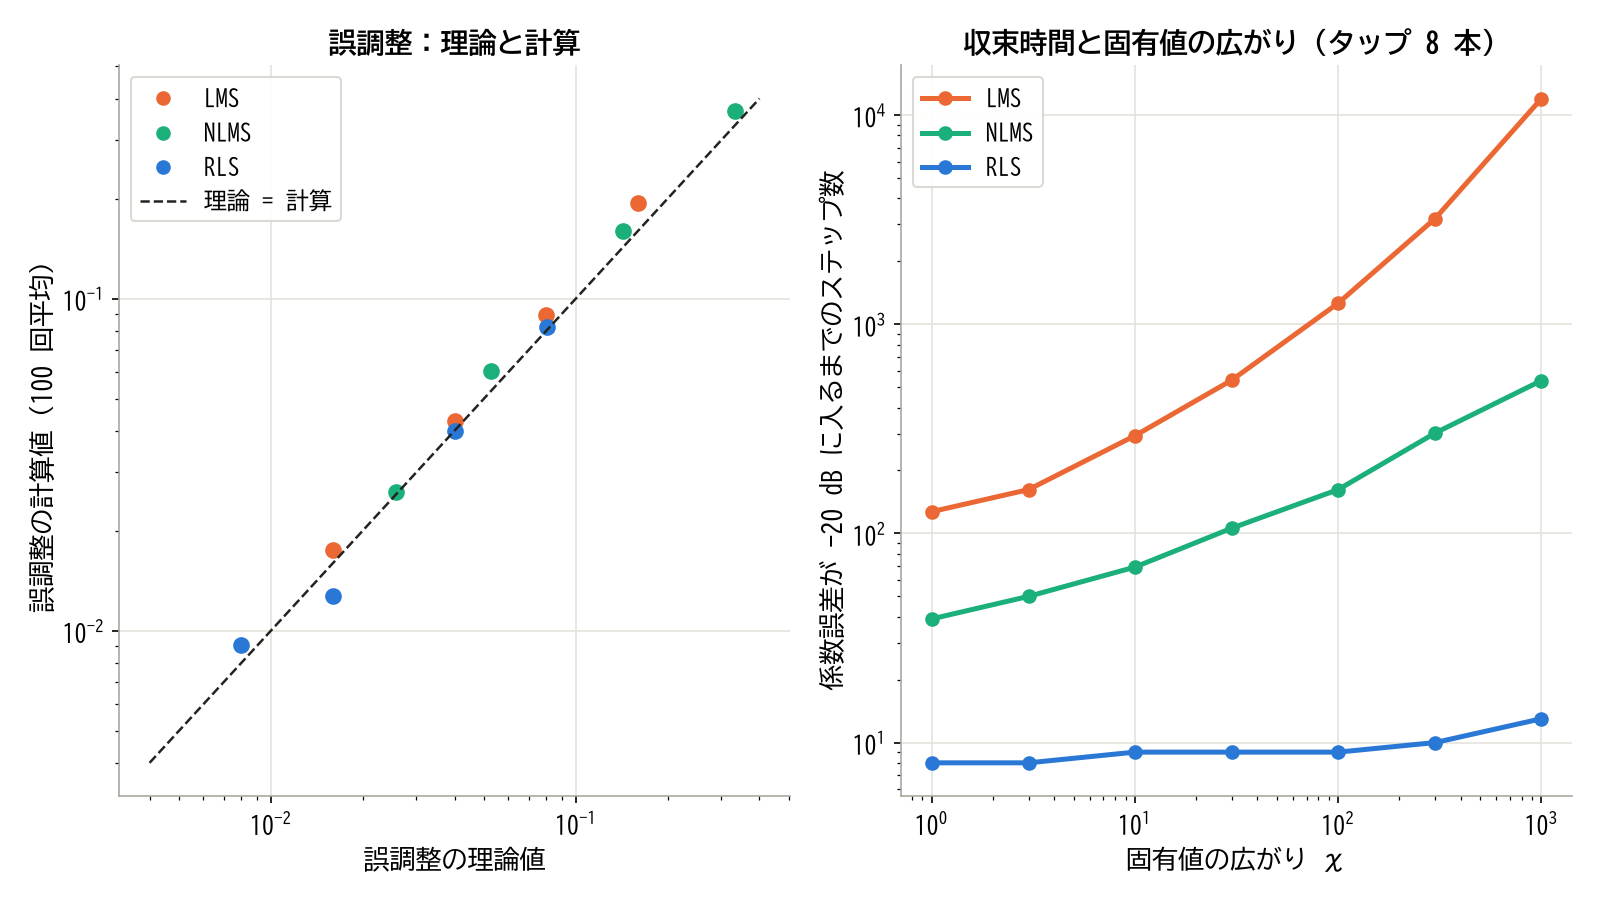
左:3 方式とも理論の式が 2 割以内で合う。右:RLS だけ固有値の広がりに関係しない
図の左の点を数字で並べます。
| 方式 | 設定 | 理論 | 計算 |
|---|---|---|---|
| LMS | μ = 0.002 | 0.016 | 0.017 |
| LMS | μ = 0.005 | 0.040 | 0.043 |
| LMS | μ = 0.01 | 0.080 | 0.089 |
| LMS | μ = 0.02 | 0.160 | 0.194 |
| NLMS | μ̃ = 0.05 | 0.026 | 0.026 |
| NLMS | μ̃ = 0.1 | 0.053 | 0.061 |
| NLMS | μ̃ = 0.25 | 0.143 | 0.160 |
| NLMS | μ̃ = 0.5 | 0.333 | 0.366 |
| RLS | λ = 0.999 | 0.008 | 0.009 |
| RLS | λ = 0.998 | 0.016 | 0.013 |
| RLS | λ = 0.995 | 0.040 | 0.040 |
| RLS | λ = 0.99 | 0.080 | 0.082 |
小さい μ の式は μ を大きくすると少し過小になります。NLMS の式は M が大きいときの近似で、M = 16 では 1〜2 割の過小です。いずれも μ の見当をつけるには十分です。
収束時間と固有値の広がり
M = 8 で入力の 1 次の自己回帰(1 つ前の値に定数を掛けてノイズを足す作り方)の定数を変え、χ を 1 から 1000 まで振りました。係数の誤差が −20 dB に入るまでのステップ数です。LMS は μ = 0.02、NLMS は \tilde{\mu} = 0.5 、RLS は λ = 0.9995 です。
| χ | LMS | NLMS | RLS |
|---|---|---|---|
| 1 | 127 | 39 | 8 |
| 10 | 293 | 69 | 9 |
| 100 | 1261 | 162 | 9 |
| 1000 | 12000 以上 | 538 | 13 |
LMS は χ が 10 倍になると 2〜4 倍遅くなり、1000 では 12000 ステップの中で入りませんでした。NLMS も遅くなります。RLS はほぼ一定です。
係数と残留スペクトルと結論の安定性
設計例では次も確かめました。
- 係数の誤差:真値が分かるシミュレーションで、 \|\mathbf{w}-\mathbf{w}_o\|^2/\|\mathbf{w}_o\|^2 を見る。ERLE が高くても悪い場合があるのは設計例 2 のとおり
- 残留スペクトル:e の PSD に、消したい線が残っていないかを Welch 法で見る
- μ を 2 倍、半分:設計例 1 で μ = 0.01、0.04 でも、残留ハムの順序は同じ。残留は −30.6 dB と −37.9 dB で、要件の −30 dB を満たす
- seed を 3 通り:設計例 1 の 4 タップで、残留ハムは −34.4〜−35.8 dB、信号の歪みは −26.9〜−27.0 dB。結論は変わらない
チェックリスト
- 手計算の 3 ステップが、自分のコードの出力と一致する
- 真値を知っている合成信号で、係数が真値へ収束する
- 学習曲線を 100 回平均し、定常の高さが J_{\min}(1+\mathcal{M}) の見積もりに合う
- μ を 2 倍と半分にしても、結論が変わらない。発散の近くで動かしていない
- 入力が止まる、電力が変わる、参照が途切れるといった異常のときの動きを確かめた
- 残留スペクトルと信号の歪みを別々に見て、必要な信号を削っていない
🕳️ 落とし穴
μ が大きすぎる
「μ の目安と本当の上限」の小節の図のとおり、 2/(MP_x) は使える上限ではありません。M = 8 では 0.18 で 76 % の回が発散しました。μ は入力の電力で決まるので、電力が読めない対象は NLMS にします。発散は 1 回の大きな入力をきっかけに起きることがあるので、短い試験では見つからないこともあります。
固有値の広がり
有色の入力で LMS が遅いときの対策は 3 つです。NLMS は電力の変動には効きますが、固有値の広がりには部分的にしか効きません。RLS は広がりの影響を消しますが、O(M²) です。前白色化は、入力に固定のフィルタを掛けてスペクトルを平らに近づけてから適応する方法で、O(M) のまま効きます。設計例 2 で指令の平均を引いたのも同じ発想です。平均が残ると、DC の向きに大きな固有値が 1 つ増えます。
誤調整と係数の揺らぎ
係数を見ると、定常でも揺れています。これはバグではありません。μ を下げると揺れは減りますが、追従は遅くなります。学習の初めは μ を大きく、落ち着いたら小さくする可変ステップも使えます。ただし固定小数点では、次の落とし穴に当たります。
固定小数点の LMS の停止現象
固定小数点では、更新量が係数の最下位ビット(LSB)の半分より小さいと、丸めで 0 になり、係数が動かなくなります。止まるのは誤差が小さくなった場所です。 誤差が次の大きさを下回ると更新がなくなります。
|e| < \frac{\mathrm{LSB}}{2\mu|x|}Gitlin、Mazo、Taylor の 1973 年の論文は、ディジタルの勾配アルゴリズムではアナログと違う現象が出ること、ステップサイズをむやみに下げてはいけないことを示しました。後の文献はこれを stalling(停止)と呼んでいます。
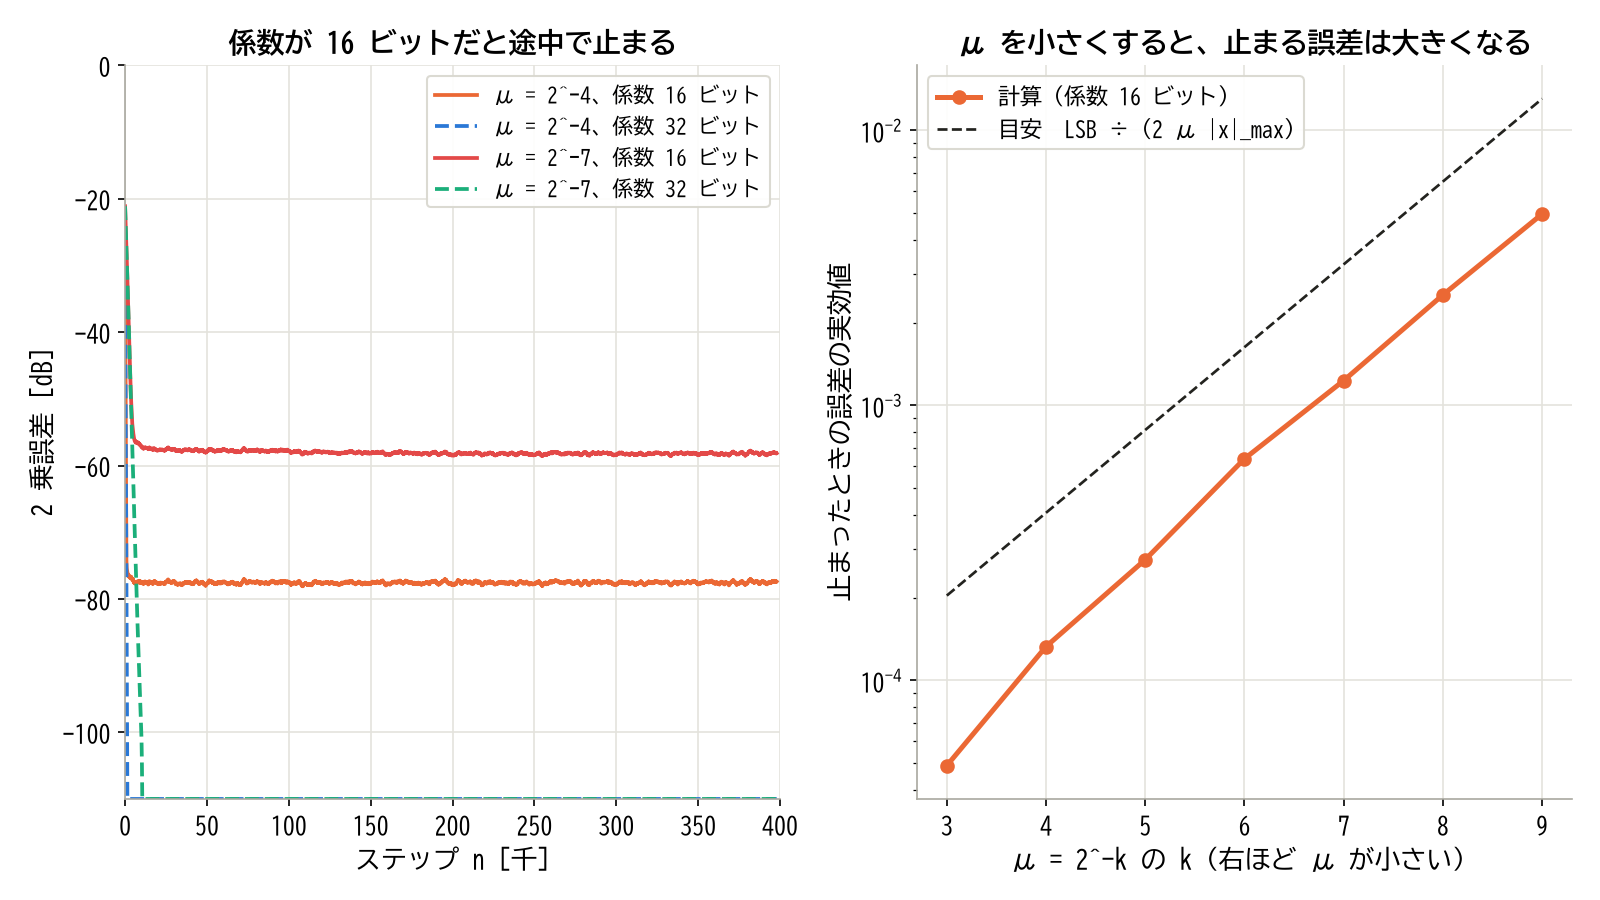
左:係数が 16 ビットだと途中で止まる。μ が小さいほど早い段階で止まる。右:止まる誤差は μ に反比例する
M = 4、ノイズなしの同定を Q15(1 を 32768 で表す 16 ビットの固定小数点。#1 を参照)で計算しました。入力は振幅 0.6 の一様乱数です。
| μ | 係数 16 ビット | 係数 32 ビット |
|---|---|---|
| 2^{-4} | −77.5 dB で停止 | 誤差 0 まで下がる |
| 2^{-7} | −58.2 dB で停止 | 誤差 0 まで下がる |
μ を 1/8 にすると止まる誤差は約 9 倍になり、悪くなります。 右の図の計算値は、 |x| に最大値 0.6 を入れた目安の 0.25〜0.4 倍の高さに、同じ傾きで並びました。対策は係数を演算より長い語長で持つことです。FIR の計算には上位 16 ビットだけを使い、更新は 32 ビットに積むと、この例では止まりません。
励起不足での係数のドリフト
入力の周波数成分が足りないと、R の固有値に 0 に近いものができます。その向きへは誤差が何も教えないので、係数はどこへ行っても誤差が変わりません。固定小数点の丸めに偏りがあると、その向きへ少しずつ流れます。これがドリフトです。漏れ LMS(leaky LMS)は、毎回係数を少し 0 へ引き戻します。
\mathbf{w}[n+1] = (1 - \mu\gamma)\,\mathbf{w}[n] + \mu\,e[n]\,\mathbf{x}[n]γ は小さな正の数(漏れの定数)です。
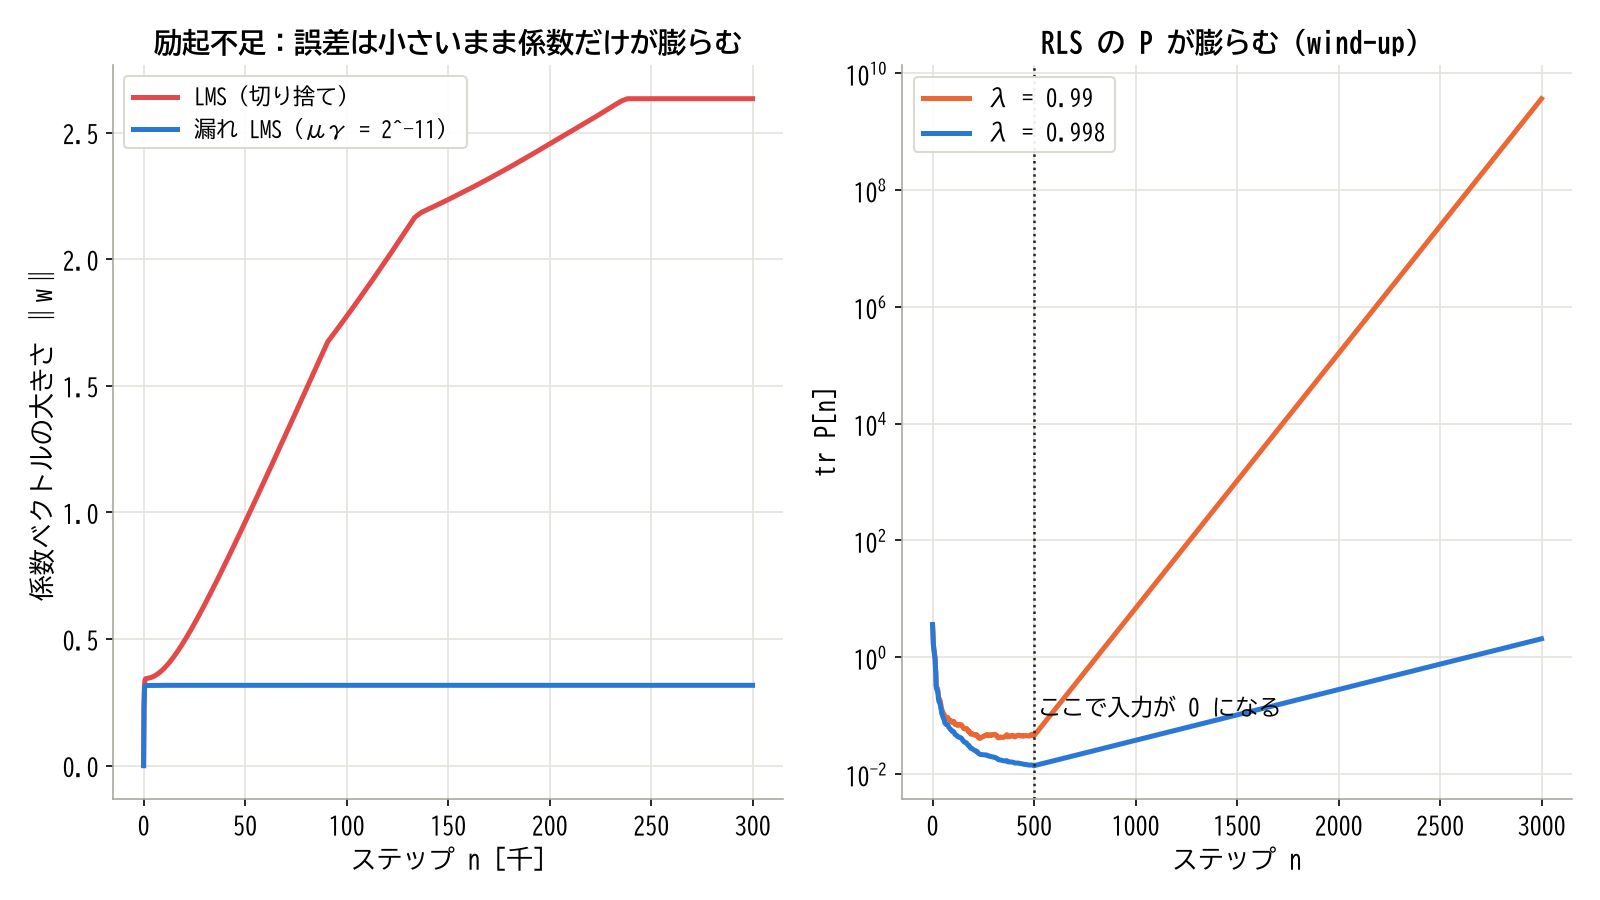
左:入力が正弦波 1 本だと、誤差が小さいまま係数だけが膨らむ。右:RLS は入力が止まると P が膨らみ続ける
M = 8 に正弦波 1 本を入れ、更新の丸めを切り捨て(算術右シフト)にした例です。係数の大きさは 300000 ステップで 2.63 まで増え、個々の係数が 1 で飽和するところで止まりました。その間の誤差の実効値は 0.003 と小さなままです。 \mu\gamma = 2^{-11} の漏れを入れると 0.32 で一定になります。代わりに誤差は 0.017 に増えます。漏れは解を 0 へ引くので、誤差に偏りが出るからです。
RLS の P の膨張と崩れ
RLS の手順 4 は、λ で割り続けます。入力が 0 だと K も 0 で、P は毎回 1/λ 倍になります。これが wind-up です。カルマンとの対応で読めば、「測定が無いのに不確かさだけが増える」状態です。
\mathbf{P}[n] = \lambda^{-(n-n_0)}\,\mathbf{P}[n_0]n₀ は入力が止まった時刻です。図の右は M = 4 の例で、λ = 0.99 では 2500 ステップで tr P(P の対角の和)が 0.045 から 3.7\times 10^{9} まで増えました。単精度の浮動小数点なら、この調子で約 9600 ステップであふれます。入力が戻った瞬間に P が大きいと、K が暴れます。
P は対称で正定値(どのベクトルで挟んでも正)でなければなりません。丸めでこれが崩れると、RLS は発散します。単精度で、正弦波にごく小さなノイズを足した入力(M = 8、λ = 0.95)を入れると、約 11000 ステップで正定値が崩れました。毎回 \mathbf{P} = (\mathbf{P}+\mathbf{P}^{\mathsf{T}})/2 で対称にしても、この例では崩れる時刻がほとんど変わりませんでした。励起が足りないこと自体が原因だからです。
対策は、入力の電力が小さい間は更新を止める、tr P に上限を決めて超えたら初期化する、倍精度を使う、QR 分解(行列を直交行列と三角行列に分ける計算)を使う RLS に替える、のいずれかです。QR を使う形は、Sayed と Kailath の論文の主題の 1 つです。
目標信号が参照に混ざる
干渉キャンセルは、信号が参照に入っていないことが前提です。参照に信号が混ざると、適応フィルタは信号まで「妨害」として引いてしまいます。Widrow らの論文は、参照に信号の成分があると、出力の SNR が悪化することを解析しています。マイクを 2 本使う騒音除去では、参照のマイクに声が入る距離だと声が削れます。ハムの例のように参照が電気的に別の経路で作れる場合は、この問題が起きません。
参照の遅れと因果性
FIR は過去の入力しか使えません。参照 x が妨害より遅れて届くと、当てられない部分が残ります。設計例 2 で参照を 6 サンプル遅らせると、NLMS の ERLE は 34 dB から 7.2 dB まで落ちました。経路の立ち上がりの部分を FIR が表せないからです。対策は参照を先に取ることか、d の側を遅らせることです。d を遅らせると、誤差の出力はその分遅れます。
💻 実装
式をコードにします。C は LMS、NLMS、固定小数点の LMS、Python は 3 方式を同じ形の関数にします。C は手計算と同じデータで Python と一致することを確かめました。
C:LMS と NLMS
#1 の biquad と同じく、状態を構造体に持って 1 サンプルずつ処理します。入力の履歴は循環バッファ(書き込み位置を回して使い回す配列)に持ちます。配列をずらさずに済みます。
#include <stdint.h>

#define LMS_M 32                     /* タップ数 */

typedef struct {
    float w[LMS_M];                  /* 係数 */
    float x[LMS_M];                  /* 入力の循環バッファ */
    int   head;                      /* 最新の入力の位置 */
    float mu;                        /* ステップサイズ */
    float eps;                       /* NLMS の正則化 */
} lms_t;

void  lms_init(lms_t *s, float mu, float eps);
float lms_step(lms_t *s, float x, float d, float *y);   /* 誤差 e を返す */
float nlms_step(lms_t *s, float x, float d, float *y);  /* 誤差 e を返す */
#include <string.h>

void lms_init(lms_t *s, float mu, float eps)
{
    memset(s, 0, sizeof(*s));
    s->mu = mu;
    s->eps = eps;
}

/* 入力を入れて y を計算する(M 回の積和) */
static float fir_push(lms_t *s, float x)
{
    s->head = (s->head == 0) ? LMS_M - 1 : s->head - 1;
    s->x[s->head] = x;
    float y = 0.0f;
    int i = s->head;
    for (int k = 0; k < LMS_M; k++) {
        y += s->w[k] * s->x[i];
        if (++i == LMS_M) i = 0;
    }
    return y;
}

/* w[k] += g * x[n-k](M 回の積和) */
static void update(lms_t *s, float g)
{
    int i = s->head;
    for (int k = 0; k < LMS_M; k++) {
        s->w[k] += g * s->x[i];
        if (++i == LMS_M) i = 0;
    }
}

float lms_step(lms_t *s, float x, float d, float *y)
{
    float yy = fir_push(s, x);
    float e = d - yy;
    update(s, s->mu * e);
    if (y) *y = yy;
    return e;
}

float nlms_step(lms_t *s, float x, float d, float *y)
{
    float yy = fir_push(s, x);
    float e = d - yy;
    float energy = s->eps;
    for (int k = 0; k < LMS_M; k++) energy += s->x[k] * s->x[k];
    update(s, s->mu * e / energy);
    if (y) *y = yy;
    return e;
}
LMS は 1 サンプルあたり積和が 2M 回です。M = 32 ならメモリは係数と履歴で 64 ワード、1 kHz で動かすなら毎秒 6 万 4000 回の積和です。NLMS は電力の和を毎回計算するので 3M 回です。先頭の新しい値を足して末尾の古い値を引けば定数回で済みますが、浮動小数点では丸めが積もるので、ときどき計算し直します。
固定小数点(Q15)の LMS
更新を Q31 の係数へ積むのが要点です。e と x の積は Q30 なので、1 ビット上げて Q31 にし、μ の分だけ右シフトします。
/* Q15 の LMS。係数は Q31 で持ち、FIR では上位 16 ビットだけ使う */
#define LMSQ_M 4
typedef struct {
    int32_t w[LMSQ_M];               /* Q31 */
    int16_t x[LMSQ_M];               /* Q15 */
    int     head;
    int     shift;                   /* μ = 2^-shift */
} lmsq_t;

void lmsq_init(lmsq_t *s, int shift)
{
    memset(s, 0, sizeof(*s));
    s->shift = shift;
}

static int16_t sat16(int32_t v)
{
    if (v > 32767) return 32767;
    if (v < -32768) return -32768;
    return (int16_t)v;
}

int16_t lmsq_step(lmsq_t *s, int16_t x, int16_t d)
{
    s->head = (s->head == 0) ? LMSQ_M - 1 : s->head - 1;
    s->x[s->head] = x;

    int64_t acc = 0;                               /* Q30 の和 */
    int i = s->head;
    for (int k = 0; k < LMSQ_M; k++) {
        acc += (int32_t)(s->w[k] >> 16) * (int32_t)s->x[i];
        if (++i == LMSQ_M) i = 0;
    }
    int16_t y = sat16((int32_t)(acc >> 15));
    int16_t e = sat16((int32_t)d - y);

    /* e・x は Q30。Q31 へ 1 ビット上げて μ = 2^-shift を掛ける。丸めは 0.5 LSB を足す */
    int sh = s->shift - 1;
    int32_t rnd = (sh > 0) ? (1 << (sh - 1)) : 0;
    i = s->head;
    for (int k = 0; k < LMSQ_M; k++) {
        int32_t prod = (int32_t)e * (int32_t)s->x[i];
        s->w[k] += (prod + rnd) >> sh;
        if (++i == LMSQ_M) i = 0;
    }
    return e;
}
右シフトの前に 0.5 LSB 相当を足して丸めます。素の算術右シフトは切り捨てで、負の方向へ偏るので、落とし穴で見たドリフトの原因になります。この関数は落とし穴の Q15 の例と同じ計算で、Python の整数計算と 10 万ステップの誤差の列が全部一致しました。
CMSIS-DSP と ESP-DSP
#1 と同じく、ライブラリの約束を確かめます。
CMSIS-DSP には arm_lms_f32() と arm_lms_norm_f32() があります。Q15、Q31 の版もあります。ドキュメントの要点は次のとおりです。
- 更新は
b[k] = b[k] + e[n] * mu * x[n-k]で、この記事の LMS と同じ。2 が付かない形 - NLMS は
mu/Eを掛ける。E は直近の電力の和で、この記事の \tilde{\mu} に当たる。ソースでは E に0.000000119209289fを足していて、これが ε - 係数は時間の逆順で格納する(
{b[numTaps-1], ..., b[1], b[0]})。この記事の w とは並びが逆 - 状態の配列の長さは
numTaps + blockSize - 1。ブロック単位で処理し、内部ではサンプルごとに更新する arm_lms_norm_f32()の入力の順は(S, pSrc, pRef, pOut, pErr, blockSize)で、pSrcが x、pRefが目標 d
arm_lms_q15() は係数も Q15 で持ち、更新は (alpha * x) >> 15 の切り捨てです(ソースの該当行)。つまり、落とし穴の停止現象とドリフトの条件に当たります。誤差の小さい領域まで下げたいときは、Q31 の版か float を使います。
ESP-DSP の API リファレンス(2026-11-07 時点)には、LMS や NLMS の関数はありません。FIR の dsps_fir_f32() はあるので、y の計算はこちらで書けますが、更新の部分は自分で書きます。
Python:LMS、NLMS、RLS
3 つとも同じ入出力にします。x、d、タップ数を渡すと、y、e、係数の履歴を返します。
import numpy as np


def regressor(x, M):
    """x[n], x[n-1], ..., x[n-M+1] を行に並べた配列を返す(n < 0 の x は 0)。"""
    x = np.asarray(x, dtype=float)
    X = np.zeros((len(x), M))
    for k in range(M):
        X[k:, k] = x[:len(x) - k]
    return X


def lms(x, d, M, mu, w0=None):
    """LMS。y, e, 係数の履歴を返す。w_hist[n] は n の更新の後の係数。"""
    X = regressor(x, M)
    w = np.zeros(M) if w0 is None else np.array(w0, dtype=float)
    y, e = np.zeros(len(d)), np.zeros(len(d))
    w_hist = np.zeros((len(d), M))
    for n in range(len(d)):
        y[n] = w @ X[n]
        e[n] = d[n] - y[n]
        w = w + mu * e[n] * X[n]
        w_hist[n] = w
    return y, e, w_hist


def nlms(x, d, M, mu, eps=1e-6, w0=None):
    """NLMS。mu は 0 より大きく 2 より小さい。"""
    X = regressor(x, M)
    w = np.zeros(M) if w0 is None else np.array(w0, dtype=float)
    y, e = np.zeros(len(d)), np.zeros(len(d))
    w_hist = np.zeros((len(d), M))
    for n in range(len(d)):
        y[n] = w @ X[n]
        e[n] = d[n] - y[n]
        w = w + mu * e[n] * X[n] / (eps + X[n] @ X[n])
        w_hist[n] = w
    return y, e, w_hist


def rls(x, d, M, lam=0.999, delta=0.01, w0=None):
    """RLS。lam は忘却係数、P の初期値は I / delta。"""
    X = regressor(x, M)
    w = np.zeros(M) if w0 is None else np.array(w0, dtype=float)
    P = np.eye(M) / delta
    y, e = np.zeros(len(d)), np.zeros(len(d))
    w_hist = np.zeros((len(d), M))
    for n in range(len(d)):
        u = X[n]
        Pu = P @ u
        K = Pu / (lam + u @ Pu)
        y[n] = w @ u
        e[n] = d[n] - y[n]
        w = w + K * e[n]
        P = (P - np.outer(K, Pu)) / lam
        P = 0.5 * (P + P.T)  # 丸めで対称性が崩れないように
        w_hist[n] = w
    return y, e, w_hist
手計算の値を確かめます。
x = np.array([1, 0.5, -0.5])
d = 0.6 * x + 0.2 * np.r_[0, x[:-1]]
np.set_printoptions(precision=6, suppress=True)
print("LMS ", lms(x, d, 2, 0.1)[2])
print("NLMS", nlms(x, d, 2, 0.5, eps=0)[2])
print("RLS ", rls(x, d, 2, lam=1.0, delta=0.01)[2][:2])
出力です。
LMS  [[0.06     0.      ]
 [0.0835   0.047   ]
 [0.092587 0.037913]]
NLMS [[0.3    0.    ]
 [0.37   0.14  ]
 [0.4125 0.0975]]
RLS  [[0.594059 0.      ]
 [0.595052 0.200469]]
LMS の w[3] が手計算の [0.0925875, 0.0379125]、NLMS が [0.4125, 0.0975]、RLS の w[1] が [0.594059, 0] で一致します。RLS は 2 ステップ目で [0.595052, 0.200469] です。学習曲線は、乱数を変えた 100 回の e ** 2 の平均です。
💡 活用事例
適応フィルタは、「途中の経路が人や環境で変わる」場面で使われてきました。分野ごとに、なぜ適応なのかを見ます。
- 電話のエコーキャンセラ:相手の声が回線の反射で戻るエコーを、声から学習して引く。経路は通話ごとに違うので固定にできない。システム同定と干渉キャンセルの形で、網の装置の要件は ITU-T G.168 に定められている
- 騒音を打ち消すヘッドホンやダクトの消音:騒音を逆位相の音で打ち消す能動騒音制御。空間の 2 次経路があるので FxLMS が基本(Kuo と Morgan の解説論文)。頭の位置や装着で経路が変わる
- モデムの等化器:通信路のゆがみを打ち消す。Lucky は 1965 年に、試験パルスを送って最急降下法でタップを合わせる自動等化を示した。電話回線ごとに特性が違うのが理由
- 心電図:Widrow らの 1975 年の論文は、電源のハムの除去と、母親の胸部の誘導を参照にした胎児の心電図の分離を示している。電極の位置で係数が変わるので適応が効く
- アダプティブアレイ:複数のアンテナの重みを学習して、妨害の方向の感度を下げる。Widrow らの 1967 年の論文が LMS をアンテナへ適用した。妨害の方向が分からないのが理由
- 振動制御:回転数に同期した参照で、機械の振動を打ち消す。設計例 1 の、回転数の版
どの例も、消したいものと相関のある信号が別に手に入ることが共通しています。逆に、参照も目標も作れない対象には向きません。
🧭 使い分けの勘所:LMS・NLMS・RLS
ここまでの結果を、判断の材料としてまとめます。方式を選ぶ前に、そもそも適応フィルタが要るのかから確かめます。
判断の軸
| 軸 | 調べること | 方向 |
|---|---|---|
| ① 信号の入手 | 目標信号 d があるか | 無ければ予測(ALE)か、適応以外 |
| ② 参照の有無 | 妨害と相関する信号があるか | あれば干渉キャンセル |
| ③ モデルの有無 | 状態方程式が書けるか | 書けるなら #5〜#7 |
| ④ 変化の速さ | 対象の特性は変わるか | 変わらないなら固定フィルタで足りる |
| ⑤ 入力の色 | 固有値の広がり χ | 10 倍を超えたら LMS は遅い |
| ⑥ 優先 | 速さか定常誤差か | 誤調整を先に決めて μ、λ を逆算 |
| ⑦ 計算とメモリ | O(M) か O(M²) か | M が大きければ NLMS |
| ⑧ 数の表現 | 固定小数点か | 係数を長い語長で持つ |
④が抜けがちです。一度測れば変わらない経路なら、測った係数で固定の FIR にするほうが軽く、誤調整もありません。適応フィルタを「キャリブレーションの間だけ動かす」のも良い使い方です。
⑤の χ は、入力の PSD の山と谷の比で見積もれます。M が小さければ、相関を計算して固有値を求めるのが確実です。
LMS・NLMS・RLS の比較
| 項目 | LMS | NLMS | RLS |
|---|---|---|---|
| 更新の調整 | μ | \tilde{\mu} | λ |
| 安定の範囲 | 2/((M+2)P_x) より十分下 | 0 < \tilde{\mu} < 2 | λ ≤ 1(数値の注意あり) |
| 収束 | χ に比例して遅い | χ で遅くなる | 約 2M で χ に依らない |
| 誤調整 | \mu MP_x/2 | \tilde{\mu}/(2-\tilde{\mu}) | (1-\lambda)M/(1+\lambda) |
| 積和の回数 | 2M | 3M | M² のオーダー |
| メモリ | 2M | 2M | M^2 + 2M |
| 電力の変化 | 弱い | 強い | 強い |
| 励起不足 | ドリフト | ドリフト | P が膨らむ |
| 固定小数点 | 長い語長で可 | 割り算が要る | 難しい |
| 向く場面 | 電力が一定、軽さ最優先 | 迷ったらこれ | M が小さく速さが要る |
計算の桁を見ます。M = 32 の場合、1 サンプルあたりの積和は LMS が 64 回、NLMS が 96 回で、RLS は単純に書くと P と x の積だけで 1024 回です。メモリは float で LMS が約 256 B、RLS が 4 KB を超えます。設計例 2 の LMS の 0.19 s と RLS の 0.03 s の差を、この負荷と引き換えにするかどうかの判断です。
決定木
同じ判断を 1 本の流れにします。上から順に答えていくと、読むべき回や方式に着きます。
帯域が決まっていて
変わらない?"] -->|はい| B["固定フィルタ
#2〜#4"] A -->|いいえ| C["状態方程式が
書ける?"] C -->|はい| D["#5 カルマン
#6 EKF、UKF
#7 パーティクル"] C -->|いいえ| E["参照か目標の
信号がある?"] E -->|ある| F["参照は
正弦波?"] E -->|ない| G["周期成分なら
ALE(遅延で作る)"] F -->|はい| H["2 タップの LMS
幅と時定数で
μ を決める"] F -->|いいえ| I["M と入力の色は?"] I -->|"M が小さく
速さが要る"| J["RLS"] I -->|それ以外| K["NLMS から
μ̃ = 0.1〜0.5"]
図の「状態方程式が書ける」は、モデルがあって Q、R も見積もれるという意味です。#7 の決定木の「モデルがない」の先が、この図の「いいえ」の側に当たります。
連載全体の早見表
#1 から #8 の方式を、モデルの有無と定常性の 2 軸で並べます。定常は、対象の性質が時間で変わらないことです。
| 区分 | 対象が変わらない | 対象が変わる |
|---|---|---|
| モデルなし、周波数が既知 | #2〜#4 の固定フィルタ | 参照つきの適応ノッチ(#8) |
| モデルなし、周波数も未知 | 一度学習して固定の FIR | LMS、NLMS、RLS(#8)、ALE(#8) |
| モデルあり、線形 | 定常カルマン(#5) | カルマン(#5)、Q を調整 |
| モデルあり、非線形 | EKF、UKF(#6) | EKF、UKF、PF(#6、#7) |
カルマンフィルタと適応フィルタは対立していません。RLS とカルマンの対応のとおり、適応フィルタは「FIR の係数」を状態にしたカルマンフィルタと読めます。対象の式が書けるならカルマン、書けないなら入出力の関係そのものを推定する、という違いです。
勘所
- まず NLMS から:電力が読めない対象で μ を調整する手間が省ける。 \tilde{\mu} は 0.1〜0.5 の範囲から試す
- 誤調整を先に決めて μ を逆算する:μ を試行錯誤するより、「定常の誤差の増えを 4 % まで」と決めるほうが速い
- 固有値の広がりを先に測る:χ が 10 未満なら LMS で足りる。100 を超えるなら NLMS でも遅く、RLS か前白色化を考える
- RLS は M が小さいときだけ:O(M²) に加え、P の膨張と崩れの対策が要る。M = 32 で速さが本当に要るかを問う
- 参照が正弦波なら、ノッチの式で設計する:μ は誤調整でなく、帯域幅 \mu A_r^2 f_s/(2\pi) と時定数 2/(\mu A_r^2) で決まる
- 打ち消しの量と経路の正しさは別物:設計例 2 では ERLE が 26 dB でも係数の誤差は LMS で −7.8 dB だった。経路そのものが要るなら入力を豊かにする
- 本来の信号はノイズとして効く:信号の電力の分だけ誤調整が増える。信号が強い区間は更新を止める
- 固定小数点の停止は語長の問題:止まったからといって μ を下げると悪化する。係数を 32 ビットで持つ
- 経路があるなら位相余裕を見る:FxLMS の推定の位相誤差は ±90° の内側に十分収める
✅ まとめ
- 適応フィルタは、誤差の 2 乗平均が小さくなるように FIR の係数を毎サンプル更新する。必要なのは対象の式ではなく目標信号で、構成は同定、逆モデル、予測、干渉キャンセルの 4 つ
- 2 乗平均誤差は係数の 2 次の碗で、底がウィーナー解 \mathbf{R}\mathbf{w}_o = \mathbf{p} 。最急降下は 0 < \mu < 2/\nu_{\max} で収束し、遅さは固有値の広がり χ で決まる。χ は入力のスペクトルの山谷の比
- LMS は勾配の期待値を 1 サンプルで置き換えた \mathbf{w} + \mu e\,\mathbf{x} 。誤調整は \mu MP_x/2 で、速さとの積はタップ数で決まる。 2/(MP_x) は使える上限ではなく、白色ガウスの 2 乗の上限は 2/((M+2)P_x)
- NLMS は事後誤差を 0 にする最小の変化量(射影)から出て、安定条件 0 < \tilde{\mu} < 2 が入力の電力に依らない
- RLS は忘却つきの最小 2 乗を逆行列の補題で逐次に解く。約 2M で収束し χ に依らないが O(M²)。カルマンの A = I、測定ノイズ分散 1、 Q = (1/\lambda-1)\mathbf{P} と厳密に一致する
- 適応ループは積分器を含むフィードバックで、1 タップなら \alpha = \mu P_x の 1 次ローパス。正弦波を参照にすると厳密にノッチで、帯域幅は \mu A_r^2 f_s/(2\pi)
- FxLMS は 2 次経路の推定の位相誤差が ±90° を超えると発散する。位相余裕は 90^\circ - |\psi|
- 50 Hz ハムの例では、Q = 30 の固定ノッチの −12.9 dB に対し、4 タップの LMS は −34.4 dB。周波数が揺れても谷が参照と一緒に動く
- 落とし穴は、大きすぎる μ、固定小数点の停止とドリフト、RLS の P の膨張、参照への信号の混入、参照の遅れ
ここまでで、係数を決める情報が無い対象に対して、構成を選び、μ や λ を式から決め、学習曲線と誤調整と ERLE で判定できるようになりました。次の一手は、手元の信号の PSD を測って χ を見積もり、この記事の Python の nlms に実際の x と d を入れて、まず固定の FIR で足りないのかを確かめることです。
ここまでの #1〜#8 で、固定のフィルタ、モデルのあるフィルタ、学習するフィルタがそろいました。次回の #9 以降は、「用途別のフィルタ」です。外れ値を落とすメディアンや Hampel、形を保つ Savitzky–Golay、1 つの周波数だけ測る Goertzel、波形を探す整合フィルタ、位相を 90° 回すヒルベルト、間引きの CIC など、目的がはっきりした道具を 1 つずつ見ていきます。
よくある質問(FAQ)
Q. LMS と NLMS は、どちらから始めればいいですか?
A. NLMS からです。安定の範囲が入力の電力に依らないので、 \tilde{\mu} を 0.1〜0.5 に置くだけで動きます。LMS が向くのは、入力の電力が一定で、割り算を避けたい場合です。積和は LMS が 2M 回、NLMS が 3M 回で、差は 1.5 倍です。
Q. μ はどう決めますか?
A. 誤調整から逆算します。LMS なら \mu = 2\mathcal{M}/(MP_x) 、NLMS なら \tilde{\mu} = 2\mathcal{M}/(1+\mathcal{M}) です。誤調整 10 % なら、NLMS の \tilde{\mu} は約 0.18 です。求めた値で収束が遅すぎるなら、速さと精度の積はタップ数で決まるので、タップ数を見直すか RLS を考えます。参照が正弦波なら、帯域幅と時定数から決めます。
Q. RLS が要るのはどんなときですか?
A. 入力が有色で固有値の広がりが大きく、しかも短い時間で収束する必要があり、タップ数が小さいときです。この記事の M = 8、χ = 100 の例で、−20 dB までは LMS(μ = 0.01)が 3043 ステップ、NLMS( \tilde{\mu} = 0.5 )が 215 ステップ、RLS が 14 ステップでした。M が数百になると O(M²) が重く、周波数領域の適応フィルタ(FFT でブロックごとにまとめて更新する方式)など別の方法が候補になります。
Q. 目標信号が無いときはどうしますか?
A. 周期的な成分なら、入力を遅らせて自分自身を目標にする ALE が使えます。参照も目標も作れないときは、適応フィルタの枠の外で、ブラインド等化のように信号の性質(振幅が一定など)を目標の代わりにする方法があります。通信では、最初だけ既知の訓練信号を送り、その後は判定した符号を目標に使います。
Q. IIR を適応させることはできますか?
A. できますが、FIR より難しくなります。IIR の係数は極を動かすので、学習の途中で不安定になることがあり、2 乗平均誤差の面も碗の形ではなくなって局所解が現れます。この記事で FIR に絞った理由がこれです。長い応答が必要なら、まず M を増やすことを考え、それでも足りないときに IIR の適応を検討します。
関連記事
この連載:
- #1 基礎編 — 伝達関数、FIR と IIR、白色ノイズの測り方、C の骨格
- #2 ローパスフィルタの設計 — 同じカットオフでの比較とナイキスト線図、位相余裕
- #3 ハイパスフィルタの設計 — DC とドリフトを消す
- #4 バンドパスとノッチの設計 — 固定のノッチと Q のトレードオフ
- #5 カルマンフィルタの設計 — RLS と対応する 5 本の式
- #6 EKF・UKF の設計 — 線形でない対象へ広げる
- #7 パーティクルフィルタの設計 — 分布をサンプルで持つ
- #9 以降 用途別のフィルタ(予定)
センサの入口:
- 加速度センサ KXR94-2050 で作るデジタル水平器 — ノイズの乗ったセンサの値を読む
参考
取得日はいずれも 2026-11-07 です。図と数値はすべて筆者が Python(NumPy、SciPy、Matplotlib)で計算したものです。乱数のシードは固定です。
LMS と適応フィルタの基本
- B. Widrow, M. E. Hoff「Adaptive Switching Circuits」(IRE WESCON Convention Record, Part 4, 96–104, 1960)
- B. Widrow, J. M. McCool, M. G. Larimore, C. R. Johnson「Stationary and Nonstationary Learning Characteristics of the LMS Adaptive Filter」(Proc. IEEE, 64(8), 1151–1162, 1976)
- L. L. Horowitz, K. D. Senne「Performance Advantage of Complex LMS for Controlling Narrow-Band Adaptive Arrays」(IEEE Trans. ASSP, 29(3), 722–736, 1981)
- A. Feuer, E. Weinstein「Convergence Analysis of LMS Filters with Uncorrelated Gaussian Data」(IEEE Trans. ASSP, 33(1), 222–230, 1985)
- S. Haykin「Adaptive Filter Theory」(Pearson)
- A. H. Sayed「Fundamentals of Adaptive Filtering」(Wiley-IEEE Press, 2003)
- B. Widrow, S. D. Stearns「Adaptive Signal Processing」(Prentice-Hall, 1985)
- U. Grenander, G. Szegő「Toeplitz Forms and Their Applications」(University of California Press, 1958)
NLMS と RLS
- J. Nagumo, A. Noda「A learning method for system identification」(IEEE Trans. Automatic Control, 12(3), 282–287, 1967)
- R. L. Plackett「Some Theorems in Least Squares」(Biometrika, 37(1/2), 149–157, 1950)
- A. H. Sayed, T. Kailath「A state-space approach to adaptive RLS filtering」(IEEE Signal Processing Magazine, 11(3), 18–60, 1994)
干渉キャンセルと適応ノッチ
- B. Widrow, J. R. Glover, J. M. McCool ほか「Adaptive Noise Cancelling: Principles and Applications」(Proc. IEEE, 63(12), 1692–1716, 1975)
- J. R. Glover「Adaptive noise canceling applied to sinusoidal interferences」(IEEE Trans. ASSP, 25(6), 484–491, 1977)
Filtered-x LMS と能動騒音制御
- D. R. Morgan「An analysis of multiple correlation cancellation loops with a filter in the auxiliary path」(IEEE Trans. ASSP, 28(4), 454–467, 1980)
- J. C. Burgess「Active adaptive sound control in a duct: A computer simulation」(J. Acoust. Soc. Am., 70(3), 715–726, 1981)
- B. Widrow, D. Shur, S. Shaffer「On Adaptive Inverse Control」(Asilomar Conf. on Circuits, Systems and Computers, 185–189, 1981)
- S. M. Kuo, D. R. Morgan「Active noise control: a tutorial review」(Proc. IEEE, 87(6), 943–975, 1999)
固定小数点
活用事例
- R. W. Lucky「Automatic Equalization for Digital Communication」(Bell System Technical Journal, 44(4), 547–588, 1965)
- B. Widrow, P. E. Mantey, L. J. Griffiths, B. B. Goode「Adaptive Antenna Systems」(Proc. IEEE, 55(12), 2143–2159, 1967)
- ITU-T G.168「Digital network echo cancellers」
ライブラリ