はじめに
#2 の移動平均と 1 次 IIR は、白色ノイズ(どの周波数にも同じ強さで広がる、サンプルごとに独立なノイズ)を均すには十分な道具でした。ところが、実際のセンサの値には、白色ノイズとは性質の違う乱れが混じります。I²C のセンサが読み取りに失敗して、ときどき 0 や 65535 を返す。分光器の走査で、知りたいのはピークの高さと位置なのに、平均するとピークが低く太くなる。この 2 つは、移動平均の 2 つの弱点にそのまま当たります。
- スパイク 1 個を、窓の幅の小山に広げる:移動平均は窓の中の値を等しく足すので、0 が 1 個来ると、窓が通り過ぎる間ずっと値が下がる
- 立ち上がりの角とピークの高さを削る:窓の中で平らにならすので、尖ったところほど低くなり、角は斜めの坂になる
次の図の左は、距離センサを 50 Hz で読んだ列に、0 が 2 回混じった場合です。右は、ステップのあとにピークが 1 つある波形です。
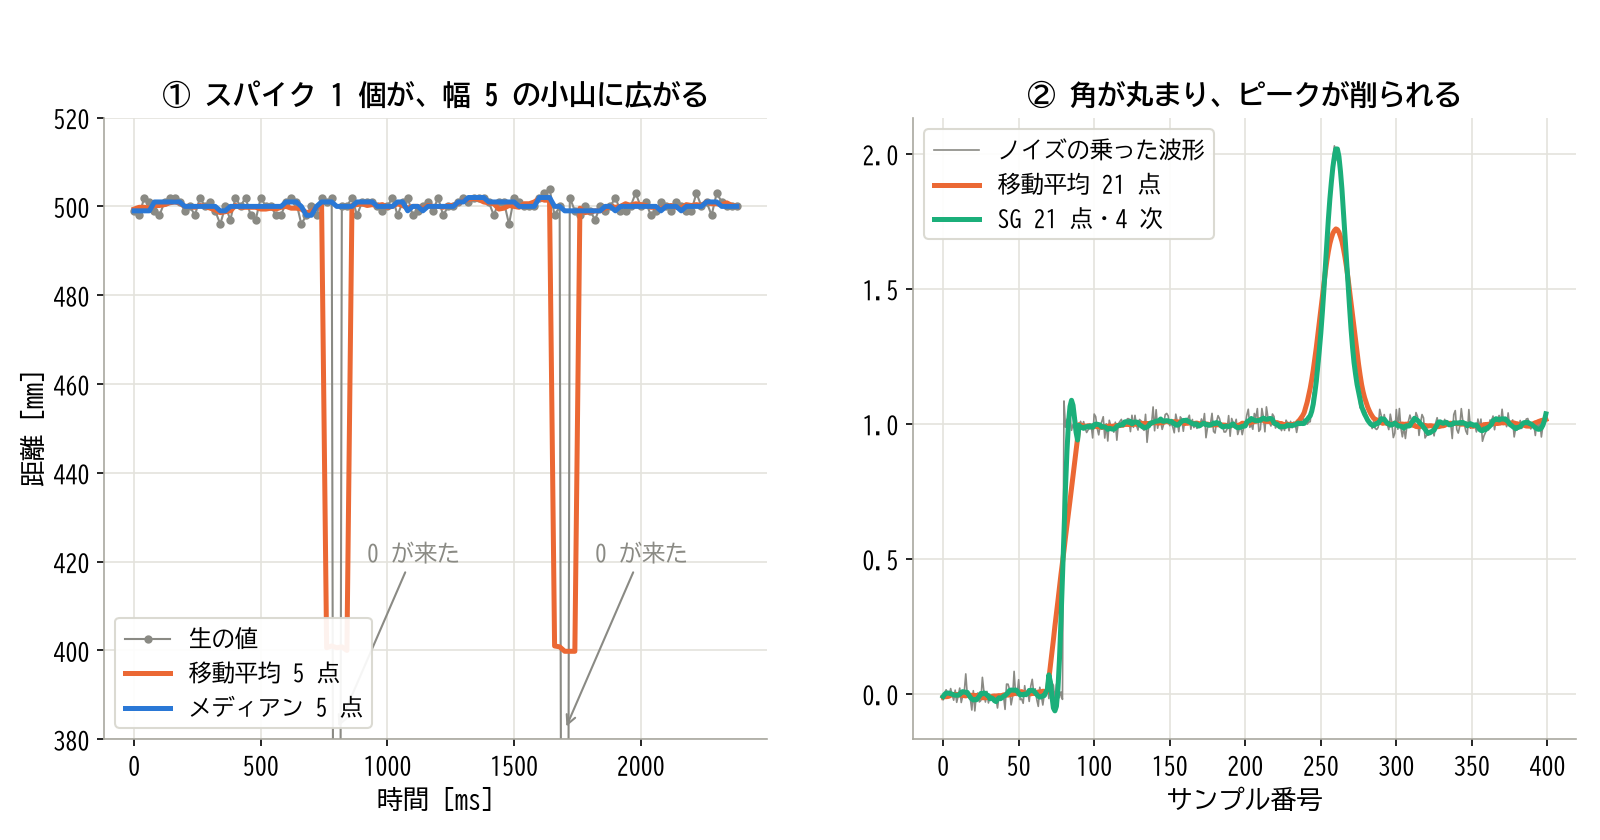
左:0 が 1 個来ると、移動平均は 5 サンプルの台形に広げる。メディアンは跳ね返さない。右:移動平均はピークを 3 割近く削る。SG は高さを保つ代わりに、ステップの前後に小さな波が立つ
左の図では、0 が来た瞬間に移動平均 5 点が 400 mm まで下がり、そのまま 5 サンプル(100 ms)台形を作っています。0 の 1/5 が平均に入るからです。メディアン 5 点は同じ場所を 500 mm のまま通ります。右の図では、高さ 1 のピークを移動平均 21 点が 0.72 まで削り、Savitzky–Golay(以下 SG)21 点 4 次は 1.02 で保っています。代わりに SG は、ステップの前後に小さな波を立てます。これも後で式から説明します。
この 2 つの弱点に対して、平滑化には 2 つの系統があります。
- 線形でない平滑化:メディアンフィルタと Hampel フィルタ。外れ値を「足さずに、選ぶ」ことで落とす
- 形を保つ線形の平滑化:Savitzky–Golay フィルタ。窓の中に直線ではなく多項式を当てはめて、ピークや傾きを残す
この記事のゴールは、手元の信号に外れ値があるのか、保ちたい形があるのかを見分けて、3 つのうちどれを使うかを決め、窓の長さとしきい値と次数を式と数値から決め、制御ループの中に入れてよいかを位相余裕で判定できるようになることです。メディアンの定理と分散の式から始めて Hampel、SG を 1 段ずつ導き、手計算で確かめ、周波数と制御工学の道具で読みます。そのうえで、センサの読み飛ばし、ピークの列、エンコーダの速度を設計します。実機は使わず、すべて計算と数値シミュレーションで示します。
- #1 基礎編 — サンプリング、伝達関数、ボード線図、効き目の測り方、C の骨格
- #2 ローパス — 移動平均、1 次 IIR、2 次バターワースを同じカットオフで比べる
- #3 ハイパス — DC とドリフトを消す
- #4 バンドパスとノッチ — Q と Audio EQ Cookbook で狙った周波数を扱う
- #5 カルマンフィルタ — モデルと分散で切り分ける
- #6 EKF・UKF — 線形でない対象へ広げる
- #7 パーティクルフィルタ — 分布をサンプルで持つ
- #8 適応フィルタ — 入力と誤差から係数を学習する
- #9 平滑化(この記事) — 外れ値を落とし、形を保つ
- #10 検出 — 周波数・波形・包絡線を取り出す
- #11 レート変換 — サンプリング周波数を変えるときのフィルタ
この記事で分かること: 平滑化がローパスと何が違うのか、メディアンがなぜスパイクを消して角を残すのか(ルート信号の定理)、そのかわりガウスノイズには移動平均よりどれだけ弱いのか(π/2 倍の分散)、Hampel フィルタの 1.4826 はどこから来るのか、量子化された整数の列でなぜ Hampel が誤作動するのか、SG の係数がなぜ閉じた形の FIR になるのか、SG は周波数で見ると何が得で何が損なのか、そしてこれらを制御ループに入れると位相余裕がどう変わるのかが分かります。
読み終えたときにできること: 外れ値の幅と保ちたい形から方式を選び、窓の長さを「スパイクの幅」「ピークの幅」「許せる遅れ」から決め、Python と C で動かせます。ルート信号のテスト、分散比、ピークの高さの誤差、位相余裕で設計を判定できます。
#1 の FIR と 群遅延、#2 の移動平均と制御ループの例を読んだ方を想定しています。ステップ n、サンプリング周期 T、サンプリング周波数 fs、伝達関数 H(z) は連載の記法のままです。この記事で新しく使う文字は、前の回と次のように区別します。
- k:この記事では窓の半幅。窓の長さは 2k+1。#2 の移動平均の長さ N は、奇数なら 2k+1 に当たる。#8 で和の添字に使った k ではない
- j:窓の中の位置(−k から k まで)。和の添字はこちらを使う
- q:SG の多項式の次数。Schafer の論文の N、SciPy の polyorder に当たる。#5 のプロセスノイズの Q ではない
- γ:Hampel のしきい値(σ̂ の何倍で外れ値とみなすか)。Pearson らの論文の t に当たる。時間の t と紛れないように文字を変えた
- L:外れ値が続くサンプル数。#8 の係数 w とは無関係
- c_j:SG の FIR の係数。#8 の係数 w に当たるもの
- V:SG の当てはめに使う行列。#5 の状態遷移の A ではない
m[n] は窓の中央値、MAD は中央値からの絶対偏差の中央値、σ̂ はその 1.4826 倍です。いずれも本文の最初に出る場所で定義します。
🧽 平滑化フィルタとは
平滑化(smoothing)は、ローパスとよく似た言葉ですが、評価の物差しが違います。定義を 1 文で書きます。
信号の意味のある形(角、ピーク、傾き)を保ったまま、ノイズと外れ値を減らすフィルタ。良し悪しを周波数ではなく、外れ値への反応と、形がどれだけ残るかという時間領域の性質で評価する。
ローパスは「何 Hz より上を落とすか」で設計しました。平滑化は「どの幅のスパイクを消すか」「どの幅のピークを残すか」で設計します。物差しが時間なので、窓の長さをサンプル数で決めるのが基本になります。
語をほどきます。
- 外れ値:ほかの値の並びから大きく外れた値。センサの読み取りの失敗、通信の化け、静電気の飛び込みなどで出る。この記事ではスパイクとも呼ぶ
- 窓:いま注目しているサンプルの前後 k 個ずつ、合わせて 2k+1 個の範囲。窓をずらしながら 1 個ずつ出力を作る
- 中央値(メディアン):値を小さい順に並べたときの真ん中の値。2k+1 個なら k+1 番目
- 線形:入力を足し合わせると出力も足し合わせになる性質。移動平均と SG は線形で、メディアンと Hampel は線形でない
- 頑健(ロバスト):一部のデータがひどく外れても、推定がほとんど動かない性質
3 つのフィルタを、それぞれ 1 文で定義します。
- メディアンフィルタ:窓の中の 2k+1 個の値の中央値を出力する
- Hampel フィルタ:窓の中央値 m と、外れ具合の物差し σ̂ を求め、真ん中の値が m から γσ̂ より離れていたときだけ m に置き換える。そうでなければ元の値をそのまま出す
- Savitzky–Golay フィルタ:窓の中の 2k+1 点に q 次の多項式を最小 2 乗(点との誤差の 2 乗の和が最小になるように係数を決める方法)で当てはめ、その多項式の中心での値(または微分)を出力する。係数が前もって計算できるので、FIR として動く
1 つの窓の中で 3 つが何をしているかを、次の図にまとめました。左と中央は 0 が 1 個入った同じ 7 個の値、右は山の形の 7 個の値です。
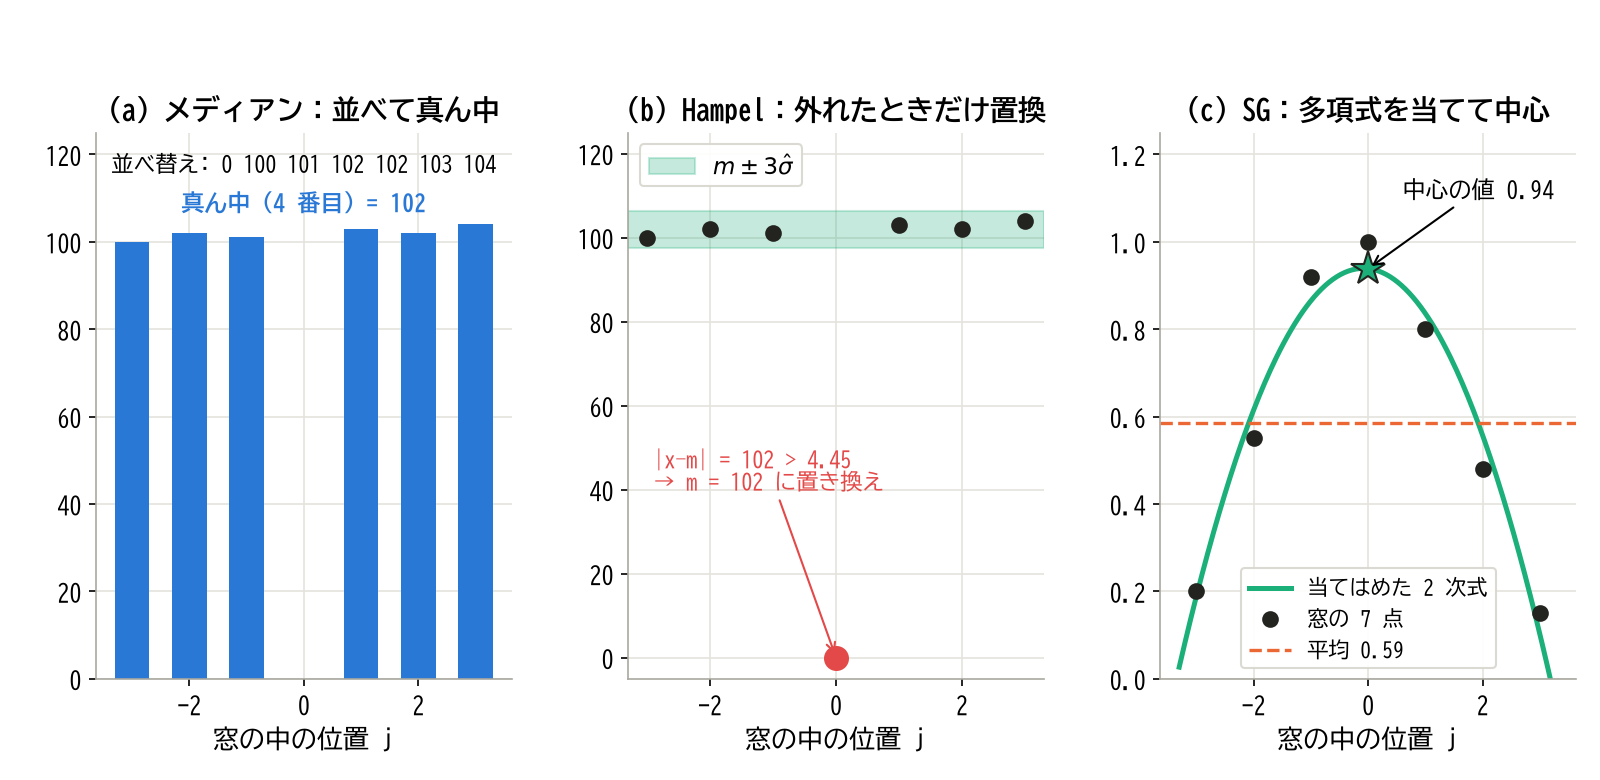
(a) メディアンは並べて真ん中を取る。(b) Hampel は帯(緑)の外にあるときだけ置き換える。(c) SG は多項式を当てて中心を読む。平均(オレンジの破線)より山の高さに近い
図の (a) では、0 は並べ替えると端に追いやられ、真ん中の 102 が選ばれます。0 がいくら極端な値でも、端に並ぶだけなので結果は変わりません。(b) の緑の帯は m ± 3σ̂ で、帯の外にある 0 だけを m に置き換えます。帯の中の値は触りません。(c) では、平均が 0.59 なのに対し、2 次式の中心の値は 0.94 で、真ん中の点 1.00 に近い値を返します。
何を渡すと何が返るのか
#2 の移動平均との差を並べます。メディアンと Hampel は、設計するものとピークの扱いだけが違うので 1 列にまとめました。
| 区分 | 移動平均 | メディアン、Hampel | SG |
|---|---|---|---|
| 線形か | 線形 | 線形でない | 線形 |
| 設計するもの | 長さ | 半幅 k(Hampel は γ も) | k と次数 q |
| スパイクへの反応 | 小山に広げる | 幅 k まで消す | 形を変えて残す |
| ピークの高さ | 削る | 平らにする(Hampel はほぼ保つ) | 保つ |
遅れは 4 つとも同じで、中心をそろえた窓を因果(過去と現在の値だけで計算する形)にすると、k サンプル遅れます。#2 の移動平均の遅れ (N−1)T/2 は、N = 2k+1 なら kT で、同じ式です。
名前の由来
メディアンフィルタは、統計学者の Tukey が 1974 年の EASCON の講演要旨「Nonlinear (nonsuperposable) methods for smoothing data」で導入したとされています(Pearson ほか 2016 の説明による)。Tukey の 1977 年の著書『Exploratory Data Analysis』は、データを手で眺めて傾向をつかむための方法をまとめた本で、平滑化もその道具の 1 つです。Rabiner らは 1975 年に、この Tukey の非線形平滑化(メディアンと線形のフィルタの組み合わせ)を音声処理へ応用しています。
Hampel フィルタの名は、頑健統計の Hampel にちなみます。Hampel は 1974 年の論文で影響関数(1 個のデータが推定をどれだけ動かすかを表す関数)を論じ、頑健な推定の理論の土台を作りました。外れ値を中央値と MAD で判定する方法は、Davies と Gather の 1993 年の論文が「Hampel の提案に基づく外れ値の判定法」として与えています。これを窓をずらしながら回すのが Hampel フィルタで、Pearson は 2002 年の論文で、プロセスの同定のデータを掃除する道具として紹介しています。Pearson らの 2016 年の論文「Generalized Hampel Filters」は、Hampel フィルタをメディアンフィルタの一般化として整理しました。
Savitzky–Golay フィルタは、Savitzky と Golay が 1964 年に Analytical Chemistry 誌に発表した論文「Smoothing and Differentiation of Data by Simplified Least Squares Procedures」に由来します。分析化学の測定データを平滑化し、微分するための方法で、係数の表をつけて「最小 2 乗を毎回解かなくても、表の数を掛けて足すだけで済む」ことを示しました。Schafer の 2011 年の解説「What Is a Savitzky–Golay Filter?」は、これを信号処理の言葉で、周波数特性から読み直しています。
前提
この記事の方法がうまく働くのは、次の条件がそろうときです。
- 外れ値の幅が半幅 k 以下:続けて来る外れ値が k 個までなら、メディアンと Hampel で消せる
- 意味のある形が窓より広い:ピークや段差の幅が窓より十分広ければ、SG はその形を保てる
- サンプリングが等間隔:SG の係数は、点が等しい間隔で並ぶことを前提に前もって計算している
- ノイズが外れ値と区別できる:普段のばらつきが外れ値より十分小さい
1 が破れたときと 2 が破れたときに何が起きるかは、それぞれの節と設計例で「破る例」として見ます。
🔢 メディアンフィルタ
メディアンフィルタは、足さずに選ぶフィルタです。この節では、定義から始めて、何が残り何が消えるかを決める定理、ガウスノイズに対する弱さ、周波数で見た姿を順に見ます。
定義と遅れ
窓の中の 2k+1 個の中央値を出します。中心をそろえた形と、因果な形を並べます。
\begin{aligned} y[n] &= \operatorname{median}(x[n-k], \dots, x[n+k]) \\ y_c[n] &= \operatorname{median}(x[n-2k], \dots, x[n]) \\ &= y[n-k] \end{aligned}| 記号 | 意味 |
|---|---|
| y[n] | 中心をそろえた出力(後で処理するとき) |
| y_c[n] | 因果な出力(届いた値から順に処理するとき) |
| k | 窓の半幅。窓の長さは 2k+1 |
| median | 小さい順に並べた k+1 番目 |
因果な形は、中心の形をちょうど k サンプル遅らせたものです。2 行目の等号は、窓の範囲を k だけずらしただけなので、定義から出ます。リアルタイムで使うなら、遅れは kT です。窓の長さを奇数にしているのは、真ん中の値が 1 個に決まるようにするためです。偶数にすると真ん中の 2 個の平均を取る流儀が要り、出力が入力にない値になります。
ルート信号の定理
移動平均は、ほとんどの信号を少しずつ変えます。メディアンフィルタには、何回掛けても変わらない信号があります。これをルート信号(root signal、根信号)と呼びます。どんな信号がルートになるかは、Gallagher と Wise が 1981 年に必要十分条件として示しました。定理として書くために、部品の言葉を 2 つ決めます(Pearson ほか 2016 の整理による)。
- 一定の区間:同じ値が k+1 個以上続く区間
- エッジ:単調に増えるか減る区間で、前後を値の違う一定の区間に挟まれたもの
窓 2k+1 のメディアンフィルタで変わらない信号は、一定の区間とエッジだけでできている信号に限られる。また、メディアンフィルタをくり返し掛けると、どんな有限長の信号も有限回でルート信号に落ち着く。長さ L の信号なら、くり返しは最大でも (L−2)/2 回で済む。
Gallagher と Wise は、この条件を「信号が局所的に単調であること」と表現しています。定理からすぐに 3 つの性質が出ます。
- ステップは角を保ったまま通る:段差の前後は一定の区間で、段差そのものは長さ 0 のエッジなので、ルート信号そのもの
- 幅 k 以下のパルスは消える:パルスの前後は同じ値の一定の区間で、パルスは一定の区間にもエッジにもならない。窓 2k+1 のうち、パルスの値は多くて k 個しかないので、中央値は周りの値になる
- 幅 k+1 以上のパルスは残る:k+1 個続けば、それ自体が一定の区間になる
2 と 3 は、数え方で確かめられます。パルスの真ん中に窓を置くと、窓の 2k+1 個のうちパルスの値が L 個、周りの値が 2k+1−L 個です。中央値がパルスの値になるのは、パルスの値が過半数、つまり L \ge k+1 のときだけです。
次の図は、窓 5(k = 2)で 4 種類の入力を、移動平均 5 とメディアン 5 に通したものです。
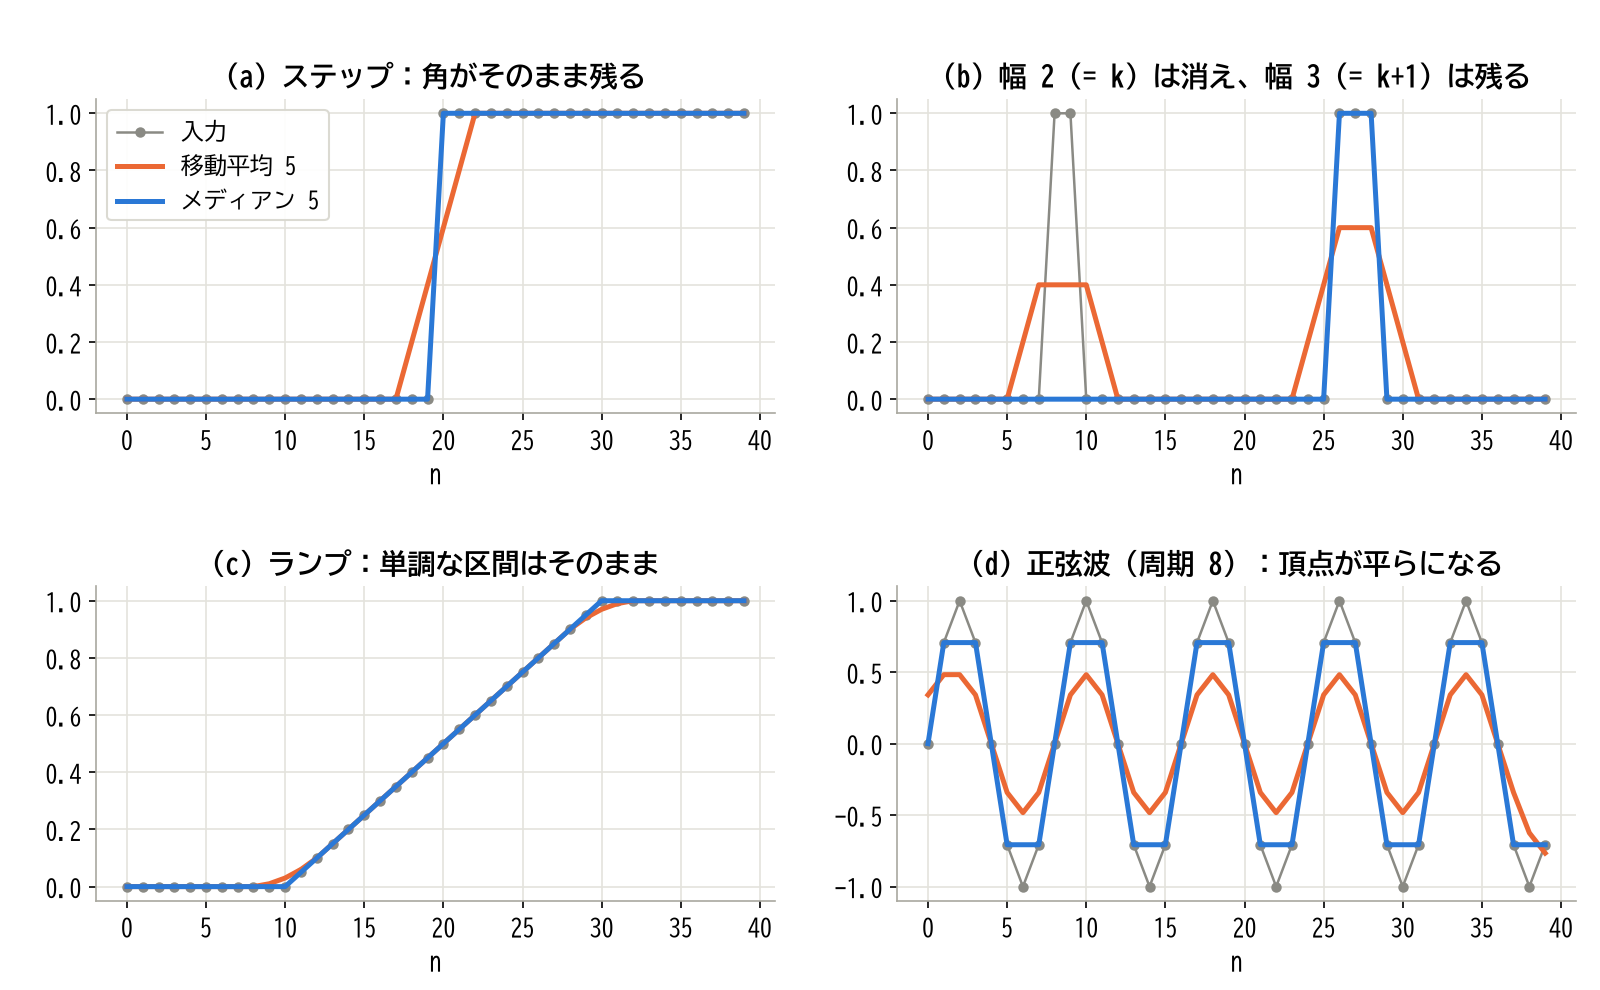
(a) ステップは角まで残る。(b) 幅 k = 2 は消え、幅 k+1 = 3 は残る。(c) 単調な坂は変わらない。(d) 正弦波は頂点が切られて台形になる
図の (a) と (c) で、青のメディアンは入力とぴったり重なっています。数値でも、ステップとランプの誤差は 0 でした。(b) の左の幅 2 のパルスは跡形もなく消え、右の幅 3 は形を変えずに残ります。移動平均(オレンジ)は、どちらも高さを 0.4、0.6 に下げた台形に広げます。
(d) は、ルート信号ではない例です。周期 8 の正弦波は、頂点の近くで単調な区間が短く、局所的に単調ではありません。メディアンを通すと、頂点の 3 点が 0.71( \sin 45^\circ )にそろって平らになります。メディアンは「振幅を下げる」のではなく「形を変える」ことがわかります。
くり返しで落ち着く様子も確かめました。長さ 200 のガウスノイズに窓 5 のメディアンをくり返し掛けると、6 回目で変わらなくなりました。定理の上限 (200−2)/2 = 99 回よりずっと早く止まっています。
ガウスノイズに対する分散
メディアンは外れ値に強い反面、普通のガウスノイズを減らす力は移動平均より弱くなります。これも式で言えます。
密度 g の分布から独立に取った n 個の値の中央値は、n が大きいとき、真の中央値 μ のまわりに分散 1/(4n,g(\mu)^2) の正規分布に近づく。
ここで密度(確率密度関数)は、その値の近くにデータが来やすい度合いを表す関数です。ガウス分布(分散 σ²)なら g(\mu) = 1/(\sigma\sqrt{2\pi}) なので、n = 2k+1 を入れると次の形になります。
\begin{aligned} \operatorname{Var}[\text{中央値}] &\approx \frac{2\pi\sigma^2}{4(2k+1)} \\ &= \frac{\pi}{2}\cdot\frac{\sigma^2}{2k+1} \\ \operatorname{Var}[\text{平均}] &= \frac{\sigma^2}{2k+1} \end{aligned}| 記号 | 意味 |
|---|---|
| σ² | 入力のガウスノイズの分散 |
| 2k+1 | 窓の長さ(中央値を取る個数) |
| π/2 | 中央値の分散と平均の分散の比(約 1.571) |
同じ窓なら、メディアンの出力の分散は移動平均の約 π/2 倍です。言いかえると、移動平均と同じだけノイズを減らすには、窓を約 1.57 倍に伸ばす必要があります。統計の言葉では、ガウス分布での中央値の効率(平均と同じ精度を出すのに要るデータの数の比)は 2/π、約 64 % です。
ただし、これは窓が長いときの式です。窓が短いと比はもう少し小さく、計算では窓 3 で 1.35、窓 5 で 1.44、窓 9 で 1.49、窓 51 で 1.55 でした。図は次の小節にあります。
ガウス分布で負けるなら、中央値が勝つ分布もあるはずです。代表がラプラス分布(両側に指数関数で減る、裾の重い分布)です。密度 g(x) = e^{-|x-\mu|/b}/(2b) を定理に入れると g(\mu) = 1/(2b) で、中央値の分散は b^2/n になります。平均の分散はラプラス分布の分散 2b² を n で割った 2b^2/n なので、中央値の分散は平均の半分です。
しかも、ラプラス分布では中央値が最尤推定(データが出てくる確率が最も高くなるように値を選ぶ推定)そのものです。データ x_1, \dots, x_n の対数尤度は -\sum |x_i - \mu|/b に定数を足したものなので、これを最大にする μ は、絶対値の和 \sum |x_i - \mu| を最小にする μ です。絶対値の和を μ で微分すると「μ より大きい値の個数 − 小さい値の個数」になり、これが 0 になるのは中央値です。ガウス分布で 2 乗の和を最小にすると平均が出るのと、対になっています。
白色ノイズを通したときの PSD
メディアンは線形でないので、伝達関数がありません。それでも、白色ノイズを通した出力の PSD(パワースペクトル密度、周波数ごとのパワーの分布。#1)を測れば、どの帯域を通しているかは読めます。#7 のパーティクルフィルタと同じ流儀で、100 回の結果を平均しました。
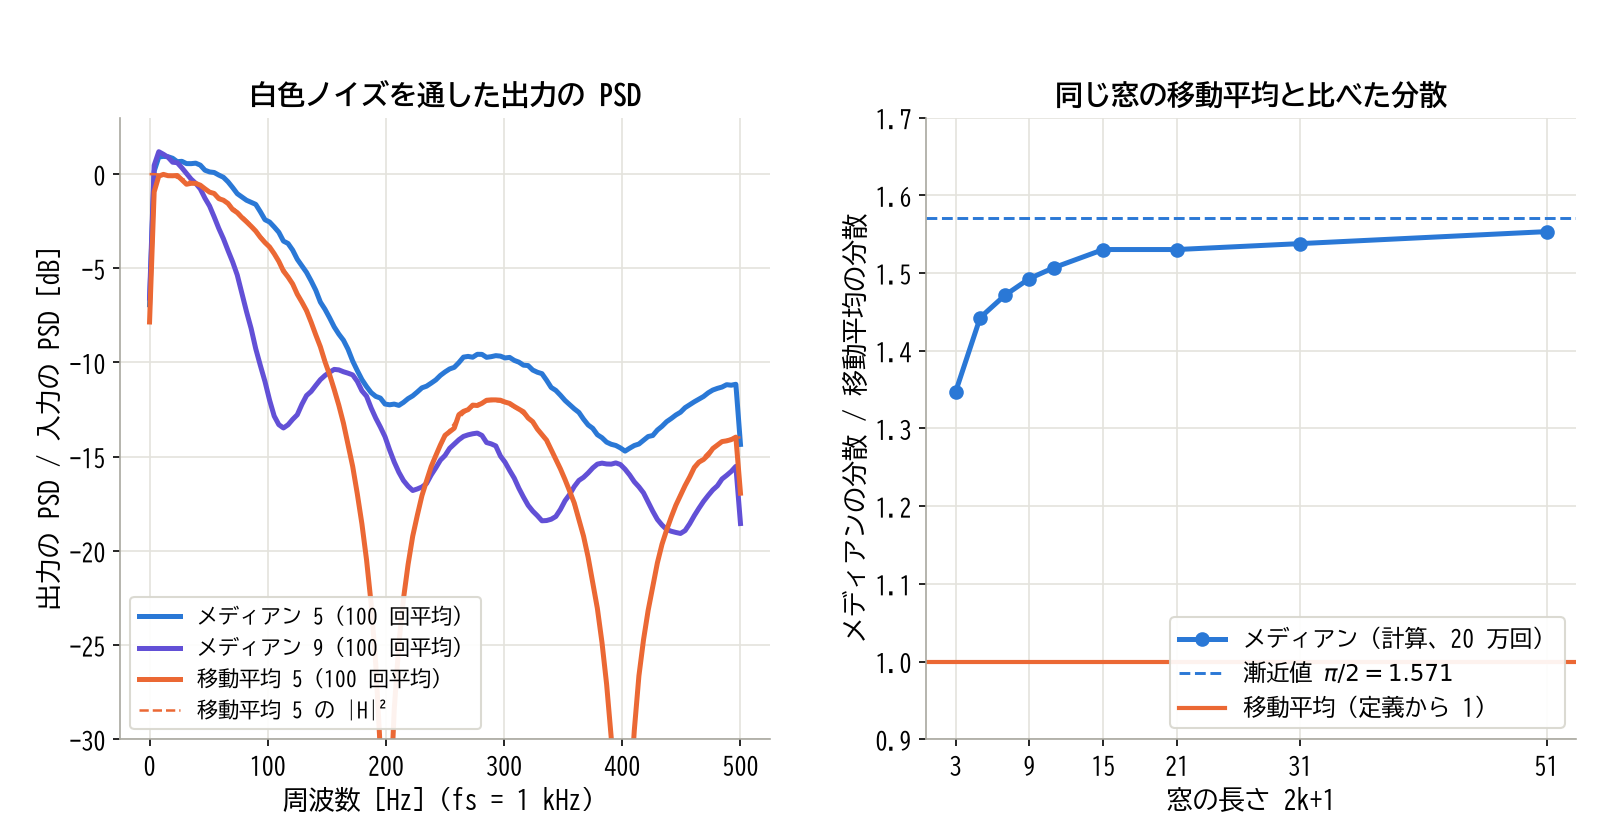
左:メディアン 5(青)は、移動平均 5(オレンジ)より高い周波数まで通し、谷も作らない。右:分散の比は窓が長いほど π/2 に近づく
左の図で、移動平均 5 は 200 Hz と 400 Hz に谷(零点)を持ちますが、メディアン 5 には谷がありません。300 Hz より上の平均は、移動平均 5 が −16.2 dB、メディアン 5 が −12.1 dB です。メディアンは高い周波数のノイズを、同じ窓の移動平均ほどは落としません。もう 1 点、低い周波数でメディアン 5 の値が 0 dB をわずかに超えています。移動平均のように DC ゲインが 1 の線形フィルタなら、0 Hz の値はちょうど 1 で、それを超えることはありません。これは線形でないことの表れで、メディアンの出力は隣どうしの相関が強く、ゆっくりした揺らぎが少し増えます。
右の図は、前の小節の π/2 の定理の確かめです。窓を伸ばすほど、比は π/2 = 1.571 に近づいていきます。
手計算:窓 5 で 3 ステップ
数列 x = (100, 102, 101, 0, 103, 102, 104, 101, 103) に、窓 5(k = 2)のメディアンを掛けます。添字は 0 から数え、x[3] = 0 が読み飛ばしです。
n = 2: 窓は x[0..4] = (100, 102, 101, 0, 103)。並べると (0, 100, 101, 102, 103) で、3 番目は 101。
n = 3: 窓は x[1..5] = (102, 101, 0, 103, 102)。並べると (0, 101, 102, 102, 103) で、3 番目は 102。0 は端に追いやられた。
n = 4: 窓は x[2..6] = (101, 0, 103, 102, 104)。並べると (0, 101, 102, 103, 104) で、3 番目は 102。
同じ n = 3 で移動平均 5 を取ると (102 + 101 + 0 + 103 + 102)/5 = 81.6 で、0 が来た 1 サンプルが 20 も値を下げます。この 3 つの値は、実装の節の Python の出力と一致します。
🎯 Hampel フィルタ
メディアンは外れ値を消しますが、外れ値でない値まで中央値に置き換えます。正弦波の頂点を平らにしたのはこのためです。Hampel フィルタは「外れ値だと判定したときだけ置き換える」ことで、この副作用を抑えます。判定に使う物差しが MAD です。
定義
窓の中央値 m[n] と、各値の m[n] からのずれの絶対値の中央値 MAD[n] を求めます。
\begin{aligned} m[n] &= \operatorname{median}_{|j| \le k}\, x[n+j] \\ e_j &= \bigl|x[n+j] - m[n]\bigr| \\ \operatorname{MAD}[n] &= \operatorname{median}_{|j| \le k}\, e_j \\ \hat\sigma[n] &= 1.4826\,\operatorname{MAD}[n] \end{aligned} y[n] = \begin{cases} m[n] & |x[n] - m[n]| > \gamma\,\hat\sigma[n] \\ x[n] & \text{それ以外} \end{cases}| 記号 | 意味 |
|---|---|
| m[n] | 窓 2k+1 個の中央値 |
| e_j | 窓の各値の m[n] からのずれの絶対値 |
| MAD[n] | e_j の中央値 |
| σ̂[n] | MAD から見積もった標準偏差 |
| γ | しきい値(σ̂ の何倍で外れ値とするか) |
MAD(median absolute deviation、中央絶対偏差)は、標準偏差の頑健な代わりです。標準偏差は 2 乗の平均なので、外れ値が 1 個あるだけで大きく膨らみます。MAD は中央値の中央値なので、窓の半分近くまで外れ値が混じっても、ほとんど動きません。Rousseeuw と Croux(1993)は、MAD を頑健な推定でよく使う尺度として挙げ、その理由を、式が単純で計算が軽いこと、影響関数が有界であること、破壊点が 50 % であることとしています。破壊点は、データのうち何割を任意の値に置き換えると推定がいくらでも大きくなってしまうか、という割合です。平均の破壊点は 0 % で、1 個の外れ値で壊れます。
1.4826 の出どころ
1.4826 は、ガウス分布で MAD を標準偏差にそろえる係数です。平均 μ、標準偏差 σ のガウス分布で、データが多いとき中央値は μ に、MAD は |X - \mu| の中央値に近づきます。 |X - \mu| \le a となる確率がちょうど 1/2 になる a を求めればよいので、標準正規分布の累積分布関数(値がそれ以下になる確率を返す関数)を Φ と書くと、次のように解けます。
\begin{aligned} P(|X-\mu| \le a) &= 2\Phi(a/\sigma) - 1 \\ &= \tfrac{1}{2} \\ a &= \sigma\,\Phi^{-1}(3/4) \\ &= 0.67449\,\sigma \end{aligned}つまりガウス分布では MAD → 0.67449σ で、σ に戻すには 1/0.67449 = 1.4826 を掛けます。Pearson ほか(2016)の Hampel フィルタの定義も、この 1.4826 を使っています。代わりに払うものもあり、Rousseeuw と Croux によれば、ガウス分布での MAD の効率は 37 % です。標準偏差を普通に計算するより、ばらつきの見積もりが粗くなります。
γ でメディアンと素通しをつなぐ
定義の場合分けを γ の両端で見ると、Hampel フィルタの位置づけがはっきりします。
- γ = 0:x[n] が m[n] と少しでも違えば置き換えるので、出力は常に m[n]。メディアンフィルタそのもの
- γ → ∞:どんな値も置き換えないので、素通し
Pearson ほか(2016)は、この γ = 0 の極限を手がかりに、Hampel フィルタをメディアンフィルタの一般化として扱いました。γ は、メディアンと素通しの間を連続につなぐつまみです。
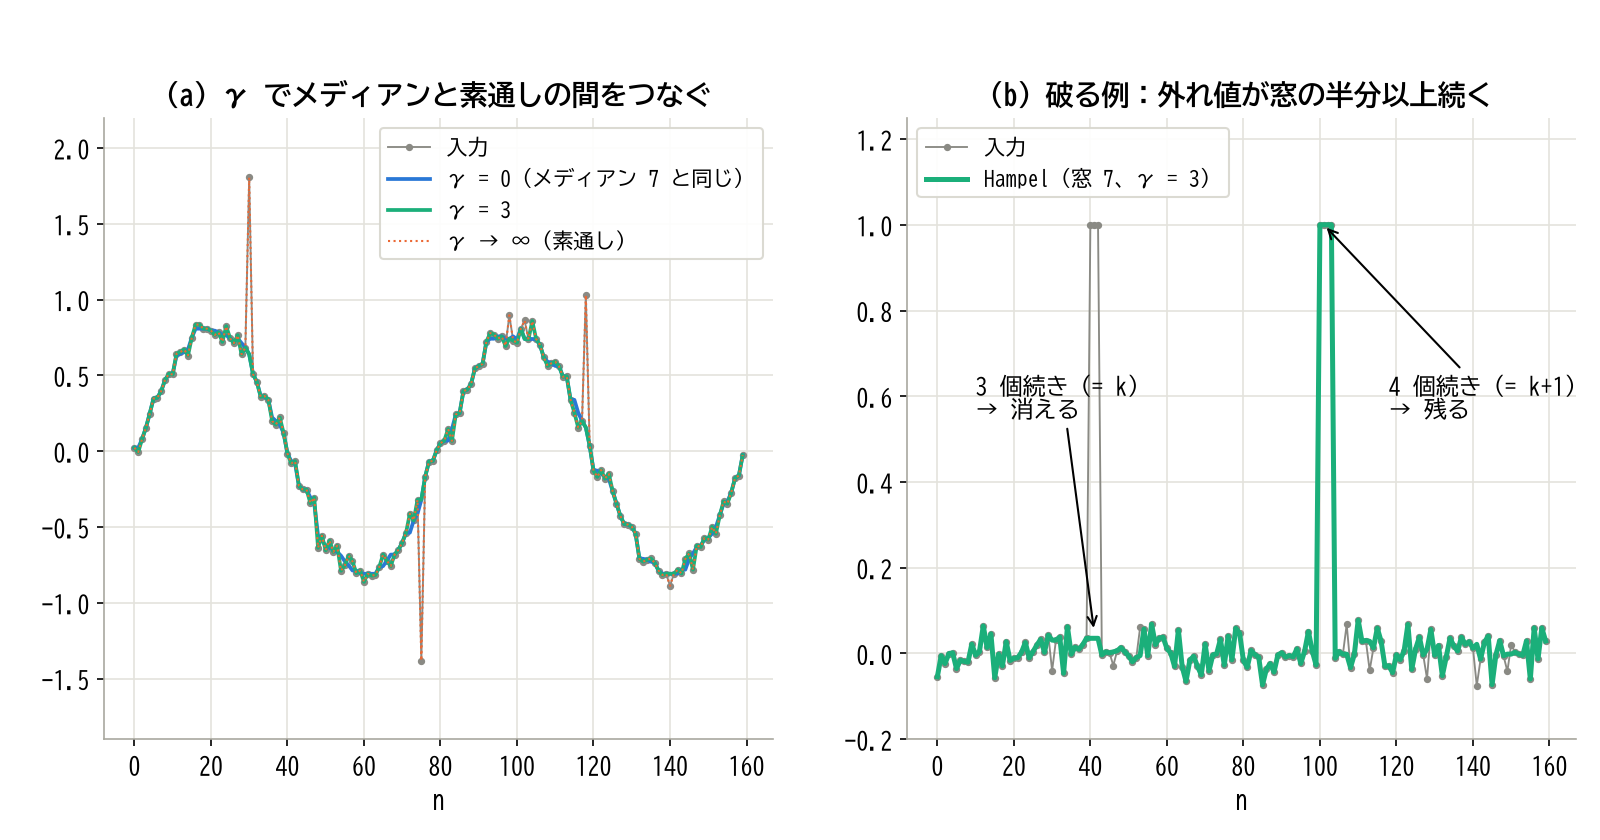
(a) γ = 3(緑)はスパイク 3 個を消し、それ以外の値はほぼ触らない。(b) 破る例:窓 7(k = 3)では、3 個続きは消えるが 4 個続きは残る
図の (a) は窓 7(k = 3)で、160 サンプルのうち 3 個がスパイクです。γ = 3 で置き換えたのは 6 個(スパイク 3 個と、普通の値 3 個)で、残りの 154 個は入力のままです。γ = 0(メディアン 7)は 92 個の値を動かしました。正弦波の頂点のような意味のある細部を、Hampel はほとんど触りません。
一方で、Hampel は外れ値でないガウスノイズを減らしません。この図の真の正弦波からの RMS 誤差は、入力が 0.052、γ = 3 が 0.051、γ = 0 が 0.039 でした。Hampel は外れ値を除く道具で、ノイズを均す道具ではありません。両方が要るなら、Hampel のあとに移動平均や SG をつなぎます。
γ = 3 の根拠と、小さい窓での誤検出
γ = 3 がよく使われるのは、ガウス分布で ±3σ の外に出る確率が 0.27 % と小さいからです。Pearson ほか(2016)の数値シミュレーションでも、t(この記事の γ)が 1.0 から 6.5 の範囲で、外れ値の除去が良好でした。
ただし 0.27 % は、σ̂ が σ に正確に一致するときの値です。窓が短いと MAD そのものがばらつき、しかも小さめに出やすいので、普通の値を外れ値と判定する率が上がります。ガウスノイズだけを入れて、置き換えた割合を計算すると次のようになりました。
| しきい値 | 窓 7 | 窓 15 | σ が既知のとき |
|---|---|---|---|
| γ = 2 | 10.9 % | 7.8 % | 4.55 % |
| γ = 3 | 4.8 % | 2.1 % | 0.27 % |
| γ = 4 | 2.5 % | 0.61 % | 0.006 % |
窓 7、γ = 3 では、普通の値の約 5 % を置き換えます。置き換え先は中央値で、もともとの値に近いので、出力の波形への影響は小さいものです。ただ、Hampel を「外れ値の数を数える検出器」として使うなら、この率をそのまま誤報の率として見積もる必要があります。
破壊点と破る例 2 つ
Hampel フィルタの判定は中央値に頼っているので、中央値が壊れると一緒に壊れます。
破る例 1:外れ値が窓の半分以上続く。 窓 2k+1 のうち外れ値が k+1 個以上を占めると、中央値そのものが外れ値の側に移ります。上の図の (b) がこれで、窓 7(k = 3)では外れ値が 3 個続く場所は消え、4 個続く場所は高さ 1.0 のまま残りました。メディアンのルート信号の定理と同じ k+1 の境目です。対策は、外れ値が続く最大の長さを L として、 k \ge L に窓を取ることです。
破る例 2:量子化された整数の列で MAD = 0 になる。 実用で必ず踏む落とし穴です。量子化は、連続の値を刻みのある整数に丸めることです。ADC やセンサの値は整数で、ノイズが 1 LSB(最下位ビット 1 つ分の大きさ)より小さいと、窓の中の値の過半数が同じ整数になります。すると、m からのずれが 0 の値が過半数なので MAD = 0、σ̂ = 0 です。判定は |x - m| > 0 になり、1 LSB の揺れまで全部「外れ値」として置き換えます。Pearson ほか(2016)はこれを爆縮(implosion)と呼び、窓の中に同じ値が k+1 個以上あると、γ に関係なく出力が m[n] になる、と述べています。値が 2 つの整数を 1 個おきに往復する列も、窓の中に同じ値が k+1 個以上あるので、同じことが起きます。
対策は、σ̂ に下限を付けることです。
\hat\sigma[n] = \max\bigl(1.4826\,\operatorname{MAD}[n],\ \sigma_{\min}\bigr)\sigma_{\min} は、量子化の刻み(1 LSB)か、データシートのノイズの値から決めます。設計例 1 で、この下限の有無で何が変わるかを数字で見ます。
手計算:窓 7、γ = 3
メディアンの手計算と同じ数列で、窓 7(k = 3)、γ = 3 の Hampel を計算します。
n = 3: 窓は x[0..6] = (100, 102, 101, 0, 103, 102, 104)。並べると (0, 100, 101, 102, 102, 103, 104) で、m = 102。ずれの絶対値は (2, 0, 1, 102, 1, 0, 2) で、並べると (0, 0, 1, 1, 2, 2, 102) なので MAD = 1、σ̂ = 1.4826、γσ̂ = 4.45。x[3] = 0 は m から 102 離れていて 4.45 を超えるので、102 に置き換える。
n = 4: 窓は x[1..7] = (102, 101, 0, 103, 102, 104, 101)。m = 102、ずれは (0, 1, 102, 1, 0, 2, 1) で MAD = 1。x[4] = 103 は m から 1 しか離れていないので、103 のまま出す。
n = 5: 窓は x[2..8] = (101, 0, 103, 102, 104, 101, 103)。m = 102、MAD = 1。x[5] = 102 は m と同じなので 102 のまま。
n = 4 で、メディアン 7 なら 103 を 102 に変えるところを、Hampel は元の 103 を残しています。0 が窓の中にあっても、m と MAD はどちらもほとんど動いていません。これが中央値と MAD の頑健さです。
📈 Savitzky–Golay フィルタ
ここからは線形の平滑化です。移動平均は、窓の中の点に「定数」を当てはめたものと読めます。定数を最小 2 乗で当てはめると、その値は平均になるからです。SG は、定数の代わりに q 次の多項式を当てはめます。多項式なら傾きや曲がりにも沿えるので、ピークや坂の形が残ります。
定義:窓の中で多項式を当てはめる
窓の中の位置を j(−k から k)とし、q 次の多項式を当てはめます。
p(j) = a_0 + a_1 j + a_2 j^2 + \cdots + a_q j^q係数 a を、窓の中の 2k+1 点との誤差の 2 乗和が最小になるように決めます。
\min_{a}\ \sum_{j=-k}^{k} \bigl(x[n+j] - p(j)\bigr)^2出力は、多項式の中心(j = 0)での値 y[n] = p(0) = a_0 です。微分が要るなら p'(0) = a_1 を T で割ります。
| 記号 | 意味 |
|---|---|
| j | 窓の中の位置(−k〜k) |
| q | 多項式の次数(q < 2k+1) |
| a_i | 多項式の i 次の係数 |
| p(0) | 中心での値。これが出力 |
これを行列で書きます。窓の値を縦に並べたベクトルを x、各点の j^i を並べた行列を V とします。
\mathbf{V} = \begin{bmatrix} 1 & -k & (-k)^2 & \cdots & (-k)^q \\ \vdots & \vdots & \vdots & & \vdots \\ 1 & k & k^2 & \cdots & k^q \end{bmatrix}2 乗和を a で微分して 0 と置くと、最小 2 乗の正規方程式(2 乗和を最小にする条件を、連立 1 次方程式の形にしたもの)が出ます。
\begin{aligned} \mathbf{V}^{\mathsf{T}}\mathbf{V}\,\mathbf{a} &= \mathbf{V}^{\mathsf{T}}\mathbf{x} \\ \mathbf{a} &= (\mathbf{V}^{\mathsf{T}}\mathbf{V})^{-1}\mathbf{V}^{\mathsf{T}}\mathbf{x} \end{aligned}これは #8 のウィーナー解 \mathbf{R}\mathbf{w}_o = \mathbf{p} と同じ形です。#8 では入力の相関行列 R と相互相関 p から最適な係数を求めました。ここでは \mathbf{V}^{\mathsf{T}}\mathbf{V} が R の、 \mathbf{V}^{\mathsf{T}}\mathbf{x} が p の役をしています。
ここで大事なのは、V は窓の位置だけで決まり、データ x に依らないことです。 (\mathbf{V}^{\mathsf{T}}\mathbf{V})^{-1}\mathbf{V}^{\mathsf{T}} の先頭の行を c_j と書けば、出力は x の重み付きの和になります。
y[n] = a_0 = \sum_{j=-k}^{k} c_j\, x[n+j]| 記号 | 意味 |
|---|---|
| V | 窓の位置 j のべき乗を並べた行列 |
| \mathbf{V}^{\mathsf{T}}\mathbf{V} | 位置だけで決まる (q+1)×(q+1) の行列 |
| c_j | SG の FIR の係数(データに依らない) |
| y[n] | 中心での多項式の値 |
つまり SG は、係数を前もって計算しておける FIR です。毎回最小 2 乗を解く必要はなく、#1 の FIR と同じく、係数を掛けて足すだけです。Savitzky と Golay の 1964 年の論文の要点はここにあり、係数の表を載せて、計算を掛け算と足し算だけにしました。係数は左右対称なので、FIR は直線位相(位相の遅れが周波数に比例し、どの成分も同じ時間だけ遅れる性質)で、群遅延はちょうど k サンプルです。
5 点 2 次の係数を手で導く
最小の例として、窓 5(k = 2)、2 次(q = 2)の係数を導きます。2 乗和を a_0, a_1, a_2 で微分して 0 と置くと、正規方程式は次の 3 本です。j が −2 から 2 まで対称なので、j の奇数乗の和は 0 になって消えます。
\begin{aligned} \textstyle\sum 1\cdot a_0 + \sum j^2\cdot a_2 &= \textstyle\sum x_j \\ \textstyle\sum j^2\cdot a_1 &= \textstyle\sum j\,x_j \\ \textstyle\sum j^2\cdot a_0 + \sum j^4\cdot a_2 &= \textstyle\sum j^2 x_j \end{aligned}ここで x_j = x[n+j] の略です。和の値は \sum 1 = 5 、 \sum j^2 = 4+1+0+1+4 = 10 、 \sum j^4 = 16+1+0+1+16 = 34 です。1 本目と 3 本目から a_2 を消すと、次の式になります。
\begin{aligned} a_0 &= \frac{34\sum x_j - 10\sum j^2 x_j}{34\cdot 5 - 10\cdot 10} \\ &= \frac{17\sum x_j - 5\sum j^2 x_j}{35} \end{aligned}x_j ごとの係数を読みます。j = 0 は j^2 = 0 で 17、j = ±1 は 17 − 5 = 12、j = ±2 は 17 − 20 = −3 です。
c = \frac{1}{35}\,(-3,\ 12,\ 17,\ 12,\ -3)和は (−3 + 12 + 17 + 12 − 3)/35 = 35/35 = 1 で、DC のゲインは 1 です。両端が負の係数になっているのが、移動平均との大きな違いです。2 本目の式からは、微分の係数も同時に出ます。 a_1 = \sum j\,x_j/10 なので、1 次微分は次の形です。
\begin{aligned} \frac{dx}{dt}\Big|_{n} &\approx \frac{a_1}{T} \\ &= \frac{-2x_{-2} - x_{-1} + x_{1} + 2x_{2}}{10\,T} \end{aligned}確かめに、2 次式そのもの x = (1, 4, 9, 16, 25) ( (j+3)^2 の値)を入れると、(−3 + 48 + 153 + 192 − 75)/35 = 315/35 = 9 で、中心の真の値 9 がそのまま出ます。2 次式は 2 次の当てはめで誤差 0 だからです。山の形 x = (2, 5, 9, 6, 3) なら、(−6 + 60 + 153 + 72 − 9)/35 = 270/35 = 7.71 で、移動平均の 25/5 = 5.0 より真ん中の 9 にずっと近い値になります。
一般の窓で 2 次(または 3 次)のときの係数は、閉じた形で書けます。上と同じ手順で和を一般の k で計算すると、次の式になります。
c_j = \frac{3\,(3k^2 + 3k - 1 - 5j^2)}{(2k-1)(2k+1)(2k+3)}k = 2 を入れると分母は 3·5·7 = 105、j = 0 で 3·17/105 = 17/35 となり、上の結果と一致します。q = 3 でも同じ係数になるのは、j の 3 乗の項が、対称な窓では中心の値に寄与しないからです。同じ理由で、q = 1 の微分の係数 j/\sum j^2 は q = 2 の微分と一致します。
多項式を通す、だから通過域が平ら
SG の係数は、q 次までの多項式をそのまま通すように作られています。これを係数の条件で書くと、次のモーメントの条件になります。
\sum_{j=-k}^{k} c_j\, j^{\,r} = \begin{cases} 1 & r = 0 \\ 0 & 1 \le r \le q \end{cases}入力が x[n+j] = j^r (r ≤ q)なら、当てはめた多項式は入力そのもので、中心の値 0^r が出るからです。この条件を周波数に翻訳します。中心をそろえた周波数応答は H(e^{i\omega T}) = \sum_j c_j e^{-i\omega T j} です(虚数単位は、窓の位置の j と区別して i と書きます)。指数関数をテイラー展開(関数を ω のべき乗の和で表す展開)して和の順番を入れ替えると、次の形になります。
\begin{aligned} H &= \sum_{r=0}^{\infty} \frac{(-i\omega T)^r}{r!} \sum_j c_j\, j^{\,r} \\ &= 1 + O\bigl(\omega^{q+1}\bigr) \end{aligned}r = 1 から q までの項がモーメントの条件で消えるので、ω の小さいところで H は 1 から q+1 次まで動きません。しかも係数が左右対称なので奇数の r の和は自動的に 0 になり、q が偶数なら実際には O(\omega^{q+2}) です。次数を上げるほど、通過域が平らになるのは、この展開の次数のためです。移動平均は q = 0 で O(\omega^2) 、つまり DC から少し離れるとすぐ下がり始めます。
ノイズの減り方も、係数から読めます。白色ノイズの分散比は #1 の式 のとおり \sum c_j^2 で、SG ではこれが中心の係数 c_0 にちょうど等しくなります。最小 2 乗の当てはめは射影(ある空間へまっすぐ落とす操作)で、射影の行列は 2 回掛けても同じなので、 \sum_j c_j^2 = c_0 が成り立つからです。5 点 2 次なら 17/35 = 0.486 で、移動平均 5 の 0.2 の 2.4 倍です。形を保つ代わりに、同じ窓ではノイズが残ります。
周波数特性
窓を 21 点(k = 10)に固定して次数を変えると、周波数特性は次のようになります。右の図は、−3 dB の周波数を半幅 k に対して描いたものです。
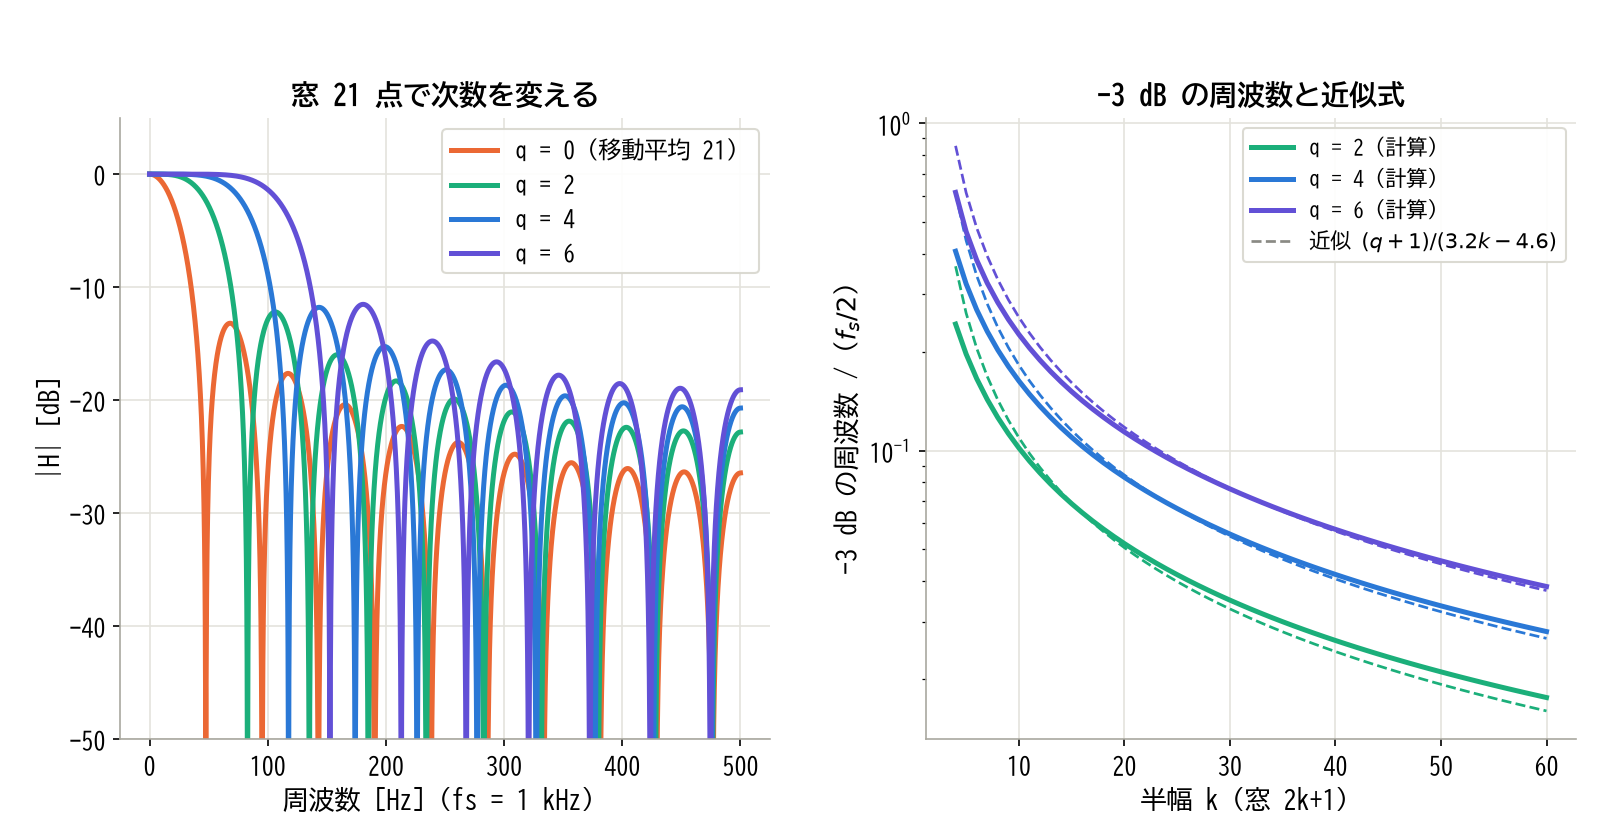
左:次数を上げると通過域が平らに広がるが、阻止域の山は下がらない。右:近似式(破線)は k が小さいと高めに外れ、k が 25 前後で数 % まで合う
左の図から、SG の周波数特性の 3 つの性質が読めます。
- 通過域が平ら:次数を上げるほど、0 dB の平らな部分が広がる。−3 dB は fs = 1 kHz で q = 0、2、4、6 の順に 21 Hz、51 Hz、82 Hz、113 Hz
- 阻止域の漏れが大きい:遷移のすぐ外の山は、移動平均 21 の −13.2 dB に対し、SG 21 点 2 次で −12.2 dB。高い周波数の山も、移動平均の −26 dB に対し SG 2 次は −23 dB 程度にとどまる。Schmid ほか(2022)も、SG の第 1 サイドローブは −11〜−13 dB で、窓の半幅にはほとんど依らないと述べている
- 群遅延は k:係数が左右対称なので、すべての次数で直線位相。因果にすれば遅れは kT
2 は大事な弱点です。SG は「通したい帯域を平らに通す」ことに最適化されていて、「止めたい帯域を深く止める」ことは考えていません。高い周波数のノイズを強く落としたいなら、SG の前か後に別のローパスをつなぎます。
窓と次数から −3 dB を見積もる近似式を、Schafer(2011)が示しています。半幅 25 以上を対象に、fs/2 を 1 とした周波数で与えられたものです(Schmid ほか 2022 の指摘による)。この記事の数値計算では、次の形がよく合いました(ωc は −3 dB の角周波数で、ωc/π は fs/2 を 1 とした周波数です)。
\frac{\omega_c}{\pi} = \frac{f_c}{f_s/2} \approx \frac{q+1}{3.2k - 4.6}右の図の破線がこの式です。計算した値との差は、k = 5 で +31〜36 %、k = 10 で +7〜13 %、k = 25 で −5〜+2 %、k = 50 で −8〜−2 %(q = 2、4、6)でした。窓が短いときは、周波数応答を直接計算して確かめます。適用範囲が半幅 25 以上とされているとおり、k が小さいほど外れます。すべての k で使える精度の近似式は、Schmid ほか(2022)が式 14 として与えています。
移動平均・バターワースと同じ −3 dB で比べる
#2 の 3 つのローパスは、fs = 1 kHz で −3 dB を約 20 Hz にそろえました。SG も同じ −3 dB にそろえると、2 次で 53 点(20.1 Hz)、4 次で 85 点(19.9 Hz)が要ります。移動平均 22 点(20.2 Hz)、2 次バターワース 20 Hz と並べたのが次の図です。(c) のピークの幅は半値全幅(FWHM、ピークの高さの半分の位置での幅)で表しています。ピークの幅を 1 つの数で言うときによく使う量です。
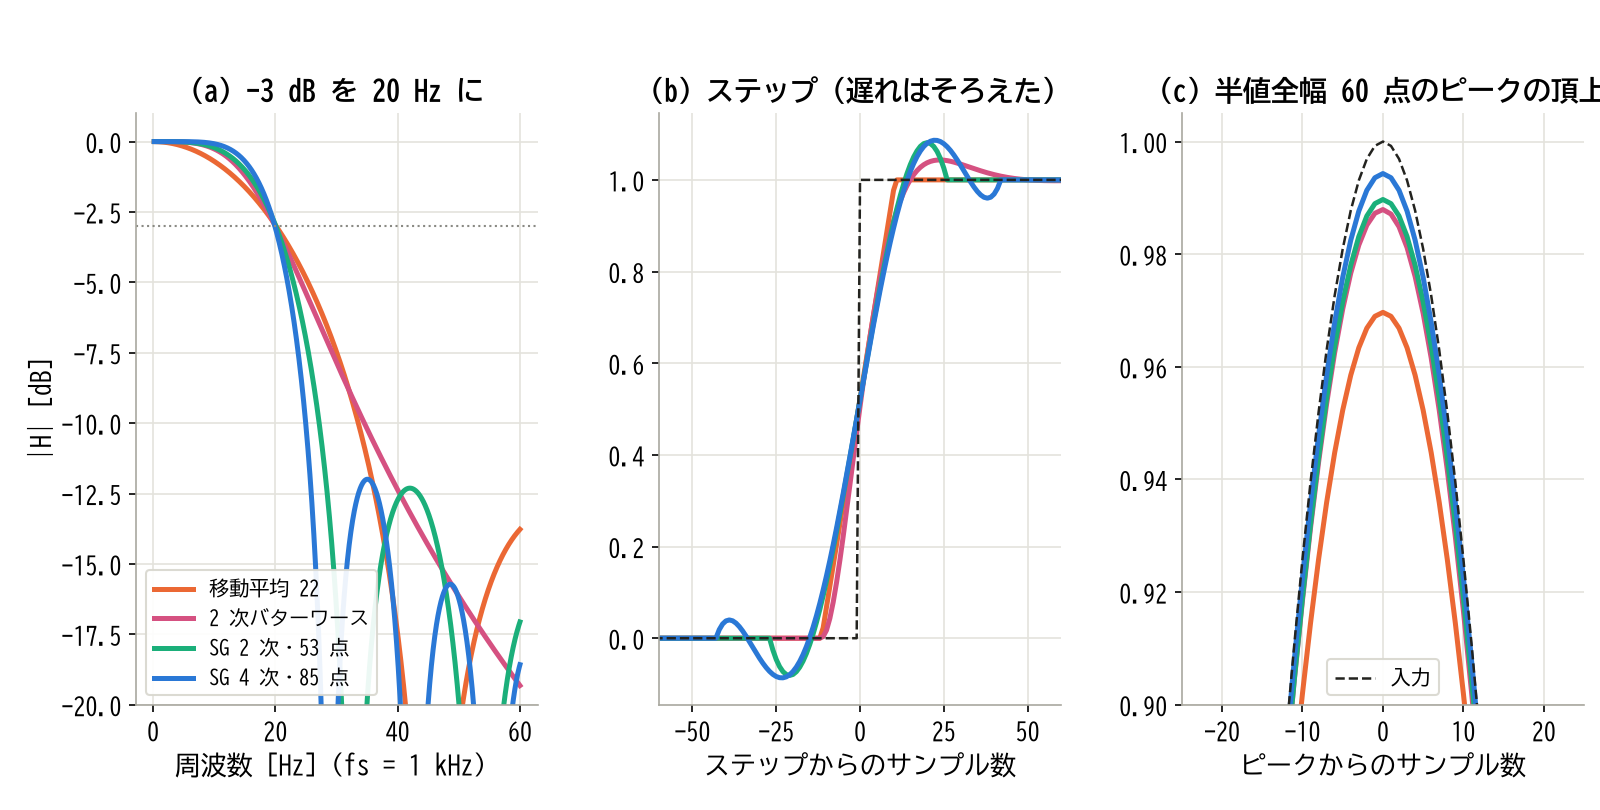
(a) SG(緑、青)は 20 Hz の手前まで平らで、その先で急に落ちる。(b) SG はステップの前後に対称な波を立てる。(c) 幅の広いピークの頂上は、SG がいちばん削らない
(a) で通過域を比べます。10 Hz での振幅は、移動平均 0.922、バターワース 0.970、SG 2 次 0.975、SG 4 次 0.991 です。(c) の半値全幅 60 点のピークは、成分の多くが 10 Hz より下にあるので、この差がそのまま頂上の高さの差になります。移動平均が 3.0 % 削るのに対し、SG 4 次は 0.6 % です。
一方で、ピークが狭くなると差は消えます。半値全幅 30 点のピークでは、高さの減りは移動平均 11.2 %、バターワース 9.1 %、SG 2 次 9.8 %、SG 4 次 10.0 % とほぼ横並びで、20 点では SG のほうが削ります(移動平均 22.2 %、SG 4 次 26.6 %)。ピークの成分が −3 dB の外まで広がると、通過域の平らさは効かず、阻止域の形で決まるからです。同じ −3 dB で比べると、SG の得は「幅の広い形を正確に残す」ことに限られます。 SG が移動平均に大きく勝つのは、同じ窓の長さで比べたとき(設計例 2)と、窓の長さをピークの幅に合わせて決めるときです。
(b) のステップ応答では、SG がステップの前に約 8 % の下振れ、後に約 8 % の行き過ぎを作ります。負の係数を持つ対称な FIR だからで、はじめにの図の右でステップの前後に立っていた波がこれです。バターワースは後ろだけに 4.3 % の行き過ぎ、移動平均は行き過ぎがありません。角を保ちたいなら、SG ではなくメディアンです。
もう 1 つの代償が遅れです。同じ −3 dB で、移動平均 22 点の遅れは 10.5 ms、SG 2 次 53 点は 26 ms、4 次 85 点は 42 ms です。白色ノイズの分散比は、移動平均 0.0455、SG 2 次 0.0425、SG 4 次 0.0414 とほぼ同じなので、同じノイズ、同じ −3 dB で、SG は 2.5〜4 倍遅れることになります。この遅れが制御ループで何を起こすかは、次の章で見ます。
微分:SG 微分器と素の差分
SG の多項式は微分もできます。中心での 1 次微分 a_1/T も x の重み付きの和なので、SG 微分器も FIR です。5 点 2 次の係数は上で導いた (-2, -1, 0, 1, 2)/(10T) です。
#1 で見たとおり、微分を後退差分 (x[n] - x[n-1])/T で置き換えると、白色ノイズの標準偏差は \sqrt{2}\,\sigma/T に増えます。SG 微分器の標準偏差は \sigma\sqrt{\sum c_j^2} で、5 点 2 次なら \sqrt{10}/10 = 0.316 倍の 0.316\,\sigma/T です。後退差分の 1/4.5 になります。
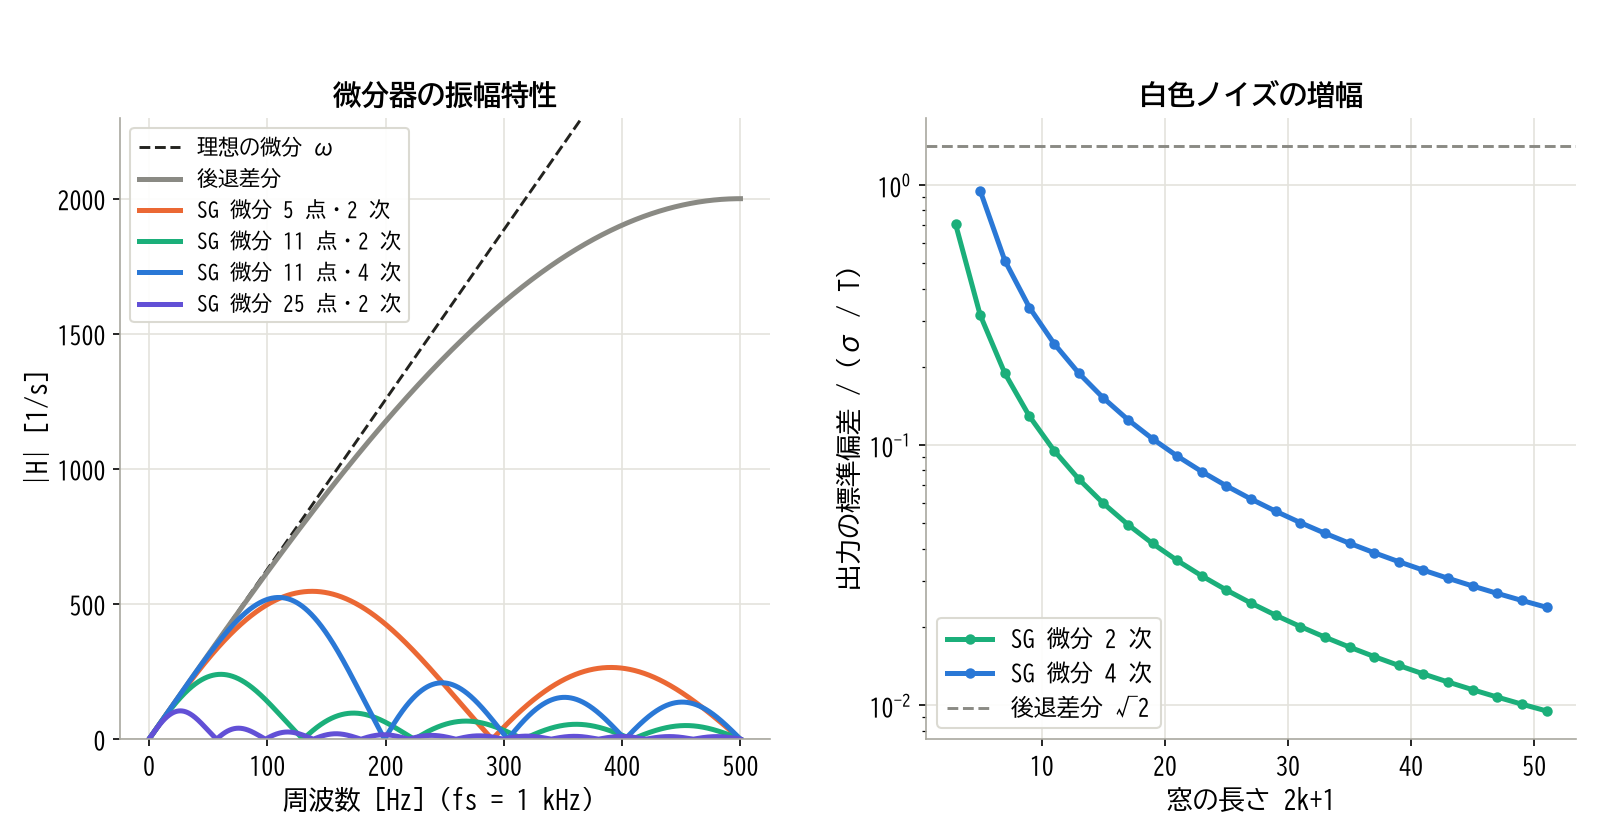
左:SG 微分器は低い周波数だけ理想の微分に沿い、高い周波数は増幅しない。右:窓を伸ばすほどノイズは減り、次数を上げると増える
左の図で、黒の破線が理想の微分 ω です。後退差分(灰色)は高い周波数ほど大きく増幅し、ノイズを持ち上げます。SG 微分 5 点 2 次(オレンジ)は、68 Hz までは理想との差が 10 % 以内で、その先は下がります。つまり SG 微分器は「微分」と「ローパス」を 1 つにした FIR です。窓を伸ばすと直線に沿う帯域は狭くなり、ノイズは減ります。
右の図で、q = 2 の微分のノイズの倍率は 1/\sqrt{\sum j^2} で、 \sum j^2 = k(k+1)(2k+1)/3 なので、k が大きいとおおよそ k^{-3/2} で減ります。q = 4 は同じ窓で 2 次より倍率が大きく、そのぶん高い周波数まで微分に沿います。設計例 3 で、これをエンコーダの速度に使います。
端の処理
SG の窓は、データの両端 k 点では片側がはみ出します。後でまとめて処理するなら、端の 2k+1 点に同じ q 次の多項式を当てはめ、中心ではなく端の位置でその多項式を評価する方法がよく使われます。SciPy の savgol_filter の既定(mode='interp')がこれで、端の window_length 個の値に polyorder 次の多項式を当てはめ、その多項式で端の出力を求めます。
リアルタイムで、遅れ k を払えないときも、同じ考え方が使えます。窓の右端(最新の点)で多項式を評価すれば遅れは 0 になりますが、対称性が崩れて係数の 2 乗和が大きくなり、ノイズが増えます。端の扱いを含む SG 法の一般形は、Gorry(1990)も参照してください。
📊 周波数と制御工学の道具で見る
ここまで、メディアンと Hampel は時間領域で、SG は周波数領域で見てきました。この章では #2 の制御ループに入れたとき何が起きるかを、線形の SG は伝達関数で、線形でないメディアンはシミュレーションで確かめます。
SG を制御ループに入れる
#2 の「制御ループに入れると何が起きるか」と同じループを使います。モータは K = 1、τ = 50 ms の 1 次遅れ、1 ms 周期の PI 制御( K_p = 3 、 K_i = 60 )で、速度センサに平滑化を入れます。開ループ伝達関数は L = CPF で、C は PI 制御器、P はモータ、F が平滑化です。ゲイン交差は、開ループのゲインがちょうど 1 になる周波数です。位相余裕は、ゲイン交差での位相が −180° までどれだけ残っているかで、小さいほど発振に近くなります。フィルタなしのゲイン交差は約 9.6 Hz、位相余裕は 88.4° でした。
SG は線形なので、因果にした FIR の伝達関数 F(z) = \sum_j c_j z^{-(j+k)} をそのまま入れられます。
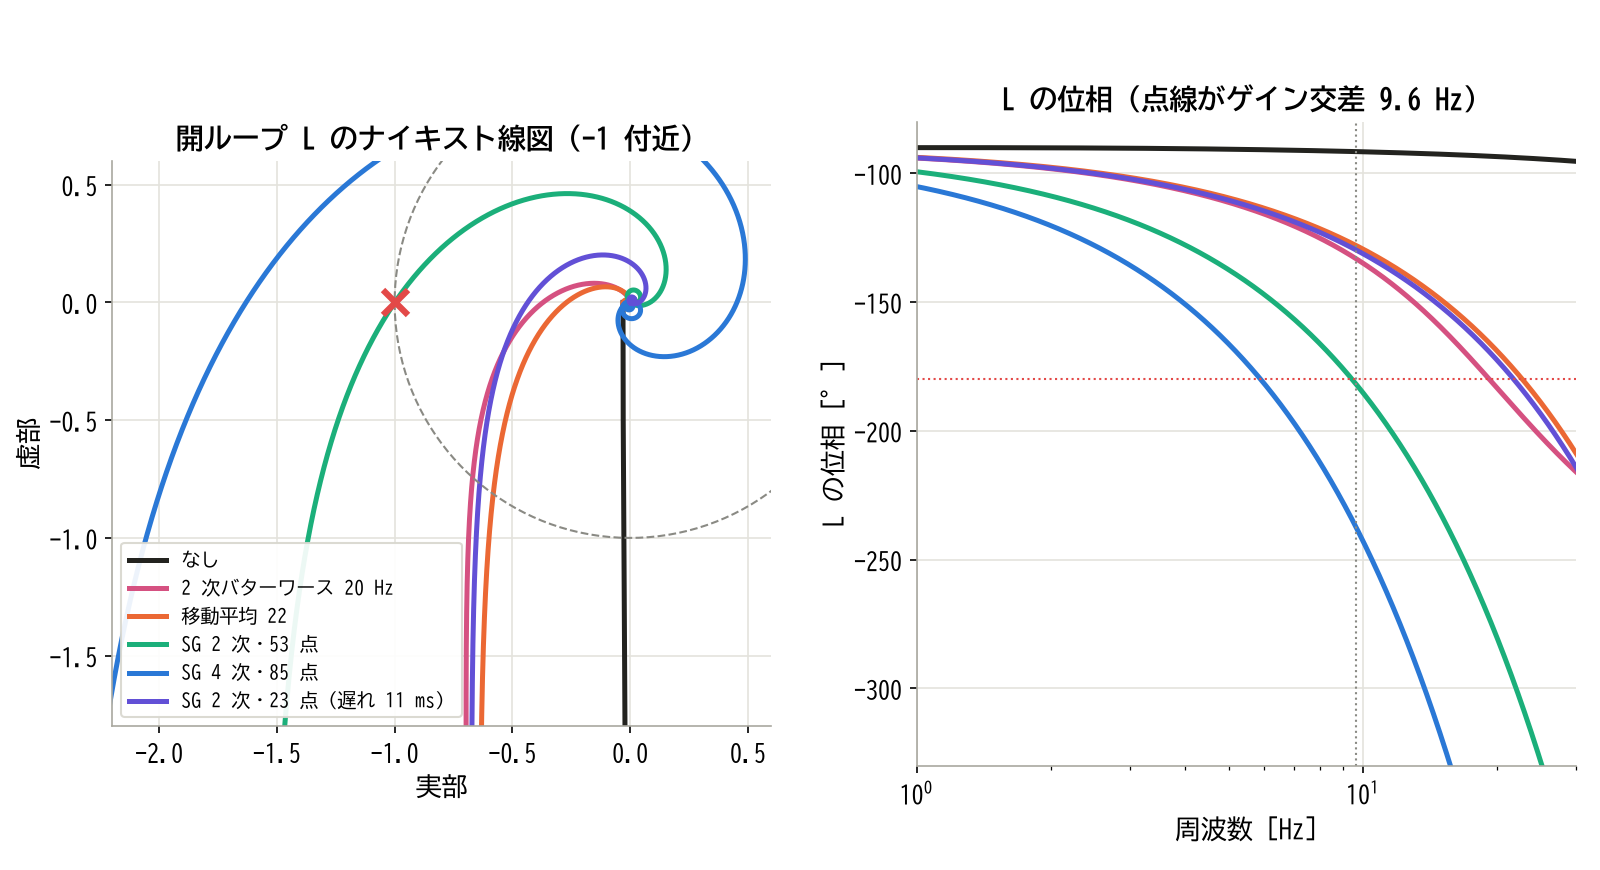
左:同じ −3 dB 20 Hz でも、SG 53 点(緑)は −1 点の上を通り、85 点(青)は −1 を囲む。右:遅れ k の FIR は、周波数に比例して位相を遅らせる
−3 dB、遅れ、位相余裕を表にします。
| センサの平滑化 | −3 dB | 遅れ | 位相余裕 |
|---|---|---|---|
| なし | — | 0 | 88.4° |
| 2 次バターワース | 20 Hz | 約 11 ms | 48.0° |
| 移動平均 22 点 | 20.2 Hz | 10.5 ms | 54.4° |
| SG 2 次 23 点 | 46.5 Hz | 11 ms | 50.3° |
| SG 2 次 53 点 | 20.1 Hz | 26 ms | 0.1° 未満 |
| SG 4 次 85 点 | 19.9 Hz | 42 ms | 不安定 |
同じ −3 dB 20 Hz にそろえた SG 2 次 53 点は、位相余裕がほぼ 0° で、発振の境目です。 ゲイン余裕(位相が −180° になる周波数で、ゲインが 1 までどれだけ余裕があるか)も 0.01 dB 未満でした。4 次 85 点は −1 点を囲み、閉ループは不安定です。ナイキスト線図(開ループ伝達関数の値を、周波数を動かしながら複素平面に描いた曲線)で −1 点を囲むと不安定になる理由は、#2 のワード解説のとおりです。
なぜここまで減るのかは、遅れの式で読めます。群遅延 kT の直線位相の FIR は、周波数 f で 360^\circ \cdot f\,kT だけ位相を遅らせます。ゲイン交差 9.6 Hz、k = 26、T = 1 ms を入れると 90.2° で、フィルタなしの 88.4° をちょうど使い切ります。
位相余裕を決めるのは −3 dB ではなく遅れ k です。表の SG 2 次 23 点は、遅れを 11 ms にそろえたもので、−3 dB は 46.5 Hz と高い代わりに、位相余裕は 50.3° と移動平均 22 点に近い値です。ループの中に SG を入れるなら、−3 dB ではなく遅れ k で窓を決めるのが勘所です。逆に、記録したデータを後で処理するなら、中心をそろえた SG に遅れはなく、位相のずれも 0 です。SG が分光などのオフラインの処理で重宝されてきた理由の 1 つです。
メディアンは振幅で利得が変わる
メディアンには伝達関数がありません。同じ周波数の正弦波でも、何と一緒に入ってくるかで、出てくる量が変わります。窓 9 のメディアンに、振幅 A の正弦波と σ = 1 の白色ノイズを足して入れ、出力の中の同じ周波数の成分(基本波)の大きさを入力と比べました。
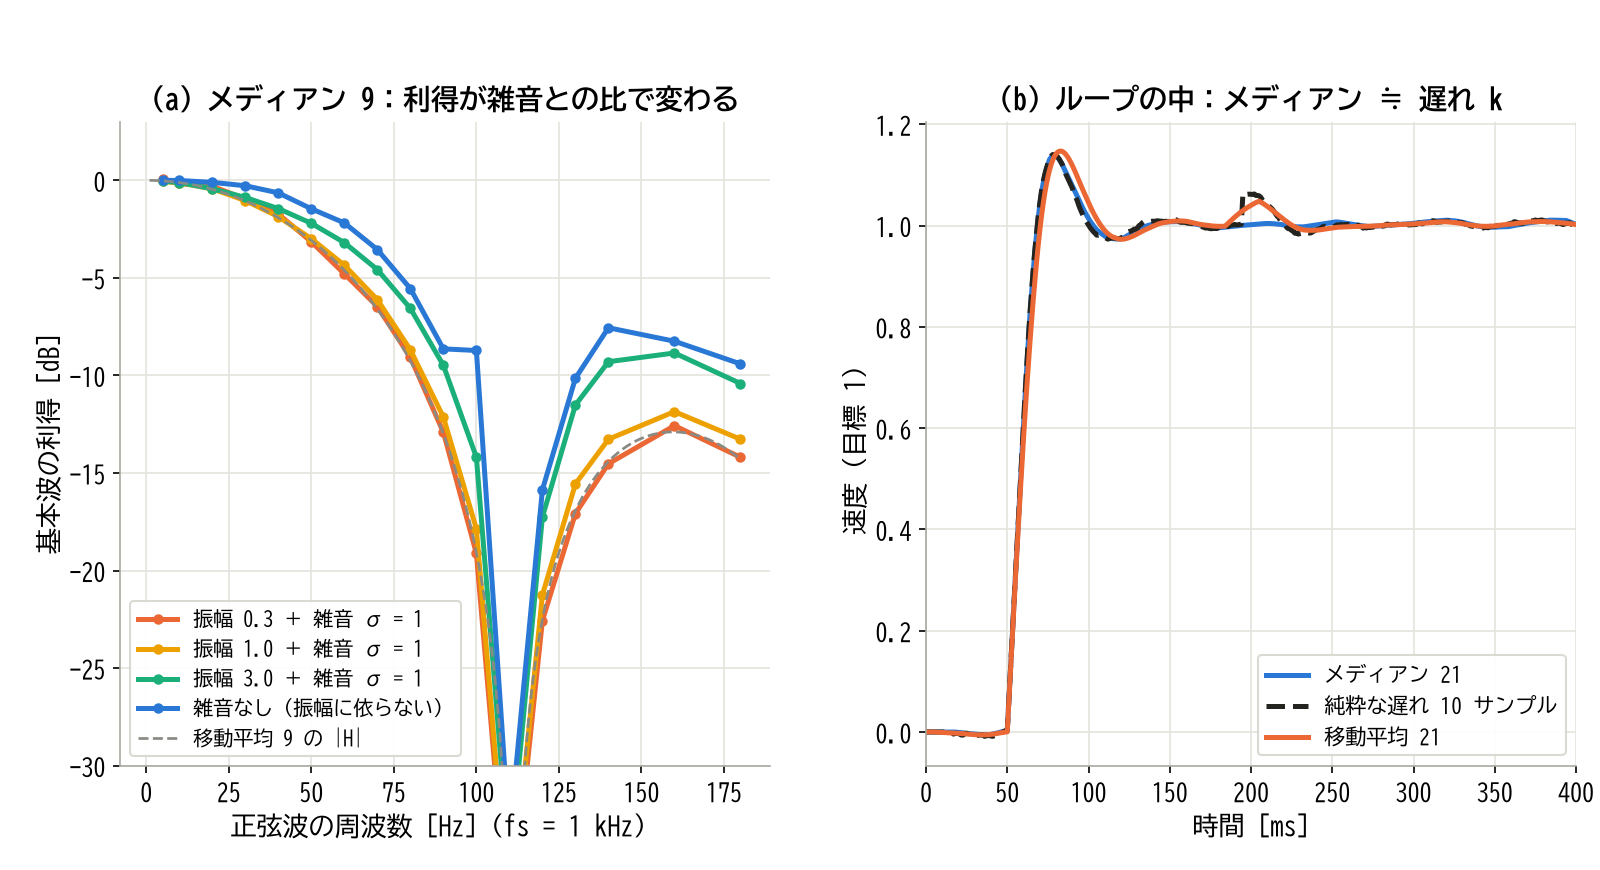
(a) 同じ周波数でも、雑音との比で利得が変わる。雑音に埋もれた小さな正弦波には、移動平均 9(破線)とほぼ同じ利得になる。(b) ループの中のメディアン 21 は、遅れ 10 サンプルとほぼ同じ応答で、スパイクだけを消す
(a) の青は雑音のない正弦波です。メディアンは、値を何倍かしても中央値も同じ倍率になる性質( \operatorname{median}(ax) = a\operatorname{median}(x) 、a > 0)を持つので、雑音がなければ利得は振幅に依らず、周波数だけで決まります。50 Hz の利得は約 0.85 でした。
ところが雑音を足すと、利得が下がります。振幅 0.3 と 1.0(雑音と同じかそれ以下)では、50 Hz の利得が約 0.70 で、移動平均 9 の |H| = 0.70 とほぼ同じです。小さい正弦波が大きな雑音に埋もれていると、窓の中の値の順番はほとんど雑音で決まり、メディアンは平均に近い働きをします。振幅 3.0 では、その中間です。入力を足し合わせても出力が足し合わせにならない、つまり線形でないことが、この利得の振幅依存として見えています。
ループの中のメディアンは遅れ k
伝達関数がないなら、メディアンをループの中に入れたときの安定性はどう見積もればよいでしょうか。答えは、群遅延 k の FIR と同じ遅れとして見積もることです。ステップのような大きな変化に対して、メディアンは角を保ったまま k サンプル遅れて通すだけだからです(ルート信号の定理)。
これを、#2 と同じループで確かめました。センサに σ = 0.02 のガウスノイズを足し、さらに 1 秒の間に 12 回、±1 のスパイクを入れます。センサの値を、メディアン 21(k = 10)、純粋な遅れ 10 サンプル、移動平均 21 のいずれかに通してフィードバックします。図の (b) がそのステップ応答です。
| 区分 | 行き過ぎ | 操作量の RMS | 出力の最大のずれ |
|---|---|---|---|
| メディアン 21 | 14.4 % | 0.019 | 0.013 |
| 遅れ 10 サンプル | 14.6 % | 0.387 | 0.126 |
| 移動平均 21 | 15.2 % | 0.104 | 0.092 |
行き過ぎの列は、スパイクを入れないときの値です。3 つの行き過ぎはほぼ同じで、メディアン 21 の応答は遅れ 10 サンプルとほとんど重なります。線形の遅れ 10 サンプルの位相余裕は 53.7°(88.4° から 360^\circ \times 9.6 \times 0.010 = 34.7^\circ を引いた値)、移動平均 21 は 55.9° です。
違いが出るのは、スパイクが来たときです。操作量の RMS と出力の最大のずれ(いずれもスパイクを入れた定常区間の値)で、遅れだけのループはスパイクをそのまま操作量へ通し、出力が 0.126 ずれます。移動平均はスパイクを 1/21 に薄めて、21 サンプルの間ずっと効かせます。メディアンはスパイクを消すので、出力のずれは 0.013 でノイズの大きさと同じです。
メディアンをループに入れるなら、群遅延 k の FIR として位相余裕を計算し、そのうえでスパイクだけを消す道具として使うのが設計の勘所です。
白色ノイズの分散比
最後に、#1 の分散比 の流儀で、4 つのフィルタが σ = 1 のガウス白色ノイズをどれだけ減らすかを並べます。シミュレーションは 40 万サンプル(メディアンは 20 万、Hampel は 10 万)です。
| フィルタ(窓 5) | 理論 | シミュレーション | 備考 |
|---|---|---|---|
| 移動平均 | 0.200 | 0.200 | 1/(2k+1) |
| メディアン | 0.314(漸近) | 0.289 | π/2 倍に近づく |
| SG 2 次 | 0.486 | 0.485 | 17/35 = c₀ |
| Hampel(γ = 3) | — | 0.866 | 6.9 % を置換 |
窓を 9 に伸ばすと、次のようになります。
| フィルタ(窓 9) | 理論 | シミュレーション | 備考 |
|---|---|---|---|
| 移動平均 | 0.111 | 0.111 | 1/(2k+1) |
| メディアン | 0.175(漸近) | 0.168 | π/2 倍に近づく |
| SG 2 次 | 0.255 | 0.255 | c₀ の式 |
| Hampel(γ = 3) | — | 0.888 | 3.6 % を置換 |
同じ窓なら、ガウスノイズを減らす力は移動平均、メディアン、SG の順で、Hampel はほとんど減らしません。メディアンの理論の列は漸近式 \pi/(2(2k+1)) なので、短い窓ではシミュレーションのほうが小さくなります。SG の理論は c₀ の閉じた形の式で、シミュレーションとよく合います。この表は、3 つのフィルタが「ノイズを均す」以外の目的のための道具であることを示しています。白色ノイズを均すだけなら、#2 のローパスで足ります。
🛠️ 設計例
3 つの題材で、要件から方式、窓とパラメータ、検証までを通します。どれも乱数のシードを固定した数値シミュレーションです。
設計例 1:センサの読み飛ばしのスパイク除去
要件: I²C の距離センサを 50 Hz で読む。値は mm 単位の整数で、普段のばらつきは σ = 2 mm。読み取りに失敗すると、0 か 65535 が 1〜2 サンプル続けて入る。物体が動いたときの段差は、角を保って追いたい。遅れは 100 ms 以内。
方式の候補: メディアン 3(k = 1)、メディアン 5(k = 2)、Hampel 7(k = 3、γ = 3、 \sigma_{\min} = 1 mm)、比較用に移動平均 5、1 次 IIR(α = 0.2)。すべて因果な形で、20 秒の列(0 か 65535 の入り方は 18 回、合わせて 23 サンプル)に通しました。
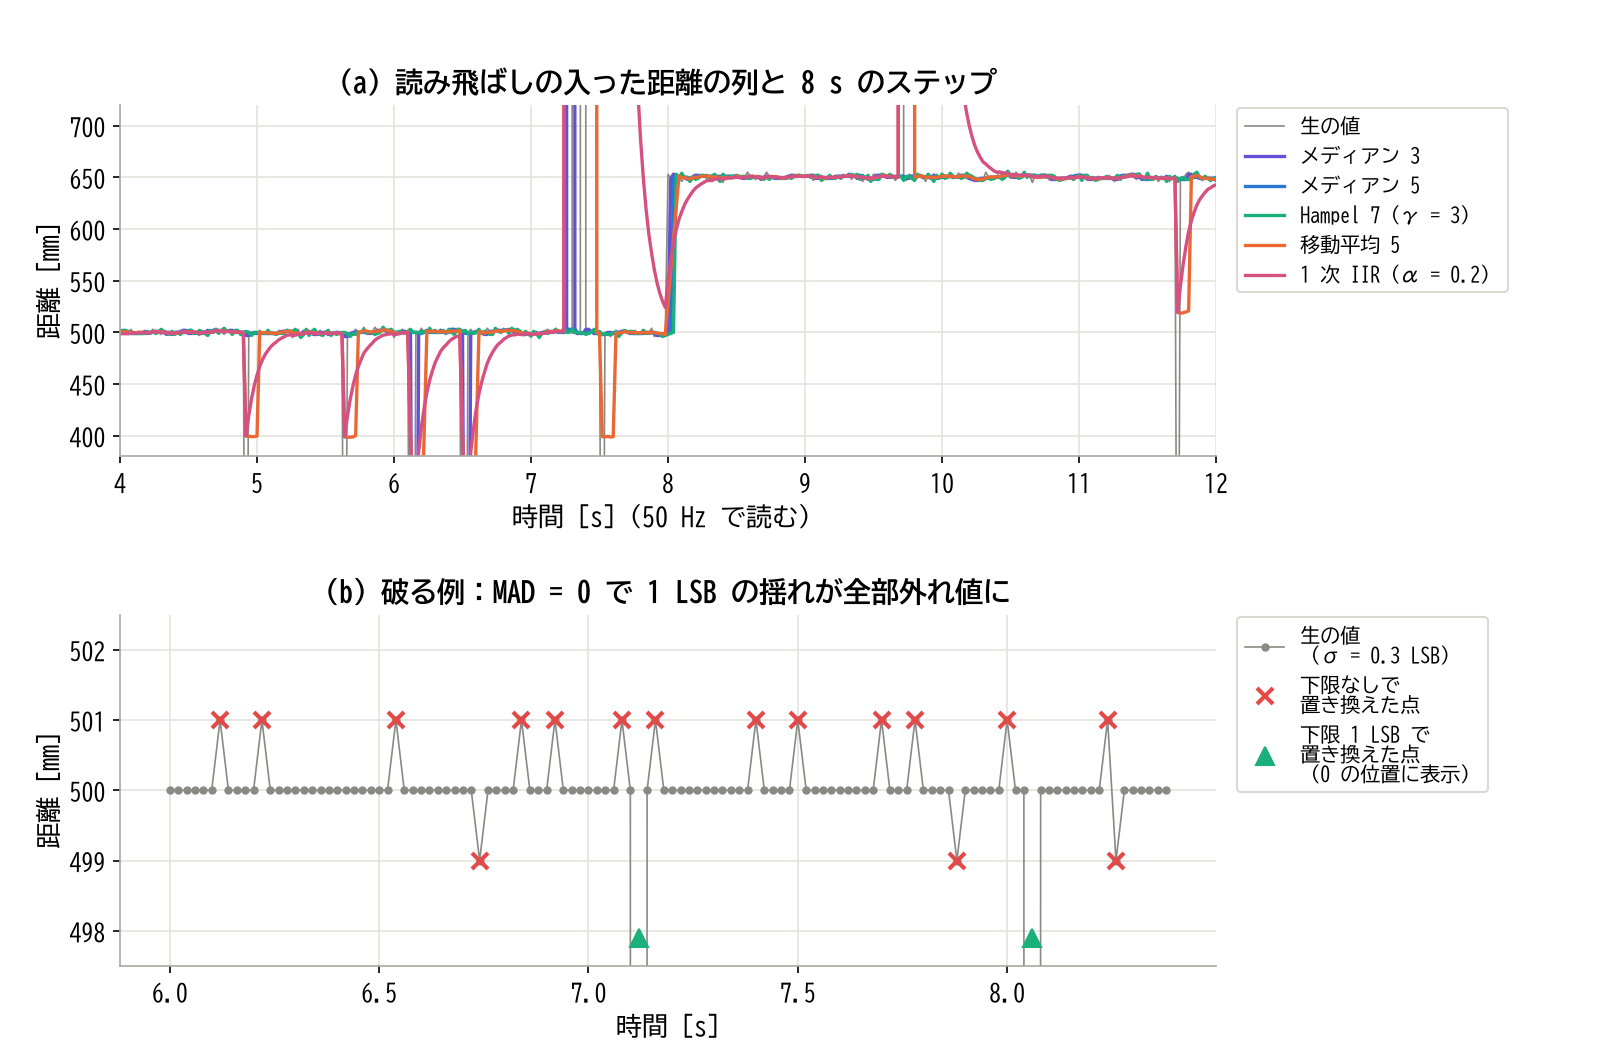
(a) 外れ値の幅が k を超えると、メディアン 3(紫)は 2 個続きを通す。メディアン 5 と Hampel は消す。(b) 量子化された静かな列では、MAD = 0 で 1 LSB の揺れ(赤の ×)まで外れ値になる。下限を付けると本物の外れ値(緑の ▲)だけが残る
(a) の結果を数字で並べます。誤差は、各方式の遅れの分をずらしてから真の距離と比べたもので、最初の 1 秒と、段差の前 0.5 秒から後 1.5 秒までを除いています。
| 方式 | 誤差 10 mm 超の点数 | 普段の RMS 誤差 | 遅れ |
|---|---|---|---|
| メディアン 3 | 10 | 1.38 mm | 20 ms |
| メディアン 5 | 0 | 1.14 mm | 40 ms |
| Hampel 7 | 0 | 1.95 mm | 60 ms |
| 移動平均 5 | 84 | 0.94 mm | 40 ms |
| 1 次 IIR | 257 | 2.21 mm | — |
「普段の RMS 誤差」は、誤差が 10 mm 以下の点だけで計算したものです。移動平均 5 は、普段のばらつきは最も小さい(0.94 mm)のに、外れ値のたびに 5 サンプルの台形を作り、84 点で 10 mm を超えました。1 次 IIR は外れ値の尾を長く引き、257 点です。段差の追従は、10 % から 90 % までが移動平均 5 で 40 ms、1 次 IIR で 180 ms かかったのに対し、メディアンと Hampel は 1 サンプル(20 ms)の中で切り替わりました。
メディアン 3 は、外れ値が 2 個続いた場所をそのまま通しました。k = 1 なので、幅 k+1 = 2 のパルスはルート信号の側に入るからです。窓の半幅は、外れ値が続く最大の長さ以上に取るのが条件です。
メディアン 5 と Hampel 7 はどちらも外れ値をすべて消しました。違いは普段の値の扱いで、メディアン 5 はガウスノイズも少し均して 1.14 mm、Hampel は普段の値を触らないので 1.95 mm(入力の σ = 2 mm とほぼ同じ)です。この要件ならメディアン 5 が素直な答えで、遅れも 40 ms で要件に収まります。Hampel が向くのは、普段の値の細部を残したいときです。
MAD = 0 の破る例: (b) は、同じセンサがもっと静かな場合(σ = 0.3 LSB、0 の読み飛ばしは 1 %)です。窓 7 の 99.4 % で MAD が 0 になりました。下限なしの Hampel は全体の 11.8 % の点を置き換え、そのうち本物の外れ値は 1.2 % だけで、211 点は 1 LSB の揺れを外れ値と誤って判定したものです。 \sigma_{\min} = 1 LSB を付けると、置き換えたのは 1.2 % で、本物の外れ値と完全に一致しました(見落とし 0、誤判定 0)。出力の値だけを見れば、置き換え先は中央値なので大差はありません。しかし、置き換えた回数を「通信エラーの回数」として記録するような使い方では、下限なしでは数字が 10 倍に膨らみます。
設計例 2:ピークのある波形の平滑化と微分
要件: 分光や反射率の走査のように、ピークの並んだ波形(半値全幅 20 点のガウス形のピークが 4 本、うち 2 本は近接)に σ = 0.03 のノイズが乗っている。ピークの高さと幅を 2 % 程度まで保ってノイズを減らし、ピークの位置を微分の 0 交差から求めたい。後で処理するので遅れは問わない。
窓の決め方: ノイズのない同じピークで、窓を変えながら高さの減りを計算しました。2 次では窓 15 で −0.5 %、21 で −1.9 %、31 で −6.7 %。4 次では窓 31 で −0.9 %、37 で −2.0 %、41 で −3.1 % です。高さの減りを 2 % 以内にする目安は、2 次なら窓を半値全幅以下、4 次なら半値全幅の 1.8 倍以下です。ここでは 2 次 15 点と、4 次 25 点を選びます。比較に移動平均 15 点を並べます。
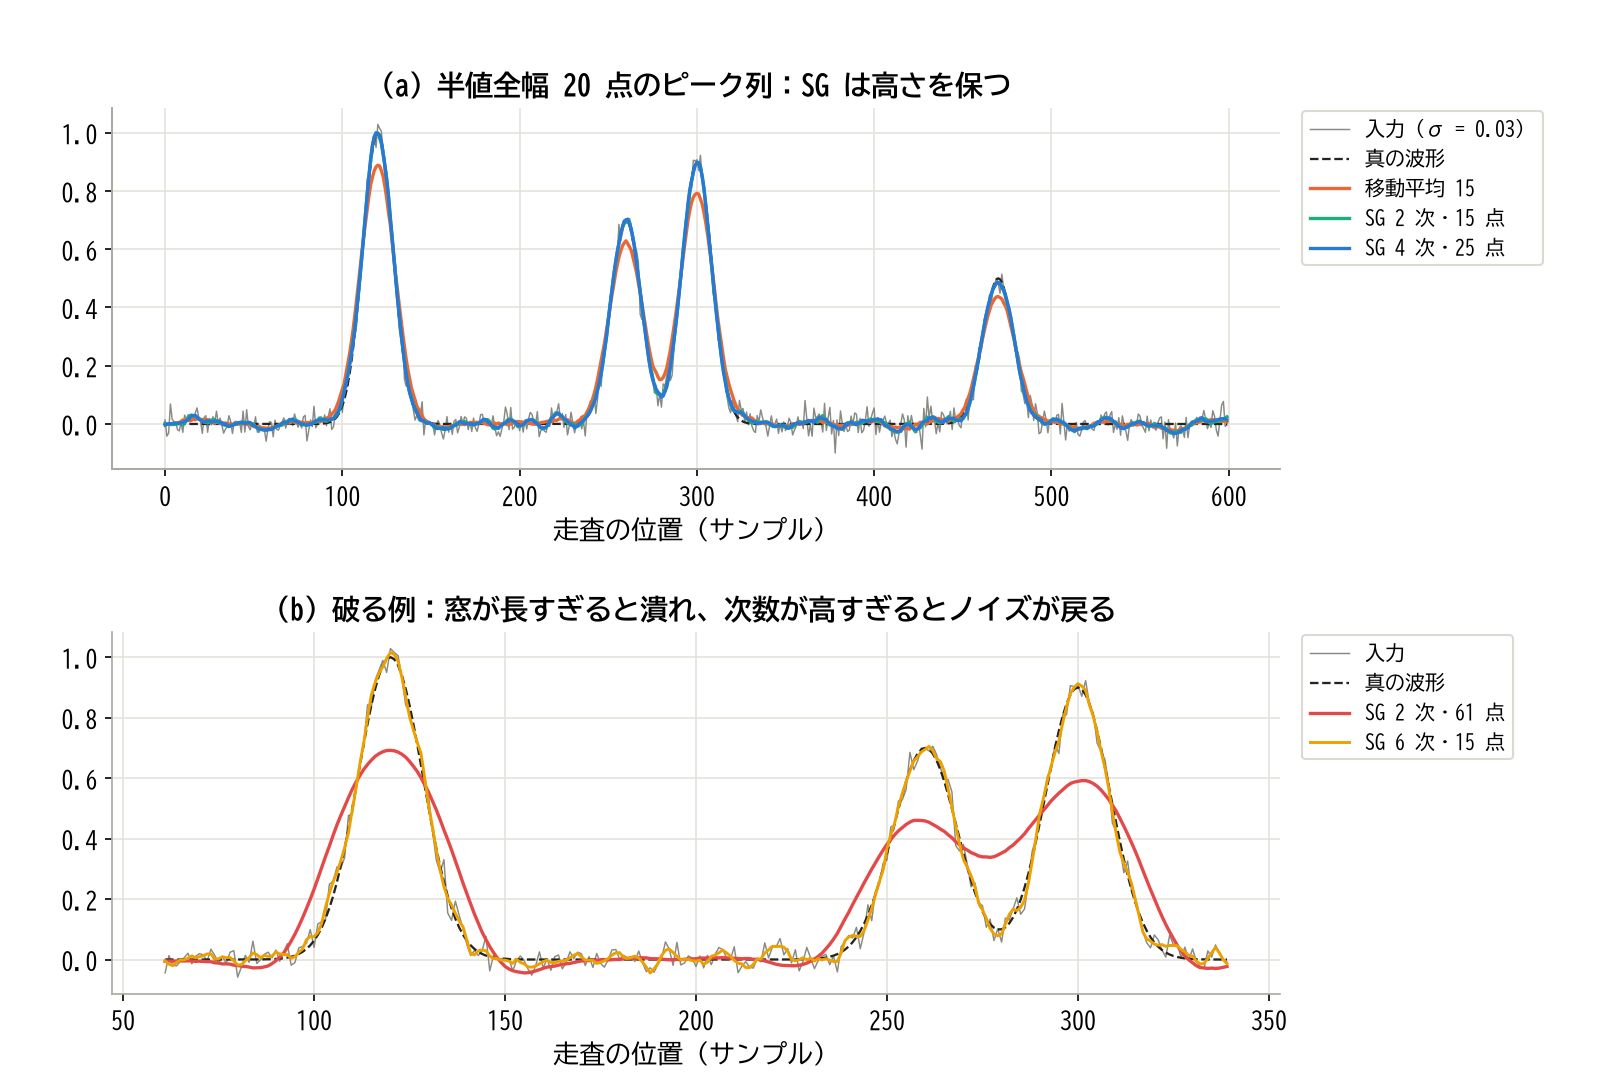
(a) 窓をピーク幅に合わせた SG(緑、青)は高さを保つ。(b) 破る例:窓がピークの 3 倍(赤)だと潰れて谷が埋まる。次数が高すぎる(黄)とノイズが戻る
両端の 2 本のピーク(120 番目と 470 番目)の高さと幅の誤差、ピークのない区間のノイズの RMS を並べます。
| 方式 | 高さ | 半値全幅 | ノイズの RMS |
|---|---|---|---|
| 移動平均 15 | −11.8 % | +15.0 % | 0.009 |
| SG 2 次 15 点 | −1.5 % | +3.4 % | 0.013 |
| SG 4 次 25 点 | −1.6 % | +2.9 % | 0.013 |
| SG 2 次 61 点 | −31.4 % | +67 % | 0.004 |
| SG 6 次 15 点 | −0.2 % | +3.2 % | 0.021 |
移動平均 15 はノイズを最もよく減らしますが、高さを 12 % 削り、幅を 15 % 太らせます。SG 2 次 15 点は高さの誤差を −1.5 % に抑え、ノイズは入力の 0.03 を 0.013 まで減らしました。波形全体の RMS 誤差(形の誤差とノイズを合わせたもの)は、移動平均 15 が 0.029、SG 2 次 15 点が 0.012 で、SG が 2 倍以上良い結果です。
破る例 1:窓がピークより長い。 SG 2 次 61 点(窓が半値全幅の 3 倍)は、高さを 31 % 潰し、幅を 67 % 太らせ、近接した 2 本の間の谷を 0.34 まで埋めました。ノイズは 0.004 と最も小さいので、ノイズだけを見ていると良く見えるのが危ないところです。
破る例 2:次数が高すぎる。 SG 6 次 15 点は高さを −0.2 % まで保ちますが、ノイズの RMS は 0.021 で、入力の 0.03 から 3 割しか減っていません。分散比 c₀ が 1/3 で、2 次 15 点の 0.151 の 2 倍以上だからです。次数を上げると多項式がノイズにまで沿ってしまい、平滑化の意味が薄れます。次数は 2 か 4 から始めるのが基本です。
微分でピークの位置を求める: SG 2 次 15 点の微分器で、1 次微分が正から負へ 0 を横切る位置を線形補間で求めました。4 本のピークの位置の誤差は −0.26、+0.31、+0.15、−0.16 サンプルで、どれも ±0.31 サンプルの中に収まりました。素の差分で同じことをすると、ノイズで 0 交差がピークの近くに何回も現れ、位置が決まりません。
設計例 3:エンコーダの位置から速度
要件: #2 の設計例 2 と #5 の設計例 2 と同じエンコーダ(4000 カウント/回転、1 ms ごとに読む)で、速度を求める。1 サンプルの差分は 1 カウントが 15 rpm に相当して、値がガタつく。遅れは 5 ms 程度まで。
方式の候補: #2 の差分の移動平均 10 点(遅れ 4.5 ms)、#5 の定常カルマン(αβ フィルタ、α = 0.3306、β = 0.0661、遅れ 4.5 ms)、SG 微分 11 点 2 次(遅れ 5 ms)、SG 微分 19 点 4 次(遅れ 9 ms)。SG 微分 11 点 2 次は、位置に直線を最小 2 乗で当てはめて傾きを取るのと同じで、係数は j/(110\,T) (j = −5〜5)です。速度は #5 と同じく、1 次遅れで 0 → 1000 → 500 rpm と変えます。
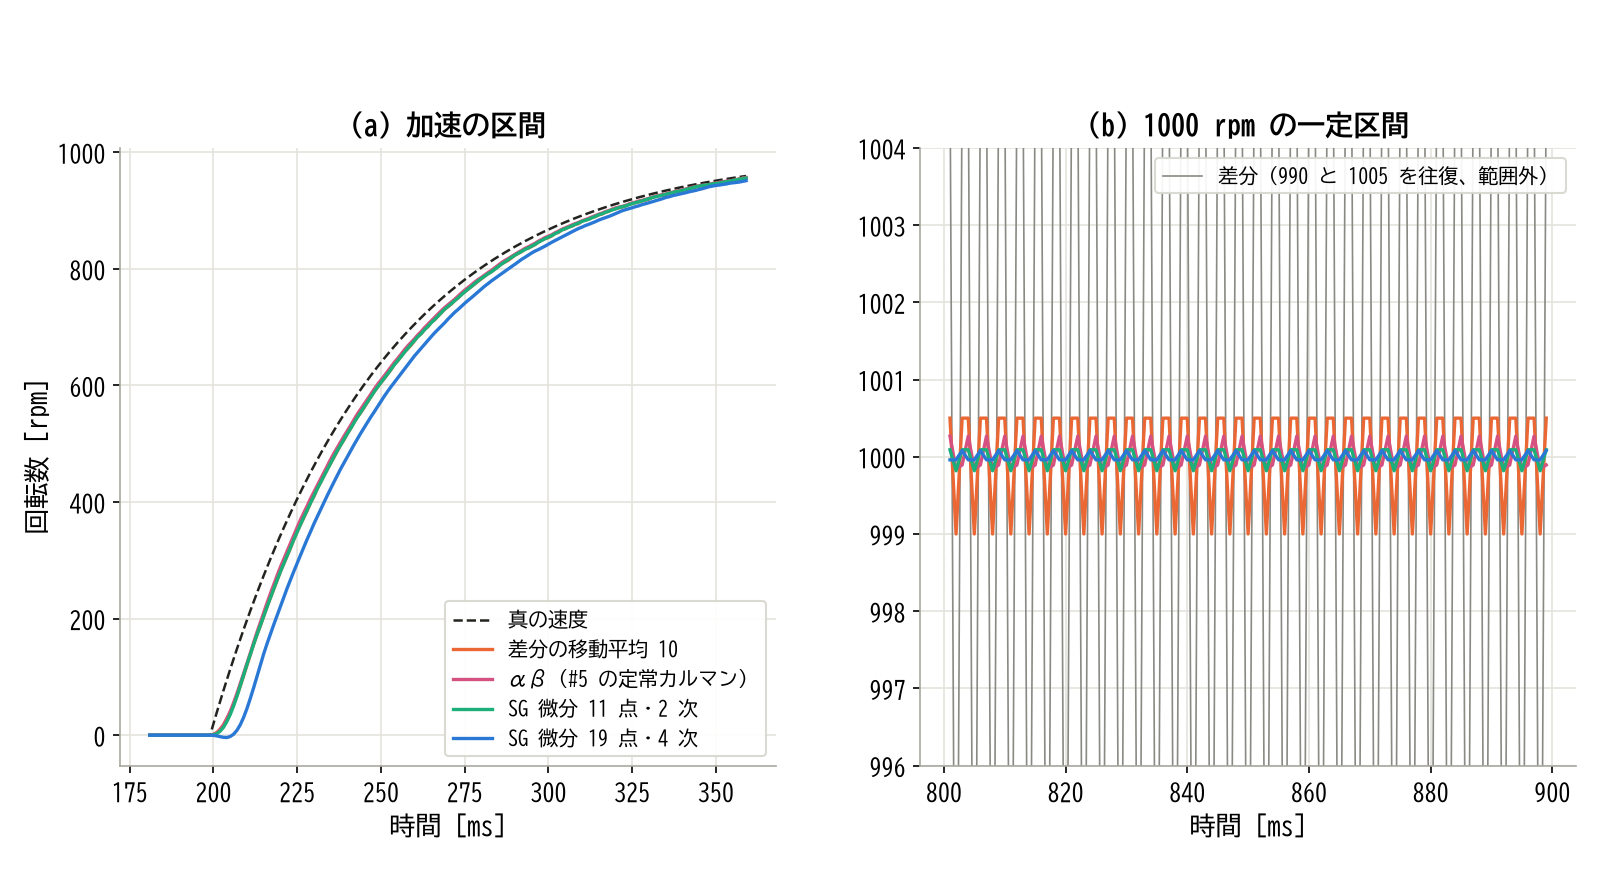
(a) 遅れはどれも窓の半分程度。(b) 一定の速度での揺れは、SG 微分 11 点が移動平均 10 点の 1/4 以下
5 つの方式の、一定の速度での揺れ、加速中の誤差、遅れを並べます。
| 方式 | 1000 rpm の RMS 誤差 | 加速中の最大誤差 | 遅れ |
|---|---|---|---|
| 差分 | 7.07 rpm | 14 rpm | 0.5 ms |
| 差分の移動平均 10 | 0.71 rpm | 81 rpm | 4.5 ms |
| αβ(#5) | 0.21 rpm | 76 rpm | 4.5 ms |
| SG 微分 11 点 2 次 | 0.16 rpm | 81 rpm | 5 ms |
| SG 微分 19 点 4 次 | 0.12 rpm | 152 rpm | 9 ms |
加速中の最大誤差は、ほとんどが遅れによるものです。SG 微分 11 点 2 次の出力を遅れの 5 サンプルだけ前へずらして比べると、最大誤差は 10.7 rpm まで下がります。同じ程度の遅れで比べると、一定の速度での揺れは、差分の移動平均 10 点の 0.71 rpm に対し、SG 微分 11 点 2 次は 0.16 rpm と 1/4 以下、#5 の αβ(0.21 rpm)よりも小さくなりました。
なぜ移動平均より良いのかは、係数で読めます。差分の移動平均 10 点は (c[n] - c[n-10])/(10T) と同じで、窓の両端の 2 点しか使っていません。SG 微分は 11 点すべてに傾きの重みを付けて使うので、同じ窓でノイズが減ります。白色ノイズとして計算した標準偏差の比は \sqrt{2/100}\big/\sqrt{1/110} = 1.48 倍です。この例の差(4.4 倍)がそれより大きいのは、エンコーダの丸め誤差が白色ではなく、速度に応じた周期的なパターンを持つからで、#5 で注意したのと同じ事情です。値は速度によって変わります。
#5 の αβ との違いは、モデルの有無です。αβ は「速度がほぼ一定」という等速モデルを持ち、状態 2 個で動きます。SG 微分はモデルを持たず、窓の中の点に多項式を当てるだけで、窓の点をメモリに持ちます。4 次 19 点は、一定区間の揺れを 0.12 rpm まで減らしますが、遅れが 9 ms に伸びます。速度をループの中で使うなら、遅れの 5 ms で位相余裕を計算してから決めます。
✅ 検証
設計例の結論が、たまたまの乱数や窓の選び方に頼っていないかを確かめます。
ルート信号と分散比
- ルート信号のテスト:窓 5 で、ステップとランプの出力誤差は 0、幅 2(= k)のパルスは消え、幅 3(= k+1)のパルスは残った(ルート信号の図)。正弦波(周期 8)は頂点が平らになり、ルートではない
- くり返しで落ち着くか:長さ 200 のガウスノイズは 6 回のくり返しで変わらなくなった。定理の上限(99 回)の内側
- 中央値の分散比:同じ窓の移動平均に対する比は、窓 3 で 1.35、5 で 1.44、9 で 1.49、51 で 1.55 で、π/2 = 1.571 に下から近づいた。窓 21 では、シードを変えた 3 回で 1.525、1.536、1.535
外れ値の破壊点
- 連続した外れ値:窓 7 の Hampel で、外れ値が 3 個(= k)続く場所は出力の最大値 0.035 まで消え、4 個(= k+1)続く場所は 1.0 のまま残った
- MAD = 0:σ = 0.3 LSB の量子化された列で、窓の 99.4 % が MAD = 0。下限なしの置き換え率 11.8 % が、下限 1 LSB で 1.2 %(本物の外れ値の割合と一致)に下がった
SG の周波数応答とピーク
- 係数:5 点 2 次の係数は手計算の (−3, 12, 17, 12, −3)/35 と一致。2 次式の入力は誤差 0 で通る
- 分散比:SG 2 次の分散比 \sum c_j^2 は c₀ と一致し(5 点で 17/35)、シミュレーションの 0.485 とも合った
- 近似式:−3 dB の近似式の誤差は k = 25 で −5〜+2 %、k = 5 で +31〜36 %
- ピーク:設計例 2 の高さの誤差は、移動平均 15 で −11.8 %、SG 2 次 15 点で −1.5 %
窓を 2 倍・半分にしても、シードを変えても
設計例 1 と 2 を、シード 3 通りで窓を変えて計算し直しました。設計例 1 は段差のない 60 秒の列、設計例 2 は半値全幅 20 点のピーク 1 本です。
| 項目 | シード A | シード B | シード C |
|---|---|---|---|
| メディアン 5 の最大誤差 | 5 mm | 5 mm | 5 mm |
| メディアン 9(2 倍)の最大誤差 | 3 mm | 3 mm | 4 mm |
| Hampel 7 の最大誤差 | 6 mm | 6 mm | 7 mm |
| メディアン 3(半分)の外れ値 | 通す | 通す | 通す |
設計例 2 のピークの高さの誤差は、次のとおりです。
| ピークの高さの誤差 | シード A | シード B | シード C |
|---|---|---|---|
| SG 2 次 15 点 | −0.4 % | −1.5 % | +1.8 % |
| SG 2 次 7 点(半分) | +0.5 % | +0.4 % | +1.4 % |
| SG 2 次 31 点(2 倍) | −6.7 % | −6.8 % | −4.7 % |
| 移動平均 15 点 | −11.8 % | −11.7 % | −9.9 % |
シード A は記事の図と同じ 20261105、B と C は 1 と 2 です。メディアン 3 は 3 通りとも 2 個続きの外れ値を通し、メディアン 5 以上は 3 通りとも消しました。SG 15 点のピークの誤差は ±2 % の中、窓を 2 倍にすると −5〜−7 % に悪化、移動平均は −10〜−12 % です。窓を変えても、シードを変えても、「窓の半幅は外れ値の連続より長く」「SG の窓はピークの幅以下に」という結論は変わりません。SG 15 点の誤差の符号がシードで変わるのは、ピークの頂上に乗ったノイズ(σ = 0.03)のためで、形の誤差(ノイズなしで −0.5 %)よりノイズの影響が大きいことを示しています。
チェックリスト
設計したフィルタを、手元のデータで確かめるときの 6 項目です。
- ルート信号を通す:ステップと、幅 k と k+1 のパルスを入れ、ステップは角まで残り、幅 k は消え、k+1 は残ることを確かめる
- 外れ値の連続の最大長を数える:データの中で外れ値が何サンプル続くかを数え、k がそれ以上あることを確かめる
- MAD = 0 の割合を数える(Hampel):窓の何割で MAD = 0 になるかを数え、高ければ \sigma_{\min} を付ける
- ピークの高さの誤差を測る(SG):ノイズのない形(または長く平均した形)を通し、高さと半値全幅の誤差を見る
- 分散比を測る:ピークのない区間の RMS を入力と比べ、表の値に近いかを見る
- ループに入れるなら位相余裕を計算する:遅れ kT を 360^\circ\, f_{gc}\, kT の位相として見積もる
🕳️ 落とし穴
窓の偶奇と中心
窓の長さを偶数にすると、中央値は真ん中の 2 個の平均になり、入力にない値が出ます。中心も半サンプルずれます。SG も、偶数の窓では中心が点と点の間に来ます。平滑化の窓は 2k+1 の奇数にそろえるのが基本です。
因果にすると k 遅れる
中心をそろえた式は、未来の k 点を使います。リアルタイムでは、出力は k サンプル遅れます。ループの中では、この遅れが位相余裕を 360^\circ\, f_{gc}\, kT だけ減らします。SG を −3 dB だけで選ぶと、遅れの大きさに気づきにくい点に注意します。
端の処理
起動直後やデータの端は、窓がはみ出します。SciPy の medfilt は、ドキュメントのとおり端の外を 0 で埋めます。値が 500 前後のデータなら、端の出力が 0 の側へ引っ張られます。実装の節の median_filter は、端の値をくり返して埋めています。SG の端は、前の章で見たとおり、端の 2k+1 点に当てた多項式で評価します。マイコンでは、起動時に窓を最初の値で埋めておくと、立ち上がりで 0 が出るのを防げます。
量子化で MAD = 0
整数の列で、ノイズが 1 LSB より小さいと、窓の過半数が同じ値になって MAD = 0 になり、1 LSB の揺れが全部外れ値になります。σ̂ に下限 \sigma_{\min} (1 LSB など)を付けます。データの端でも起きやすく、実装の節の手計算の数列でも、末尾の窓(同じ 103 が 4 個並ぶ)で MAD = 0 になります。
外れ値の連続
外れ値が k+1 個以上続くと、メディアンも Hampel も通します。I²C のバスが一時的に止まって、同じ失敗の値が何回も返るような場合です。外れ値が続く最大の長さを先に調べ、k をそれ以上にします。それでも足りないほど長く続くなら、平滑化ではなく、センサの状態フラグや CRC で値を捨てる仕組みが要ります。
SG の阻止域の漏れ
SG は通過域が平らな代わりに、阻止域の山が移動平均より高く残ります。高い周波数のノイズ(PWM のリップルなど)を深く落としたいなら、SG だけに頼らず、前段か後段に #2 のローパスや #4 のノッチを置きます。
SG の係数の整数化と丸め
SG の係数は、整数の分子と共通の分母(5 点 2 次なら 35)で書けます。固定小数点では、整数の係数で積和を取ってから分母で割ると、丸めが 1 回で済みます。分母が 2 のべき乗でないので割り算が要りますが、定数の割り算はコンパイラが掛け算とシフトに直します。窓の長い SG や高い次数では、係数を正規方程式から計算するときに桁落ちに注意します。
j^q
をそのまま並べると、k = 40、q = 6 で
10^{9}
を超える値が並び、
\mathbf{V}^{\mathsf{T}}\mathbf{V}
の逆行列が不正確になります。この記事の図を作る途中でも、窓 85 点 4 次の係数がこれで崩れ、−3 dB の計算が止まりました。実装の節の savgol_coeffs は、j を k で割って桁をそろえてから解いています。
マイコンでの並べ替えの計算量
メディアンは、毎サンプル並べ替えが要ります。窓 5〜9 なら、固定の比較の並び(ソーティングネットワーク)や挿入ソートで十分速く、窓 5 の中央値は比較と入れ替え 7 回で求まります。窓をずらすたびに全部を並べ直すのではなく、出ていく 1 個を抜いて入ってくる 1 個を差し込めば、1 サンプルあたり O(k) で済みます。画像のように窓が大きい場合は、Huang ら(1979)の、窓の中の値のヒストグラムを更新していく方法が知られています。
💻 実装
C:median-of-5 と running median
#1 の biquad と同じく、状態を構造体に持って 1 サンプルずつ処理します。窓 5 の中央値は、比較と入れ替えの固定の並びで求めます。窓 2k+1 の running median は、届いた順の値(リングバッファ)と、小さい順の値の 2 本の配列を持ちます。
#include <stdint.h>
#include <math.h>

#define SWAP(a, b) do { if ((a) > (b)) { float t_ = (a); (a) = (b); (b) = t_; } } while (0)

/* 窓 5 の中央値(比較と入れ替え 7 回) */
float median5(float a, float b, float c, float d, float e)
{
    SWAP(a, b); SWAP(d, e); SWAP(a, d); SWAP(b, e);
    SWAP(b, c); SWAP(c, d); SWAP(b, c);
    return c;
}

#define RM_K   3                 /* 半幅 k */
#define RM_N   (2 * RM_K + 1)    /* 窓の長さ 2k+1 */

typedef struct {
    float ring[RM_N];    /* 届いた順の値 */
    float sorted[RM_N];  /* 小さい順の値 */
    int head;            /* 次に上書きする位置(いちばん古い値) */
} RunMedian;

void rm_init(RunMedian *s, float x0)
{
    for (int i = 0; i < RM_N; i++) {
        s->ring[i] = x0;         /* 起動時は最初の値で埋める */
        s->sorted[i] = x0;
    }
    s->head = 0;
}

/* 戻り値は直近 2k+1 点の中央値(k サンプル遅れ)。1 サンプル O(k) */
float rm_update(RunMedian *s, float x)
{
    float old = s->ring[s->head];
    s->ring[s->head] = x;
    s->head = (s->head + 1) % RM_N;

    int i = 0;
    while (s->sorted[i] != old) i++;          /* 抜ける値の位置 */
    while (i > 0 && s->sorted[i - 1] > x) {    /* 穴を左へ */
        s->sorted[i] = s->sorted[i - 1];
        i--;
    }
    while (i < RM_N - 1 && s->sorted[i + 1] < x) {  /* 穴を右へ */
        s->sorted[i] = s->sorted[i + 1];
        i++;
    }
    s->sorted[i] = x;
    return s->sorted[RM_K];
}
median5 は、0〜4 の値の 5 個の並びのすべて(3125 通り)と、乱数の 10 万組で、並べ替えて真ん中を取った値と一致しました。rm_update は、抜ける値の位置に空いた穴を、新しい値が入るべき位置まで動かしてから差し込みます。並べ替えの全体をやり直さないので、窓 7 なら 1 サンプルあたり多くて 7 回の比較と移動で済みます。
C:Hampel(窓 7、MAD の下限つき)
running median に、MAD の計算を足します。判定するのは窓の中央の値(k サンプル前に届いた値)なので、出力は k サンプル遅れます。
/* Hampel:窓 2k+1、しきい値 gamma、sigma_hat の下限 sigma_min */
float hampel_update(RunMedian *s, float x, float gamma, float sigma_min, int *replaced)
{
    float m = rm_update(s, x);
    float center = s->ring[(s->head + RM_K) % RM_N];   /* 窓の中央の値 */
    float dev[RM_N];
    for (int i = 0; i < RM_N; i++) {                   /* |x - m| を挿入ソート */
        float d = fabsf(s->ring[i] - m);
        int j = i;
        while (j > 0 && dev[j - 1] > d) {
            dev[j] = dev[j - 1];
            j--;
        }
        dev[j] = d;
    }
    float sigma = 1.4826f * dev[RM_K];                 /* 1.4826 * MAD */
    if (sigma < sigma_min) sigma = sigma_min;          /* MAD = 0 の対策 */
    *replaced = fabsf(center - m) > gamma * sigma;
    return *replaced ? m : center;
}
replaced を数えれば、外れ値の回数をログに残せます。設計例 1 のとおり、sigma_min を 0 にすると、量子化された静かな列でこの回数が膨らみます。
C:SG の FIR(整数係数)
5 点 2 次の平滑化と微分です。int16_t の入力に整数の係数を掛け、int32_t で積和を取ってから 35 で割ります。
/* Savitzky-Golay 5 点 2 次:(-3, 12, 17, 12, -3) / 35。x[0] が最も古い */
int16_t sg5_smooth(const int16_t x[5])
{
    int32_t acc = -3 * x[0] + 12 * x[1] + 17 * x[2] + 12 * x[3] - 3 * x[4];
    /* 35 で割って四捨五入(負の数も対称に丸める) */
    return (int16_t)(acc >= 0 ? (acc + 17) / 35 : -((-acc + 17) / 35));
}

/* 5 点 2 次の 1 次微分:(-2, -1, 0, 1, 2) / (10 T)。戻り値は「1 サンプルあたりの変化 × 10」 */
int32_t sg5_deriv_x10(const int16_t x[5])
{
    return -2 * x[0] - x[1] + x[3] + 2 * x[4];
}
出力は x[2](窓の真ん中)の時刻の値なので、最新の値から 2 サンプル遅れます。積和の最大は、入力が ±32767 のとき (3+12+17+12+3) \times 32767 \approx 1.5\times10^6 で、int32_t に十分収まります。微分は 10 で割らずに返しているので、使う側で 10T で割ります。
この 3 つの C の関数(running median、Hampel、SG)は、0 と 4095 の外れ値と MAD = 0 の区間を含む 3000 サンプルの入力に対して、同じ処理を Python で書いた結果と全点で一致しました(MSVC、/O2)。
Python:4 つの関数
SciPy の scipy.signal.medfilt、savgol_filter、savgol_coeffs が同じことをしますが、中身が見えるように自前で書きます。
import numpy as np


def median_filter(x, k):
    """窓 2k+1 の中央値。端は端の値をくり返して埋める(中心そろえ)。"""
    x = np.asarray(x, dtype=float)
    xp = np.concatenate([np.full(k, x[0]), x, np.full(k, x[-1])])
    return np.array([np.median(xp[n:n + 2 * k + 1]) for n in range(len(x))])


def hampel(x, k, gamma=3.0, sigma_min=0.0):
    """窓 2k+1 の Hampel。|x - m| > gamma * sigma_hat なら m に置き換える。"""
    x = np.asarray(x, dtype=float)
    xp = np.concatenate([np.full(k, x[0]), x, np.full(k, x[-1])])
    y = x.copy()
    flag = np.zeros(len(x), dtype=bool)
    for n in range(len(x)):
        w = xp[n:n + 2 * k + 1]
        m = np.median(w)
        s = max(1.4826 * np.median(np.abs(w - m)), sigma_min)
        if abs(x[n] - m) > gamma * s:
            y[n] = m
            flag[n] = True
    return y, flag


def savgol_coeffs(k, q, deriv=0, delta=1.0):
    """窓 2k+1・次数 q の SG 係数 c[j](j = -k..k の順)。y[n] = sum_j c[j] x[n+j]。"""
    u = np.arange(-k, k + 1) / k                 # j を k で割って桁をそろえる
    V = np.vander(u, q + 1, increasing=True)     # V[j, i] = (j/k)**i
    G = np.linalg.solve(V.T @ V, V.T)            # 行 i が多項式の i 次の係数を出す
    return G[deriv] * np.prod(np.arange(1, deriv + 1)) / (k * delta) ** deriv


def savgol(x, k, q, deriv=0, delta=1.0):
    """中心そろえの SG。両端の k 点は端の 2k+1 点に当てた多項式で評価する。"""
    x = np.asarray(x, dtype=float)
    N = len(x)
    c = savgol_coeffs(k, q, deriv, delta)
    y = np.empty(N)
    for n in range(k, N - k):
        y[n] = c @ x[n - k:n + k + 1]
    P = np.polynomial.polynomial
    j = np.arange(-k, k + 1)
    ends = ((x[:2 * k + 1], np.arange(k), -k),           # 先頭の窓:位置 -k..-1
            (x[-(2 * k + 1):], np.arange(N - k, N), 1))  # 末尾の窓:位置 1..k
    for seg, idx, p0 in ends:
        a = P.polyder(P.polyfit(j, seg, q), deriv)
        y[idx] = P.polyval(p0 + np.arange(k), a) / delta ** deriv
    return y
savgol_coeffs は、正規方程式
(\mathbf{V}^{\mathsf{T}}\mathbf{V})\mathbf{a} = \mathbf{V}^{\mathsf{T}}\mathbf{x}
の解の行列 G の、deriv 番目の行を取り出しています。j を k で割ったぶん、微分では
k^{\text{deriv}}
で割り戻します。SciPy との一致は次のとおりでした。
median_filter:scipy.ndimage.median_filter(x, 2k+1, mode="nearest")と全点一致。scipy.signal.medfiltとは内側が一致し、端だけが違う(medfiltは 0 で埋めるため)savgol_coeffs:scipy.signal.savgol_coeffs(2k+1, q, deriv, use="dot")と、窓 5〜25 で差 10^{-15} 程度。useを省くと畳み込み用に順番が逆になるsavgol:scipy.signal.savgol_filter(x, 2k+1, q, deriv, mode="interp")と差 10^{-13} 以下
手計算を確かめる
本文の 3 つの手計算を、上の関数でたどります。
x = np.array([100, 102, 101, 0, 103, 102, 104, 101, 103], float)
print(median_filter(x, 2))
y, flag = hampel(x, 3, 3.0)
print(y, flag.astype(int))
c = savgol_coeffs(2, 2)
print(c * 35, savgol_coeffs(2, 2, deriv=1) * 10)
print(c @ [2, 5, 9, 6, 3], c @ [1, 4, 9, 16, 25])
出力は次のとおりです。
[100. 100. 101. 102. 102. 102. 103. 103. 103.]
[100. 102. 101. 102. 103. 102. 104. 103. 103.] [0 0 0 1 0 0 0 1 0]
[-3. 12. 17. 12. -3.] [-2. -1.  0.  1.  2.]
7.714285714285714 9.0
1 行目の n = 2、3、4 は、メディアンの手計算の 101、102、102 です。2 行目の n = 3 は 0 を 102 に置き換え、n = 4、5 は 103、102 のまま残しています(Hampel の手計算)。末尾の n = 7 も置き換わっていますが、これは端を 103 で埋めた窓で MAD = 0 になったためで、落とし穴の節の「データの端でも起きやすい」の実例です。3 行目と 4 行目は、SG の係数と、山の形と 2 次式の手計算の値です。
💡 活用事例
平滑化の 3 つは、それぞれ生まれた分野があります。分野ごとに、なぜその方法なのかを見ます。
- 分光と分析化学(SG):Savitzky と Golay の 1964 年の論文は Analytical Chemistry 誌に載った。スペクトルのピークの高さ、幅、位置が知りたい量そのもので、移動平均で削ると測定値が変わる。微分も同じ係数の表で求まるので、ピークの位置を 0 交差から読める(設計例 2)
- 画像の塩胡椒ノイズ(メディアン):画素がところどころ白や黒に飛ぶノイズは、幅 1 の外れ値そのもの。メディアンは輪郭(段差)を残すので、ぼかさずに消せる。窓が大きい 2 次元のメディアンを速く計算する方法として、Huang ら(1979)のヒストグラムを使う方法がある
- 音声の特徴量の平滑化(メディアンと線形の組み合わせ):Rabiner らの 1975 年の論文は、Tukey の非線形平滑化を音声処理に使った。局所的に粗く、しかも急な不連続を持つデータは、線形の平滑化だけでは扱いにくい、というのが動機
- 工業プロセスのデータ(Hampel):Pearson(2002)は、プロセスのモデルを同定するデータに外れ値が混じると同定の結果が大きく崩れることを示し、Hampel フィルタを掃除の道具として紹介した。Pearson ほか(2016)は、イタリアの月次の鉱工業生産指数のような、外れ値の目立つ経済の時系列にも当てている
- データを眺める(Tukey):メディアンフィルタを導入した Tukey の『Exploratory Data Analysis』(1977)は、データを手で眺めて傾向をつかむ方法の本。外れ値に引きずられない中央値は、その考え方の中心にある
- センサの読み飛ばしとエンコーダ(この記事の設計例):I²C の読み取りの失敗、エンコーダの位置からの速度。GNSS の測位や IMU のように、ときどき大きく外れた値が混じるセンサの列にも、同じ考え方を当てはめられる
どの例も、知りたい量が「形」か、ノイズが「外れ値」かのどちらかです。普通のガウスノイズを均すだけなら、#2 のローパスのほうが軽く、ノイズもよく減ります。
🧭 使い分けの勘所:メディアン・Hampel・SG
ここまでの結果を、判断の材料としてまとめます。方式を選ぶ前に、そもそも平滑化が要るのかから確かめます。
判断の軸
方式を決める前に答えておく 8 つの問いです。上から順に、手元の信号について確かめます。
| 軸 | 調べること | 方向 |
|---|---|---|
| ① 外れ値 | 外れ値はあるか | あればメディアンか Hampel |
| ② 外れ値の幅 | 最大で何サンプル続くか | k をそれ以上に |
| ③ 保ちたい形 | 角か、ピークか、傾きか | 角はメディアン、ピークと傾きは SG |
| ④ 遅れ | ループの中か、後で処理か | ループなら kT で位相余裕を計算 |
| ⑤ 線形性 | 伝達関数で設計したいか | 要るなら SG か #2 のローパス |
| ⑥ 普段の値 | 外れ値でない値を触ってよいか | 触りたくないなら Hampel |
| ⑦ 微分 | 速度や傾きが要るか | SG 微分器 |
| ⑧ 計算と数値 | 固定小数点か、窓の長さは | メディアンは窓 9 程度まで、SG は整数係数 |
④が抜けがちです。SG は −3 dB で比べると移動平均と似た振幅特性に見えますが、遅れは 2.5〜4 倍です。ループの中に入れるなら、−3 dB ではなく遅れで選びます。
5 つの方式の比較
この記事の 3 つを、同じ項目で並べます。数値は本文の計算の値です。
| 項目 | メディアン | Hampel | SG |
|---|---|---|---|
| 線形か | いいえ | いいえ | はい |
| 外れ値 | 幅 k まで消す | 幅 k まで消す | 残る(形を変える) |
| 角(ステップ) | 保つ | 保つ | 前後に約 8 % の波 |
| ピーク | 頂上を平らに | 保つ | 窓が幅以下なら保つ |
| ガウスノイズ | 移動平均の約 π/2 倍の分散 | ほぼ減らない | 分散比 c₀ |
| 遅れ(因果) | kT | kT | kT |
| 計算 | 並べ替え O(k) | 並べ替え+MAD | 積和 2k+1 回 |
| 破る例 | 外れ値の連続 | 連続、MAD = 0 | 窓が長い、次数が高い |
比較のために、#2 の 2 つも同じ項目で並べます。
| 項目 | 移動平均 | 1 次 IIR |
|---|---|---|
| 外れ値 | 窓の幅の台形に広げる | 長い尾を引く |
| 角(ステップ) | 窓の幅の坂 | 指数の立ち上がり |
| ピーク | 削る | 削って遅らせる |
| ガウスノイズ | 1/(2k+1)(同じ窓で最良) | α/(2−α) |
| 計算 | 積和(リングバッファ) | 積和 2 回 |
決定木
同じ判断を 1 本の流れにします。上から順に答えていくと、方式と窓の決め方に着きます。
混じる?"] -->|はい| B["普段の値を
残したい?"] A -->|いいえ| C["形を
保ちたい?"] B -->|はい| D["Hampel
γ = 3
σ に下限"] B -->|いいえ| E["メディアン
k ≥ 連続"] C -->|はい| F["ループの
中?"] C -->|いいえ| G["#2 の
ローパス"] F -->|はい| H["SG を
遅れ k
で選ぶ"] F -->|いいえ| I["SG 2 次
窓 ≤
半値全幅"]
図の「普段の値を触りたくない」は、正弦波の頂点や小さな段差のような細部を残したい、という意味です。外れ値を消したあとにノイズも均したいなら、メディアンか Hampel のあとに SG か移動平均をつなぎます。Rabiner らが使った Tukey の平滑化も、メディアンと線形のフィルタを組み合わせたものでした。
用途別の早見表
よくある場面ごとに、最初に試す方式と窓の目安を並べます。
| 用途 | 方式 | 目安 |
|---|---|---|
| I²C センサの読み飛ばし | メディアン 5 | k ≥ 連続の長さ |
| 外れ値の回数を記録したい | Hampel 7、γ = 3 | σ 下限 1 LSB |
| 分光などのピーク列 | SG 2 次 | 窓 ≤ 半値全幅 |
| ピークの位置 | SG 微分の 0 交差 | 窓 ≤ 半値全幅 |
| エンコーダの速度 | SG 微分 2 次 | 遅れ kT で選ぶ |
| 画像の点状のノイズ | メディアン 3×3 | 輪郭を残す |
| ループの中のスパイク除去 | メディアン 3〜5 | 遅れ k を位相余裕へ |
| 白色ノイズだけ | #2 のローパス | 平滑化は不要 |
勘所
- スパイクならメディアン 3 か 5 から:k は外れ値が続く最大の長さ以上。1 個ずつならメディアン 3、2 個続くならメディアン 5
- 普段の値を残したいなら Hampel、ただし σ̂ に下限を:量子化された列では MAD = 0 が普通に起きる。下限は 1 LSB か、データシートのノイズの値
- 形を保つなら SG 2 次、窓はピークの半値全幅以下:4 次なら半値全幅の 1.8 倍まで。次数を上げすぎるとノイズが戻る
- SG の比較は「同じ窓」と「同じ −3 dB」を区別する:同じ窓なら SG は形を保つ代わりにノイズが残る。同じ −3 dB なら振幅特性は似るが、遅れは 2.5〜4 倍
- ループの中なら線形の遅れとして見積もる:メディアンも SG も、遅れ kT で位相余裕が 360^\circ f_{gc} kT 減る
- 微分は素の差分でなく SG 微分:5 点 2 次で、白色ノイズの増幅が後退差分の 1/4.5
- ガウスノイズを減らすなら移動平均が最良:同じ窓ならメディアンの分散は約 π/2 倍、Hampel はほとんど減らさない
- 端と起動を決めておく:SciPy の
medfiltは 0 で埋める。マイコンは最初の値で窓を埋める
✅ まとめ
- 平滑化は、形を保ったままノイズと外れ値を減らす処理で、周波数ではなく「外れ値への反応」と「形が残るか」で評価する。線形でないメディアンと Hampel、形を保つ線形の SG の 2 系統がある
- メディアンは窓の中央値。一定の区間(k+1 個以上)とエッジだけの信号は変わらず(ルート信号の定理)、幅 k 以下のパルスは消え、k+1 以上は残る。ガウスノイズでは分散が同じ窓の移動平均の約 π/2 倍で、ラプラス分布では中央値が最尤推定になる
- Hampel は、窓の中央値 m と \hat\sigma = 1.4826\,\mathrm{MAD} を使い、 |x - m| > \gamma\hat\sigma のときだけ m に置き換える。γ = 0 でメディアン、γ → ∞ で素通し。量子化で MAD = 0 になると 1 LSB の揺れまで置き換えるので、σ̂ に下限を付ける
- SG は窓の中で q 次の多項式を最小 2 乗で当てはめた中心の値で、係数が前もって計算できる FIR。5 点 2 次は (−3, 12, 17, 12, −3)/35。通過域は O(\omega^{q+2}) まで平らだが、阻止域の漏れは大きく、遅れは kT
- 同じ −3 dB 20 Hz で比べると、SG は通過域が平らな代わりに遅れが 2.5〜4 倍で、#2 の制御ループでは 2 次 53 点で位相余裕がほぼ 0°。ループの中では遅れ k で窓を決める
- メディアンは伝達関数を持たず、正弦波の利得が雑音との比で変わる。ループの中では群遅延 k の FIR と同じ遅れとして見積もれ、スパイクだけを消す
- 設計例では、読み飛ばしのスパイクをメディアン 5 が全部消し(移動平均 5 は 84 点で 10 mm 超)、ピーク列で SG 2 次 15 点が高さの誤差を −1.5 %(移動平均は −11.8 %)に抑え、エンコーダの速度で SG 微分 11 点が一定速度の揺れを差分の移動平均の 1/4 以下にした
- 落とし穴は、窓の偶奇、因果の遅れ、端の処理、MAD = 0、外れ値の連続、SG の阻止域の漏れ、係数の桁落ち、並べ替えの計算量
ここまでで、外れ値と形という 2 つの物差しで方式を選び、窓を外れ値の連続とピークの幅と遅れから決め、ルート信号のテストと分散比と位相余裕で判定できるようになりました。次の一手は、手元のセンサのログで外れ値が何サンプル続くかを数え、この記事の Python の median_filter と hampel に通して、置き換えた回数と MAD = 0 の割合を確かめることです。
次回の #10 は「検出」です。1 つの周波数の強さだけを軽く測る Goertzel、既知の波形を雑音の中から探す整合フィルタ、位相を 90° 回して包絡線を取り出すヒルベルト変換を、同じ流儀で式から設計します。
よくある質問(FAQ)
Q. メディアンと移動平均は、どちらを使えばいいですか?
A. 外れ値(スパイク)が混じるならメディアン、混じらないなら移動平均です。外れ値がない白色ノイズに対しては、同じ窓で移動平均のほうが分散を約 2/3 にでき、計算も軽くなります。外れ値が混じると、移動平均はそれを窓の幅の台形に広げます。両方が混じるなら、メディアンで外れ値を落としてから、移動平均や SG で均します。
Q. 窓の長さはどう決めますか?
A. 3 つの条件から決めます。外れ値を消すなら、半幅 k を外れ値が続く最大の長さ以上に。形を保つなら、窓をピークの半値全幅以下に(SG 2 次の場合)。ループの中なら、遅れ kT による位相の遅れ 360^\circ f_{gc} kT を位相余裕から引いて、許せる範囲に。3 つが両立しないときは、目的ごとにフィルタを分けて直列につなぎます。
Q. Hampel の γ は 3 でいいですか?
A. 出発点としては 3 で十分です。Pearson ほか(2016)の数値シミュレーションでは、1.0〜6.5 の広い範囲で外れ値の除去が良好でした。注意したいのは、窓が短いと MAD がばらつき、γ = 3 でも普通の値を置き換える率が 0.27 % ではなく、窓 7 で約 5 % になることです。置き換えの回数を記録して使うなら、窓を伸ばすか γ を上げ、整数のデータなら σ̂ に下限を付けます。
Q. SG の次数と窓はどう選びますか?
A. 次数は 2 から始めます。2 次は 3 次と同じ平滑化の係数になり、ピークの頂上の曲がりに沿えます。窓は、2 次ならピークの半値全幅以下、4 次なら 1.8 倍以下が、高さの誤差を 2 % 以内にする目安でした。次数を上げると同じ窓でも形をよく保ちますが、ノイズが残ります(分散比 c₀ が上がる)。6 次 15 点では、ノイズが入力の 7 割残りました。
Q. 微分は SG と差分のどちらがいいですか?
A. ノイズのあるデータなら SG 微分器です。5 点 2 次で、白色ノイズの増幅は後退差分の 1/4.5 になり、高い周波数を持ち上げません。差分が向くのは、ノイズがほとんどなく、遅れを 1 サンプルも増やしたくない場合です。エンコーダの例のように遅れを数 ms 許せるなら、11 点 2 次の SG 微分器は、差分の移動平均や #5 の αβ フィルタより一定速度の揺れが小さくなりました。
関連記事
この連載:
- #1 基礎編 — FIR と群遅延、白色ノイズの測り方、分散比
- #2 ローパスフィルタの設計 — 移動平均の伝達関数と、制御ループの位相余裕
- #3 ハイパスフィルタの設計 — DC とドリフトを消す
- #4 バンドパスとノッチの設計 — SG で落としきれない周波数を狙って消す
- #5 カルマンフィルタの設計 — エンコーダの速度を αβ で求める
- #6 EKF・UKF の設計 — 線形でない対象へ広げる
- #7 パーティクルフィルタの設計 — 線形でないフィルタを PSD で読む流儀
- #8 適応フィルタの設計 — SG の正規方程式と同じ形のウィーナー解
- #10 検出のフィルタの設計 — Goertzel・整合フィルタ・ヒルベルト変換
- #11 レート変換のフィルタの設計 — CIC・コム・オールパス
センサの入口:
- 加速度センサ KXR94-2050 で作るデジタル水平器 — センサの値を読んで平滑化する題材
参考
取得日はいずれも 2026-11-10 です。図と数値はすべて筆者が Python(NumPy、SciPy、Matplotlib)で計算したものです。乱数のシードは固定です。
Savitzky–Golay フィルタ
- A. Savitzky, M. J. E. Golay「Smoothing and Differentiation of Data by Simplified Least Squares Procedures」(Analytical Chemistry, 36(8), 1627–1639, 1964)
- J. Steinier, Y. Termonia, J. Deltour「Smoothing and differentiation of data by simplified least square procedure」(Analytical Chemistry, 44(11), 1906–1909, 1972)
- H. H. Madden「Comments on the Savitzky-Golay convolution method for least-squares-fit smoothing and differentiation of digital data」(Analytical Chemistry, 50(9), 1383–1386, 1978)
- P. A. Gorry「General least-squares smoothing and differentiation by the convolution (Savitzky-Golay) method」(Analytical Chemistry, 62(6), 570–573, 1990)
- R. W. Schafer「What Is a Savitzky-Golay Filter? [Lecture Notes]」(IEEE Signal Processing Magazine, 28(4), 111–117, 2011)
- M. Schmid, D. Rath, U. Diebold「Why and How Savitzky–Golay Filters Should Be Replaced」(ACS Measurement Science Au, 2(2), 185–196, 2022)
メディアンフィルタ
- J. W. Tukey「Nonlinear (nonsuperposable) methods for smoothing data」(Congress Record, EASCON-74, 673, 1974)
- J. W. Tukey「Exploratory Data Analysis」(Addison-Wesley, 1977)
- N. C. Gallagher, G. L. Wise「A theoretical analysis of the properties of median filters」(IEEE Trans. ASSP, 29(6), 1136–1141, 1981)
- T. S. Huang, G. J. Yang, G. Y. Tang「A fast two-dimensional median filtering algorithm」(IEEE Trans. ASSP, 27(1), 13–18, 1979)
- L. R. Rabiner, M. R. Sambur, C. E. Schmidt「Applications of a nonlinear smoothing algorithm to speech processing」(IEEE Trans. ASSP, 23(6), 552–557, 1975)
Hampel フィルタと頑健統計
- F. R. Hampel「The Influence Curve and Its Role in Robust Estimation」(Journal of the American Statistical Association, 69(346), 383–393, 1974)
- L. Davies, U. Gather「The Identification of Multiple Outliers」(Journal of the American Statistical Association, 88(423), 782–792, 1993)
- P. J. Rousseeuw, C. Croux「Alternatives to the Median Absolute Deviation」(Journal of the American Statistical Association, 88(424), 1273–1283, 1993)
- R. K. Pearson「Outliers in process modeling and identification」(IEEE Trans. Control Systems Technology, 10(1), 55–63, 2002)
- R. K. Pearson, Y. Neuvo, J. Astola, M. Gabbouj「Generalized Hampel Filters」(EURASIP Journal on Advances in Signal Processing, 2016:87, 2016)
教科書
- G. R. Arce「Nonlinear Signal Processing: A Statistical Approach」(Wiley)
- A. V. Oppenheim, R. W. Schafer「Discrete-Time Signal Processing」(Pearson)
ライブラリ