- 連載「Google AI 実験室」の #4 です。#1〜#3 はクラウドの Gemini API とブラウザの Google Labs を使いましたが、この回は Gemma 系のオープンモデルを Raspberry Pi 5 の中だけで動かします
- 使ったのは Raspberry Pi 5 8GB の CPU だけです。M.2 HAT+ に Hailo-8L を載せていますが、今回は使っていません。操作は PC から SSH で行いました
- API キーも課金プロジェクトも要りません。 #1 で作った環境は使っていません。モデルの重みは Hugging Face にログインしないまま取得できました
- Pi 5 での実測は 2026-10-11 に行いました。モデルの仕様・ベンチマークなど公式の数字は 2026-10-10 時点の表記です
- 検索に使った写真 99 枚は、すべて当サイトの記事に載せた写真です(重複を除き、長辺 1024px に縮小)
はじめに:撮りためた基板の写真を、クラウドに上げずに言葉で引けるか
試作のたびに基板の写真を撮ります。ファイル名は日付と連番だけで、半年後には「あのとき配線を直した基板」がどれだったか分かりません。この回のゴールは、手元の Raspberry Pi 5 で、写真を言葉で検索できるようにすることです。「赤い LED が光っている基板」「ブレッドボードに ESP32 を挿した写真」と打てば、ファイル名を覚えていなくても該当する写真が上位に並ぶ。それを、写真を 1 枚もクラウドに送らずに手元で完結させます。
使うのは、Google が 2026年10月6日に公開した埋め込みモデル EmbeddingGemma 2 です。文章・コード・画像・音声・動画を 1 つの共通のベクトル空間に写すモデルで、パラメーター数は 740M(7 億 4,000 万)、Gemma 4 の設計をもとにしています。ライセンスは商用利用もできる Apache 2.0 で、重みは Hugging Face と Kaggle から誰でも取得できます。
確かめたいのは 3 つです。
- Pi 5 の CPU だけで、実用になる速さとメモリで動くか(索引づくり 1 枚あたりの時間・検索 1 回の時間・最大メモリ)
- ベクトルをどこまで短く切り詰めても、正しい写真が上に残るか(768・512・256・128 次元)
- 日本語と英語の検索語で、同じ写真が出てくるか
やったのは、Pi 5 に EmbeddingGemma 2 のテキスト+画像部分だけを入れ、当サイトの記事写真 99 枚を索引にして、先に正解を決めておいた検索語 20 本(10 問 × 日本語・英語)で、次元を 4 段階に変えて採点することです。
- 1 枚約 20 秒は索引づくりの話で、検索は約 0.4 秒だった。 写真の符号化は重く、99 枚で約 33 分かかりました。一方、検索 1 回はほとんどが検索語(テキスト)の符号化で、打ってすぐ候補が返ってきます。しかもこの 0.4 秒は次元を 768 から 128 に下げてもほぼ変わりません
- 最大メモリ 3.39GB は、写真を索引にしなくても同じだった。 索引を読んで検索するだけの回も 3.39GB。メモリはモデルを float32 で読み込んだ時点でほぼ決まり、写真の処理の分は誤差の範囲でした
- 128 次元に切るとスコアは高く出る。 正規化し直しても、「ニキシー管の時計」の 1 位のスコアは 768 次元の 0.695 から 128 次元の 0.807 に上がり、1 位と 5 位の差は縮みました。順位が崩れ始めたのも 128 次元で、256 次元までは 20 問すべてで正解が 1 位のままでした
費用は 0 円です(詳しくは 💰 費用の節)。
🧭 基礎:埋め込み・MRL・マルチモーダルと EmbeddingGemma 2
実験を読むのに要る分だけをまとめます。埋め込みとベクトル検索を知っている場合は、🧰 準備の章まで読み飛ばして構いません。
埋め込みとベクトル検索
埋め込み(embedding)は、文章や画像を決まった長さの数字の並び(ベクトル)に変換することです。EmbeddingGemma 2 なら、どんな入力も 768 個の数字になります。うまく学習されたモデルでは、「はんだごて」と「soldering iron」のように文字が違っても意味が同じものが近い場所に集まります。近さは、2 つのベクトルの向きの近さ(コサイン類似度)で測るのが一般的です。
\cos\theta = \frac{\mathbf{a} \cdot \mathbf{b}}{\lVert \mathbf{a} \rVert \, \lVert \mathbf{b} \rVert}値は 1 に近いほど似ていて、ベクトルをあらかじめ長さ 1 にそろえて(正規化して)おけば、掛け算と足し算だけの内積で計算できます。
(索引)"] end subgraph SRCH["② 検索するとき"] Q["検索語
「光っている LED」"] --> E2["同じ埋め込みモデル"] --> QV["検索語のベクトル"] end V --> M["近い順に並べる
(コサイン類似度)"] QV --> M M --> R["上位の写真・文書"] R -.->|"RAG なら"| G["生成モデルに渡して
答えを書かせる"]
ベクトル検索は、検索語も同じモデルでベクトルにして、索引の中から近い順に並べる検索です。キーワードが一致しなくても、意味が近ければ見つかります。図の ① が写真 1 枚ずつの重い処理、② が検索のたびの軽い処理で、この回の計測もこの 2 つを分けて測っています。見つけた資料を生成 AI(LLM)に渡して答えを書かせる構成が RAG(検索拡張生成)で、Google は EmbeddingGemma 2 と生成モデル Gemma 4 を組み合わせた端末内の RAG を用途に挙げています。
MRL:先頭だけ切り取っても使えるベクトル
MRL(Matryoshka Representation Learning)は、ベクトルの先頭の一部だけを取り出しても使えるように学習させる方法です。名前は入れ子の人形マトリョーシカから来ています。
1 件 3,072 バイト"] --> A["先頭 512 次元
1 件 2,048 バイト"] A --> B["先頭 256 次元
1 件 1,024 バイト"] B --> C["先頭 128 次元
1 件 512 バイト"] C --> N["切ったら長さ 1 に
正規化し直す"]
バイト数は 1 つの数字を 32 ビット浮動小数点(4 バイト)で持った場合の計算です。写真 1 万枚の索引なら、768 次元で約 30.7MB、128 次元で約 5.1MB になります。公式の「最大 6 倍の保存容量の削減」は、この 768 対 128 の比です。
ふつうの学習では情報が 768 個の数字にばらばらに散らばるので、先頭だけ取り出すと近さの判定が崩れます。MRL では学習のときに「768 次元全体で」と同時に「先頭 512・256・128 次元だけで」近さを判定できるかも採点するので、大まかで大事な情報ほど前に、細かい違いを見分ける情報ほど後ろに並ぶように学習が進みます。
モデルカードの表から、主なベンチマークを抜き出しました(いずれもフル精度での値)。
| 出力次元 | 圧縮比 | MTEB(多言語 v2) | MTEB(コード v1) | MIEB(画像 lite) | MMEB v2(全体) |
|---|---|---|---|---|---|
| 768 | 1:1 | 61.36 | 78.68 | 64.64 | 59.01 |
| 512 | 1:1.5 | 61.17 | 77.24 | 64.32 | 58.38 |
| 256 | 1:3 | 60.41 | 76.18 | 63.13 | 56.24 |
| 128 | 1:6 | 57.89 | 71.41 | 59.06 | 45.65 |
モデルカードは、256 次元までは品質への影響がほぼ小さく、128 次元はテキストだけの用途に向く、と説明しています。画像や動画を含む MMEB は 128 次元で 59.01 から 45.65 に下がるので、マルチモーダルで 128 次元を使うなら自分のデータで確かめるよう勧めています。この回の実験は、その「自分のデータで確かめる」をそのままやったものです。
長さ 1 のベクトルの先頭だけを切り出すと、長さは 1 でなくなります。モデルカードは、切り詰めた後に必ず正規化し直すよう書いています。忘れてもエラーにならず、それらしい数字のまま順位だけが静かに崩れる、とも注意しています。sentence-transformers なら truncate_dim と normalize_embeddings=True を一緒に渡せば自動で処理されます。また、検索語と索引は同じ次元にそろえる必要があります。
マルチモーダル:写真と文章を同じ空間に写す
マルチモーダル埋め込みは、文章・画像・音声・動画という種類の違う入力を同じベクトル空間に写す埋め込みです。文章で写真を探せるのは、写真のベクトルと検索語のベクトルが同じ空間にあるからです。
270M"] I["画像・動画のフレーム"] --> VE["画像エンコーダ
170M"] S["音声"] --> AE["音声エンコーダ
300M"] VE --> TX AE --> TX TX --> O["共通の 768 次元ベクトル"]
EmbeddingGemma 2 は、画像と音声を専用のエンコーダでいったん変換し、文章を扱う本体に流し込んで 1 本の 768 次元ベクトルにします。入力の上限はすべての種類で共通の 8,192 トークンで、モデルカードによると画像は 1 枚 280 トークン(既定)で約 29 枚、動画は 1 フレーム 140 トークンで約 58 フレーム、音声は 1 秒 25 トークンで約 327 秒(約 5.5 分)が入ります。画像に当てるトークン数は 70 から 1,120 の間で変えられ、多くすると細かい部分まで捉えられる代わりに遅くなります。
EmbeddingGemma 2 の中身
| 項目 | 内容(公式の表記) |
|---|---|
| 発表日 | 2026年10月6日(Google の発表ブログ) |
| ライセンス | Apache 2.0 |
| パラメーター数 | 合計 740M(テキスト部 270M+画像 170M+音声 300M) |
| 対応する入力 | 文章(コードを含む)・画像・動画・音声とその組み合わせ |
| 出力の次元 | 768(512・256・128 に切り詰め可) |
| コンテキスト長 | 8,192 トークン(前世代の 4 倍) |
| 言語 | 100 以上 |
| 量子化時のメモリ(Google の公表値・Pixel 11 Pro) | テキストのみ約 191MB、マルチモーダル全体で約 567MB |
| 学習データの区切り | 2025年1月 |
画像と音声のエンコーダは独立した部品で、使わないものは読み込まずに済ませられます。
| 使う種類 | 実効サイズ |
|---|---|
| テキストのみ | 270M |
| テキスト+画像 | 440M |
| テキスト+音声 | 570M |
| すべて | 740M |
写真検索ならテキスト+画像の 440M で足ります。メモリの限られた Pi 5 では、この選び方が効いてきます。
2025年に出た初代 EmbeddingGemma はテキスト専用で、Google によると 2,000 万回以上ダウンロードされました。2 では次の点が変わっています。
| 項目 | EmbeddingGemma(初代) | EmbeddingGemma 2 |
|---|---|---|
| 入力 | テキスト | テキスト・画像・動画・音声 |
| コンテキスト長 | 約 2K(Google は 2 の 8K を「4 倍」と説明) | 8,192 トークン |
| MTEB(多言語 v2) | 61.15 | 61.36 |
| MTEB(コード v1) | 68.76 | 78.68 |
文章の性能は同等のまま、コード検索は 9.92 ポイント上がりました。Google は、手元のコードベースの索引づくりやコーディングエージェントの検索に向くとしています。動かす道具としては、Google の発表で transformers・sentence-transformers・llama.cpp・Ollama・MLX・vLLM、ベクトルの保存先として Qdrant、ブラウザ向けに transformers.js、スマートフォン向けに Google AI Edge(MediaPipe・LiteRT)が挙がっています。Python では transformers 5.19.0(2026年10月6日公開)でこのモデルに対応し、sentence-transformers は 6.1.0 以上が必要です。
🧰 準備:venv にライブラリを入れ、モデルを取ってくる
Pi 5 の上で、作業用の venv を作って入れます。
python3 -m venv ~/eg2 && source ~/eg2/bin/activate
pip install -U "sentence-transformers>=6.1.0" "transformers>=5.19.0" torch torchvision pillow numpy
sudo apt install time   # 計測に使う /usr/bin/time は既定では入っていない
mkdir -p ~/eg2-test/photos && cd ~/eg2-test   # photos/ に JPEG を入れ、ここで実行する
torchvisionは必須です。 無いと画像の前処理(EmbeddingGemma2Processor)の import でModuleNotFoundErrorになりますtimeパッケージは、最大メモリを測る/usr/bin/time -vのためです。Raspberry Pi OS には既定で入っていません- torch は CPU 版を指定したほうが軽くなります。 素の
pip install torchでは CUDA 版の torch(+cu130表記)とnvidia-*パッケージまで落ちてきて、この venv とモデル(約 1.5GB)で microSD の空きが 19GB から 8.6GB へ約 10GB 減りました。Pi では GPU を使わないので、--index-url https://download.pytorch.org/whl/cpuを付けて CPU 版を指定すれば、ダウンロードもディスクも軽くできます(この指定での入れ直しは試していません)
モデルの重みファイル(model.safetensors)は約 1.49GB で、初回の読み込み時に Hugging Face から自動で取得されます。2026年10月11日時点では、Hugging Face にログインしないまま取得できました(未認証リクエストの警告が出るだけです)。
モデルカードは、多くの CPU では float32 で動かすよう勧めています(float16 は値が壊れるので使わない)。float32 で読み込むと、テキスト+画像の 440M なら重みだけで約 1.8GB になる計算です。実測の最大メモリは後述の 3.39GB だったので、4GB モデルの Pi 5 では OS 込みでぎりぎり、8GB モデルなら余裕がある、と見込めます(4GB モデルでは動かしていません)。
🔬 実験設計:写真 99 枚・検索語 20 本・採点
検索スクリプト
索引づくりと検索を 1 本にした最小のスクリプトです。計測にはこれと同じ設定のスクリプトを使いました。
# search_photos.py  使い方: python search_photos.py 768
import sys, glob
import numpy as np
import torch
from sentence_transformers import SentenceTransformer

DIM = int(sys.argv[1]) if len(sys.argv) > 1 else 768
paths = sorted(glob.glob("photos/*.jpg"))

# 音声エンコーダは読み込まない(テキスト+画像 = 440M)
model = SentenceTransformer(
    "google/embeddinggemma-2",
    config_kwargs={"audio_config": None},
    model_kwargs={"torch_dtype": torch.float32},
)

# 索引づくり:写真を 1 枚ずつベクトルに(画像には接頭辞を付けない)
docs = model.encode(
    [{"image": p} for p in paths],
    truncate_dim=DIM, normalize_embeddings=True,
    batch_size=2, show_progress_bar=True,
)
np.save(f"index_{DIM}.npy", docs)

# 検索:文章をベクトルにして近い順に 5 件
while True:
    q = input("検索語> ").strip()
    if not q:
        break
    qv = model.encode_query([q], truncate_dim=DIM, normalize_embeddings=True)
    scores = model.similarity(qv, docs)[0]
    for i in scores.argsort(descending=True)[:5]:
        print(f"{float(scores[i]):.3f}  {paths[int(i)]}")
encode_query は、検索語に検索用の接頭辞(task: search result | query: )を自動で付けます。EmbeddingGemma 2 は用途ごとの短い接頭辞つきで学習されていて、文章には付けたほうが精度が上がり、画像・音声・動画には付けない、とモデルカードにあります。
写真と検索語
索引に入れたのは、当サイトの記事写真から重複を除いた 99 枚(長辺 1024px に縮小)です。ファイル名を p001.jpg〜 の連番にして、この番号を写真の ID としました。下の図の番号も同じ ID です。
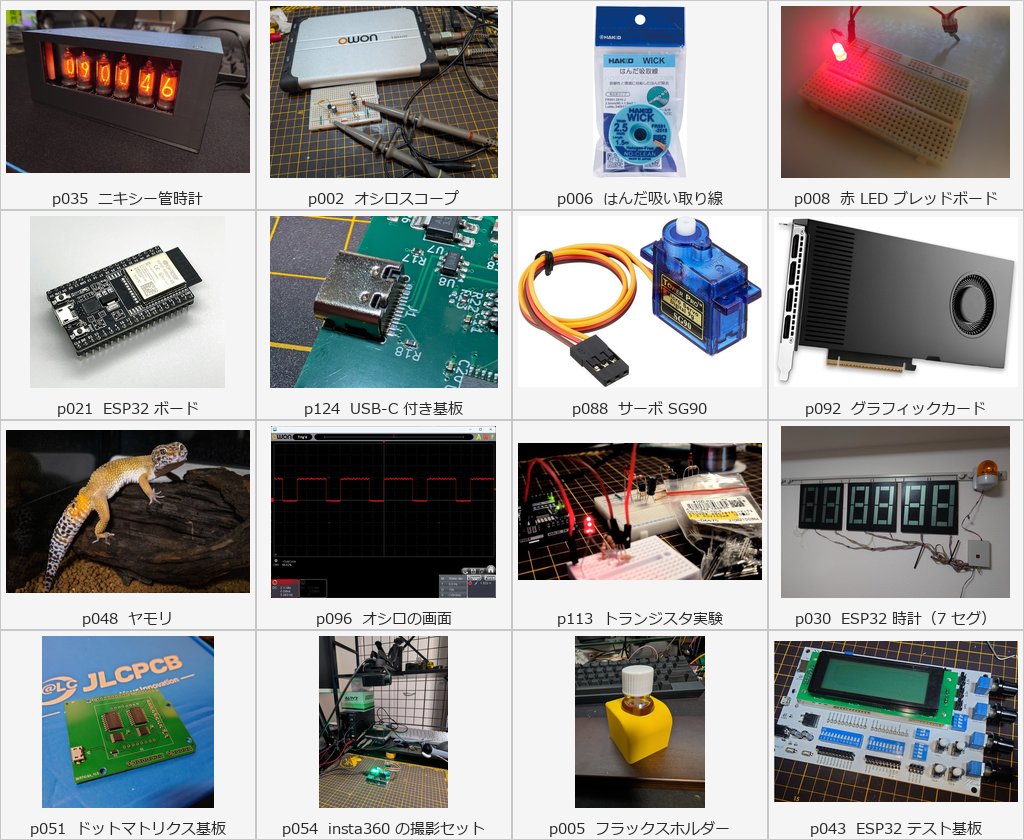
索引に入れた 99 枚のうち 16 枚。番号は写真の ID で、4 段目の 3 枚(p051・p054・p005)は 128 次元で 1 位に紛れ込んだ写真
検索語は、10 問を日本語と英語で 1 本ずつ書いた計 20 本の文字列です。こちらで渡すのは表の文字列そのもので、接頭辞は encode_query が付けます。右端の列は、検索する前に人の目で決めておいた正解の写真で、複数枚が正解の問もあります。
| 問 | 日本語 | 英語 | 正解の写真 ID |
|---|---|---|---|
| 1 | ニキシー管の時計 | nixie tube clock | p035 |
| 2 | オシロスコープ | oscilloscope | p001・p002・p096 |
| 3 | はんだ付けの道具(フラックスやはんだ吸い取り線) | soldering supplies such as flux and desoldering wick | p003・p004・p005・p006 |
| 4 | ブレッドボードで赤い LED が光っている | a red LED lit on a breadboard | p008・p013・p069・p070・p113 |
| 5 | ESP32 の開発ボード | ESP32 development board | p021・p022・p036・p044・p104 |
| 6 | USB-C コネクタが付いた緑の基板 | green circuit board with a USB-C connector | p119・p122・p124・p125 |
| 7 | サーボモーター | servo motor | p088・p089 |
| 8 | グラフィックカード | graphics card | p092 |
| 9 | ヤモリ | gecko | p048 |
| 10 | 本の表紙 | book cover | p109・p110・p118 |
返ってくるものと採点
返ってくるのは、検索語 1 本につき「写真のファイル名と類似度の組」を類似度の高い順に 5 件です。問 1 の日本語と英語について、768 次元の実行で記録した結果をそのまま載せます。
{"query": "ニキシー管の時計", "top5": [["p035.jpg",0.695],["p030.jpg",0.631],["p093.jpg",0.617],["p022.jpg",0.605],["p034.jpg",0.605]]}
{"query": "nixie tube clock", "top5": [["p035.jpg",0.799],["p030.jpg",0.722],["p031.jpg",0.673],["p052.jpg",0.673],["p013.jpg",0.663]]}
数値はコサイン類似度で、長さ 1 に正規化した検索語ベクトルと写真ベクトルの内積です。順位はこの値の降順です。この問はどちらの言語でも正解の p035 が 1 位でした。
正解かどうかは、返ってきた 5 件のファイル名を正解の集合と突き合わせるだけで決めています。採点スクリプトの判定部分は次の 2 行です。
names = [name for name, score in top5]            # 例: ["p035.jpg", "p030.jpg", ...]
hit1 = names[0] in truth[q]                       # 上位 1 件に正解
hit5 = any(n in truth[q] for n in names)          # 上位 5 件に正解
truth[q] は上の表の右端の列(問 1 なら {"p035.jpg"})です。結果の表の数字は、20 本の検索語のうち hit1・hit5 がそれぞれ真になった本数です。
次元の切り替え方
768 次元は、上のスクリプトと同じく truncate_dim=768、normalize_embeddings=True、batch_size=2(float32・音声エンコーダなし)で 99 枚を符号化しました。512・256・128 次元は、768 次元の索引の先頭を切り詰めて正規化し直したもので、画像の符号化はやり直していません。MRL の定義どおり、truncate_dim を指定して符号化した結果と同じ値になります。検索語のほうは、次元ごとに encode_query(truncate_dim=…) で符号化して時間を測りました。
そのため、1 枚あたりの索引時間は 768 次元の値を全次元の代表値としています(次元によって変わらないため)。最大メモリは /usr/bin/time -v の Maximum resident set size で、切り詰めと検索だけを行った 512・256・128 次元の各回(1 回 22 秒ほど)でも測りました。日本語と英語の比較は、同じ問の 2 本で上位 1 件が同じ写真になったかを数えます(モデルカードには、多言語対応だが言語によって性能は同じではない、という注記があります)。
🔬 手を動かした記録
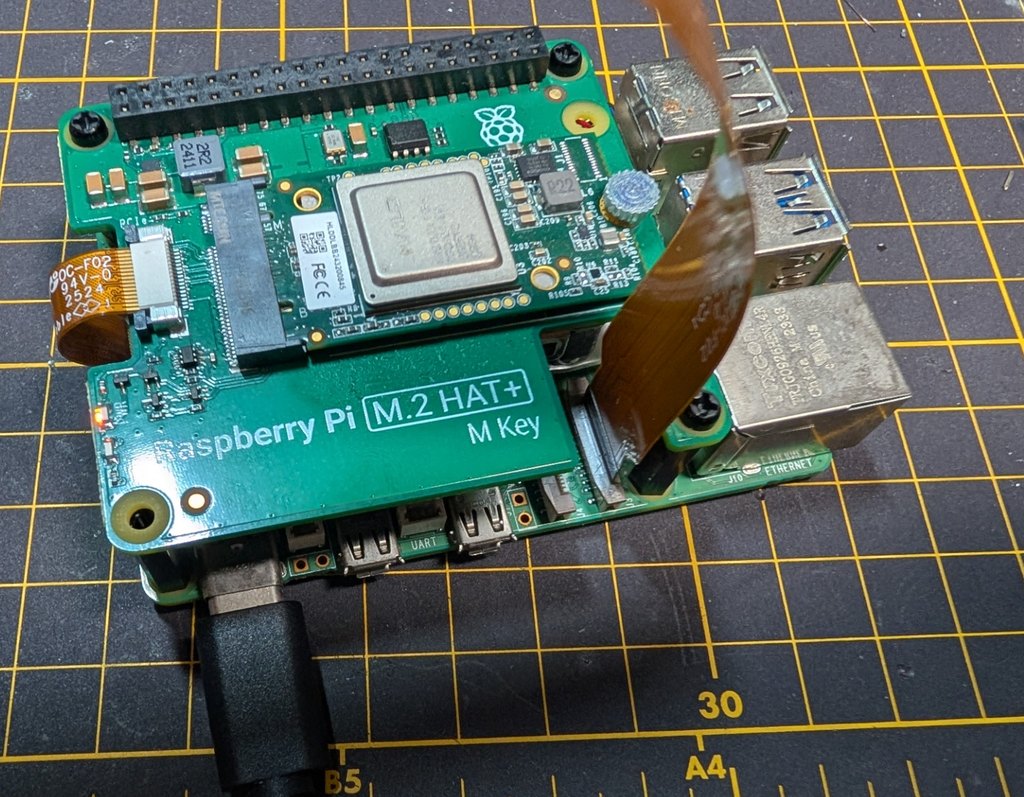
計測に使った Raspberry Pi 5 8GB(ケースなし・ファンあり)。M.2 HAT+ の Hailo-8L は今回は未使用(CPU のみ)
| 項目 | 値 |
|---|---|
| 機材 | Raspberry Pi 5 8GB(ケースなし・ファンあり) |
| 拡張 | M.2 HAT+ + Hailo-8L(今回は未使用・CPU のみ) |
| OS | Raspberry Pi OS(Debian trixie・64 ビット) |
| Python | 3.13.5 |
| ライブラリ | sentence-transformers 6.1.0・transformers 5.19.0・torch 2.14.1(CPU・4 スレッド) |
| 追加したもの | torchvision・time |
| 索引化中の温度 | 70.8℃(スロットリングなし・スワップ 0) |
| モデル読み込み | 初回 24.1 秒・2 回目以降 7.0〜7.1 秒 |
CPU だけで回した
Hailo で動かすにはモデルを専用形式(HEF)に変換する必要があり、EmbeddingGemma 2 は Hailo の公開モデル一覧(Model Zoo)にないので、今回は CPU だけで動かしています(torch.cuda.is_available() は False)。索引づくりの間は 4 コアを使い切っていました。
熱と時間
ケースなし・ファンありの状態で、索引化中の温度は 70.8℃。vcgencmd get_throttled は 0x0 で、クロックは絞られていません。スワップも 0 のままでした。99 枚の索引づくりは合計 1,976.2 秒(約 33 分)で、768 次元の回を始めてから終わるまでは 33 分 37 秒でした。モデルの読み込みは初回 24.1 秒、2 回目以降は 7.0〜7.1 秒で、2 回目以降が速いのは OS のファイルキャッシュが効くためです。
最初の構成では足りなかった 2 つ
- torchvision。 sentence-transformers と transformers だけ入れた状態では、画像の前処理(
EmbeddingGemma2Processor)の import でModuleNotFoundErrorになりました。写真を扱うなら必須です - time。 最大メモリを測る
/usr/bin/timeは、Raspberry Pi OS に既定では入っていませんでした。シェル組み込みのtimeとは別物で、sudo apt install timeで入れます
準備の章のコマンドは、この 2 つを足した後の形です。
📊 結果:次元ごとの精度・時間・メモリ
| 次元 | 上位 5 件に正解(20 問中) | 上位 1 件に正解(20 問中) | 1 枚あたりの索引時間 | 検索 1 回(平均/最大) | 最大メモリ | 索引ファイル |
|---|---|---|---|---|---|---|
| 768 | 20 | 20 | 19.96 秒 | 0.402/0.433 秒 | 3.39GB | 297KB |
| 512 | 20 | 20 | 768 と同じ | 0.377/0.406 秒 | 3.39GB | 198KB |
| 256 | 20 | 20 | 768 と同じ | 0.373/0.390 秒 | 3.39GB | 99KB |
| 128 | 20 | 17 | 768 と同じ | 0.372/0.389 秒 | 3.39GB | 50KB |
256 次元までは、20 問すべてで正解が 1 位のままでした。今回の写真と検索語では、索引ファイルを 3 分の 1 にしても検索の質は変わっていません。128 次元では 3 問で 1 位を取り違えましたが、正解はどれも上位 5 件に残っています。
最大メモリは、写真を索引にした 768 次元の回も、索引を読むだけの 512 次元以下の回も 3.39GB でほぼ同じでした。メモリはモデルを float32 で読み込んだ時点でほぼ決まり、写真の処理(2 枚ずつ)の分は誤差の範囲です。検索 1 回の約 0.4 秒はほとんどが検索語の符号化で、検索語側の計算量は次元によらないため、次元を下げてもほぼ変わりません。
日本語と英語
日本語と英語で上位 1 件が同じ写真になった組は、10 組中 768 次元で 8 組、512・256 次元で 7 組、128 次元で 6 組でした。768・512・256 次元で食い違った組は、「はんだ付けの道具」と「サーボモーター」(512・256 次元では「オシロスコープ」も)で、正解の写真 2 枚のどちらが 1 位になるかが入れ替わっただけで、どちらも正解の写真でした。128 次元の食い違い 4 組には、次に挙げる 3 問の取り違えが含まれます(残る 1 組の「サーボモーター」は、どちらも正解の写真です)。
1 位を取り違えた 3 問(128 次元)
| 検索語 | 128 次元で 1 位になった写真 | 正解の順位 |
|---|---|---|
| オシロスコープ(日本語) | 360 度カメラ(insta360)の撮影セットを机に並べた写真 | 4 位 |
| USB-C コネクタが付いた緑の基板(日本語) | Arduino のドットマトリクス基板(緑の基板ではある) | 2 位 |
| book cover(英語) | フラックスのホルダー | 3 位 |
オシロスコープと同じ「机の上に並んだ機材」、正解と同じ「緑の基板」といった大まかな特徴は 128 次元でも合っていて、外れたのはそれより細かい見分けです。大まかな情報ほど前に、細かい違いほど後ろに並ぶという MRL の考え方と合う崩れ方で、モデルカードがマルチモーダルの 128 次元に慎重な理由と整合します。今回のデータでは、写真検索で索引の小ささと精度のつり合いがよいのは 256 次元です。
基礎の章の「切ったら正規化し直す」の補足です。正規化し直しても、類似度の絶対値は次元によって変わります。「ニキシー管の時計」で 1 位になった写真のスコアは、768 次元で 0.695、256 次元で 0.722、128 次元で 0.807 でした。5 位のスコアも 0.605 から 0.752 に上がり、128 次元では 1 位と 5 位の差が縮みます。「0.7 以上なら一致」のような固定のしきい値で判定するなら、しきい値は次元ごとに決め直す必要があります。
💡 分かったこと(事実)
- Pi 5 8GB の CPU だけで動く。 テキスト+画像の 440M を float32 で読み込み、最大メモリは 3.39GB。索引化中も 70.8℃・スロットリングなし・スワップ 0 だった
- 重いのは索引づくりだけ。 写真 1 枚 19.96 秒、99 枚で 1,976.2 秒。検索 1 回は平均 0.372〜0.402 秒で、次元を下げてもほぼ変わらない
- メモリは索引化の有無で変わらない。 索引を読んで検索するだけの回も 3.39GB。モデルの読み込みで決まる
- 256 次元までは精度が落ちなかった。 20 問すべてで正解が 1 位。索引ファイルは 297KB から 99KB になった
- 128 次元では 3 問で 1 位を取り違えた。 外れたのは大まかな特徴が似た写真で、正解は全問上位 5 件に残った
- 日本語と英語で上位 1 件が揃ったのは 768 次元で 10 組中 8 組。 768〜256 次元の食い違いは、どちらも正解の写真の入れ替わりだけだった
- 類似度の絶対値は次元で動く。 128 次元では全体に高く出て、1 位と 5 位の差が縮む
- 追加で要るのは torchvision と time の 2 つ。 モデルは Hugging Face 未ログインで取得できた
💭 所感
当サイトでは、Needle 2 の記事で、14MB の関数呼び出し専用モデルが Pi 5 の CPU だけで LED を点けるところまでを扱いました。そちらは「言葉を命令に変える」小さなモデルで、EmbeddingGemma 2 は「言葉で手元のものを探す」小さなモデルです。Pi で動く AI が、話を聞く係と探す係に分かれて揃ってきた、という手応えがあります。
効きそうなのは、はじめにで挙げた基板の写真の山です。日付と連番のファイル名しかない写真を、クラウドに上げずに Pi 5 の中だけで言葉から引けるなら、作業記録の価値が一段上がります。回路図の画像やデータシートのページを同じ索引に入れられるのも、マルチモーダルならではです。
1 枚約 20 秒という数字は、最初は遅く見えました。ただ、写真は一度索引にすれば済み、増えた分だけ足せばよいので、作業記録の用途なら夜に回しておけば朝には終わっている速さで足ります。検索のほうは約 0.4 秒で、打ってすぐ候補が返ってくるので対話的に使えます。重い処理と軽い処理がはっきり分かれているので、運用もそれに合わせて分ければよい、というのが実測から引ける線です。
最大メモリ 3.39GB は float32 のまま動かした値で、Google が公表した量子化モデルの約 567MB とは条件が違います。量子化版を Pi で動かせばもっと小さくできる見込みはありますが、確かめていません。また、Hailo-8L を載せていても EmbeddingGemma 2 を Hailo-8L で動かす道は今のところ無いので、Pi 5 では CPU だけで回す前提で設計するのが現実的です。
この連載の続く回では、この索引に生成モデルの Gemma 4 を組み合わせて、Pi 5 の中だけで完結する端末内の RAG として「探した写真や資料をもとに答えを書かせる」ところまで進めたいと考えています。
💰 費用
0 円です。EmbeddingGemma 2 はオープンモデルで、API キーも課金プロジェクトも使っていません。#1・#2 で使った Gemini API の課金プロジェクトとは無関係で、利用額は動いていません。
お金の代わりにかかったものは次のとおりです。
| 項目 | 実測 |
|---|---|
| ディスク | microSD の空きが 19GB → 8.6GB(venv とモデルで約 10GB。CUDA 版 torch を含む) |
| モデルの重み | model.safetensors 約 1.49GB |
| 索引づくりの時間 | 99 枚で 1,976.2 秒(約 33 分) |
| 検索 1 回の時間 | 約 0.4 秒 |
Pi 5 の消費電力と電気代は測っていません。
⚠️ できないこと・確認していないこと
- Hailo-8L では動かしていません。 EmbeddingGemma 2 は Hailo の Model Zoo になく、HEF への変換も試していません。今回は CPU だけです
- 量子化版は試していません。 3.39GB は float32 の値で、Google の公表値(約 191MB/約 567MB)は Pixel 11 Pro での量子化モデルの値です
- Pi 5 の 4GB モデルでは動かしていません。 「OS 込みでぎりぎり」は 3.39GB からの見込みです
- 音声と動画は扱っていません。 音声エンコーダは読み込まず(テキスト+画像の 440M)、入力は静止画と文章だけです
- 日本語と英語以外の検索語は試していません。
- 結果は写真 99 枚・検索語 20 本の範囲のものです。 256 次元まで落ちなかったのは、このデータでの話です。写真が増えたり、似た写真が多かったりすれば変わり得ます
- CPU 版 torch(
--index-url https://download.pytorch.org/whl/cpu)での入れ直しはしていません。 ディスクがどれだけ軽くなるかは測っていません - 電気代・消費電力は測っていません。
✅ まとめ
- EmbeddingGemma 2 は、文章・画像・音声・動画を同じ 768 次元の空間に写す 740M のオープンな埋め込みモデル(Apache 2.0)。使う種類だけ読み込めて、写真検索ならテキスト+画像の 440M で足りる
- Pi 5 8GB の CPU だけで、transformers 5.19.0・sentence-transformers 6.1.0 に torchvision を足せば、写真を言葉で探す最小構成が組めた
- 写真 99 枚・検索語 20 本で測ると、索引づくりは 1 枚約 20 秒(99 枚で約 33 分)、検索 1 回は約 0.4 秒、最大メモリは 3.39GB
- 256 次元までは 20 問すべてで正解が 1 位に残り、128 次元では 3 問で 1 位を取り違えた(正解は全問上位 5 件内)。今回の写真 99 枚・検索語 20 本では、写真検索は 256 次元がつり合いのよい点
- 次元を下げると類似度の絶対値は上がるので、しきい値を使うなら次元ごとに決め直す
基板の写真の山を、クラウドに出さずに Pi 5 の中で言葉から引くところまでは届きました。この連載の続く回では、この索引に Gemma 4 をつないで、探した写真や資料をもとに Pi 5 の中で答えを書かせるところまで進めたいと考えています。
よくある質問(FAQ)
Q: EmbeddingGemma 2 は文章を生成できますか?
A: できません。入力をベクトルに変える埋め込み専用のモデルです。文章で答えを返させたい場合は、EmbeddingGemma 2 で資料を検索し、その資料を Gemma 4 などの生成モデルに渡す RAG の構成にします。Google は、2 つが同じテキストのトークナイザーと音声エンコーダを共有するので、組み合わせたときの合計メモリを抑えられると説明しています。
Q: Raspberry Pi 5 で動きますか?
A: 動きました。Raspberry Pi 5 8GB の CPU だけで、テキスト+画像の構成を float32 で動かし、写真 1 枚の索引づくりに約 20 秒、検索 1 回に約 0.4 秒、最大メモリは 3.39GB でした。torchvision の追加が必要です。Google が公表したメモリ(約 191MB/約 567MB)は Pixel 11 Pro での量子化モデルの値で、条件が違います。
Q: 128 次元に切り詰めても大丈夫ですか?
A: 用途によります。モデルカードの表では、多言語テキストの MTEB は 61.36 から 57.89 と小さめの低下ですが、画像や動画を含む MMEB v2 は 59.01 から 45.65 に下がります。モデルカードは 128 次元をテキスト向けとし、マルチモーダルで使うなら自分のデータで確かめるよう勧めています。
Q: 日本語の検索語で写真を探せますか?
A: 100 以上の言語に対応していますが、モデルカードは言語によって性能が同じではないと注記しています。日本語と英語で同じ内容の検索語を試して、結果を比べるのが確実です。
Q: 商用のアプリに組み込めますか?
A: ライセンスは Apache 2.0 で、Google は商用利用もできるライセンスとしています。あわせて Gemma の禁止用途ポリシーに従う必要があります。
関連記事
- 【連載】Google AI 実験室 — この連載のとりまとめ。収録記事と、毎回やっていることのまとめ
- 【Google AI 実験室 #1】準備編:AI Studio で記事専用プロジェクトを作り、API キーを発行して Gemini を最初に呼ぶまで — クラウドの Gemini API を使う回の土台。この回は API キーも課金プロジェクトも使わない
- 【Google AI 実験室 #2】データシート QA:Gemini にデータシート PDF を読ませ、IC実験室の実測値で採点する — AI の出力を、先に人が決めた正解と照らして採点する型。この回で正解の写真を先に決めてから上位 1 件・上位 5 件を数えたのも同じ考え方
- 【Google AI 実験室 #3】Google Stitch で「電子部品の在庫管理アプリ」の画面を作り、HTML まで持ち出す — API キーなし・ブラウザだけで追える回
- 14MB の関数呼び出し専用 LLM「Needle 2」が Pi 5 の LED を点ける|function calling とは・CPU だけで 78ms — Pi 5 の CPU だけで動く小さなモデルの先例
- Gemini 3.8 Live が GA|Live API の仕組みとスタックチャン載せ替え計画 — クラウド側の Google の AI の最新の流れ