- Windows 11 / uv / Python 3.12 /
google-genai2.23.0 /pypdf6.19.0 / モデルはgemini-3.8-flashです。環境・記事専用プロジェクト(Tier 1)・.envは #1 準備編で作ったものをそのまま使います - 読ませるデータシートは、秋月電子の商品ページからリンクされている UTC 2SC1815(4 ページ・文書番号 QW-R201-006.P) と HTC NE555(7 ページ・Jul. 2019_R1.0) の 2 本です。2026-09-19 に URL を確認して取得しました。PDF は各メーカーの著作物なので、リポジトリには入れず、URL から落とすスクリプトを置いています。本文中の引用は 1 項目あたり 1〜2 行に留めています
- 実測値は IC実験室 #5 2SC1815 と IC実験室 #4 NE555N で公開済みの値だけを使います。この記事のために新しく測ってはいません
- 一次ドキュメント(ai.google.dev)は 2026-09-19 に取得しました。Document understanding は 2026-09-17、Media resolution は 2026-09-18、料金は 2026-09-16 更新のものです。記事末尾の「参考」に取得日つきで URL を残しています
- Gemini の実出力(JSON・トークン数・照合結果)は 2026-09-19 に Tier 1 の記事専用プロジェクトで実行したものです。各スクリプトは 1 回ずつ実行し、エラーや再実行はありませんでした
- 本文・コード・実出力に API キーとプロジェクト ID は出てきません
はじめに:AI の答えを、自分の実測で採点する
IC実験室では、2SC1815 の hFE を 6 本測って 227〜244、LED を叩いたときの VCE(sat) を 67 mV、ターン OFF の蓄積時間を 約 1.3 µs と読みました。NE555N では R1=R2=10 kΩ・C=10 µF で 計算 4.8 Hz・実測 5.083 Hz でした。どれも、データシートの数字と自分の測定を突き合わせて出てきた数字です。
この「突き合わせ」の相手に、今回は Gemini を座らせます。同じデータシート PDF を Gemini に渡して同じことを聞き、答えを 4 列に並べる。データシートを人間が読んだ値、PDF を渡さずに知識だけで答えた Gemini、PDF を渡した Gemini、そして IC実験室の実測値。AI の答えを「なんとなく正しそう」で終わらせず、引用を返させて、その引用が PDF 本文に本当にあるかを機械的に確かめ、実測と並べて採点するのがこの回の主題です。
やることは 4 つです。
- PDF を渡さず、2SC1815 と NE555N について 7 項目ずつ、計 14 項目を聞く(Gemini が「知識で」何を答えるか)
- PDF を渡して同じ 14 項目を聞き、値・単位・測定条件・根拠の引用文・ページを構造化出力(JSON)で返させる
- 返ってきた引用文を pypdf で PDF の本文から探し、見つからなければ「根拠なし」と判定する
- 人間が読んだ値/PDF なし/PDF あり/実測、の 4 列の表を作り、項目ごとに読む
この記事を読み終えると、次のことが分かります。
- Gemini が PDF を 「ページの画像」と「埋め込みテキスト」の 2 経路で読んでいること、ページ数がどうトークンと費用になるか
- 「AI に根拠を言わせて、その根拠を機械で照合する」という 検証の型と、それでも残る限界
- hFE のように 測定条件で値が変わる項目を聞くとき、なぜ値と単位と条件を分けて返させるのか
- PDF に書いていないことを聞いたとき、Gemini が「無い」と言えるか
所要時間は、#1 の環境があれば 1 時間程度。費用は API を呼ぶ 2 本のスクリプト(計 4 回の呼び出し)で 合計 19,606 トークン・約 $0.052(約 8.3 円) でした(内訳と単価は 💰 費用の節)。
Gemini が間違えたものも、そのまま書きます。 採点の目的は「AI がすごい」でも「AI は使えない」でもなく、どこまで信じてよく、どこから自分で確かめるべきかの線を、自分の実測で引くことです。
🧭 LLM は PDF をどう読むか
Document understanding:ページは「画像」と「テキスト」の 2 経路で入る
Gemini API の公式ドキュメント(Document understanding・2026-09-17 更新)は、PDF を native vision、つまり画像として丸ごと理解する、と説明しています。文字だけ抜くのではなく、図・表・グラフ・レイアウトも含めて読む。上限は 1 ファイル 50 MB または 1,000 ページで、インラインで渡しても Files API 経由でも同じです。
Gemini 3 世代では、ここに 2 経路の説明が足されています。
(4 ページ/7 ページ)"] --> IMG["ページを画像として見る
既定 560 トークン/ページ
(課金)"] PDF --> TXT["埋め込みテキストを抽出
(Native Text・課金なし)"] IMG --> MODEL["gemini-3.8-flash
+質問 14 項目+JSON schema"] TXT --> MODEL MODEL --> JSON["JSON:値・単位・条件・引用・ページ"]
- 画像経路:各ページが画像トークンになります。Media resolution のページ(2026-09-18 更新)の Gemini 3 の表では、PDF は
media_resolutionが 低(low)280・中(medium)560・高(high)1,120 トークン/ページ、既定(unspecified)は 560 です。推奨は medium で、「document understanding の品質は medium で飽和し、high にしても通常の文書の OCR 精度はほとんど上がらない」と書かれています。大きいページは 3,072×3,072 に縮小、小さいページは 768×768 に拡大されます - テキスト経路:PDF に埋め込まれたテキスト(コピー&ペーストできる文字)は抽出してモデルに渡され、そのぶんのトークンは課金されないと明記されています。今回の 2 本の PDF はどちらもテキスト埋め込みがあるので、この経路が効きます
なお、同じサイトの Document understanding のページには「各ページは 258 トークン相当」という一文も残っています(Gemini 3 より前の世代の値と読めますが、ページ上に世代の注記はありません)。258 と 560、どちらが今の gemini-3.8-flash に当たるかは、count_tokens で自分の PDF を数えて決めます(実験 2。結果を先に言うと 560 でした)。
PDF を渡す方法は 2 つです。インラインは、PDF のバイト列を base64 にしてリクエストに直接入れる方法で、リクエスト 1 回あたり 100 MB(PDF は 50 MB)まで。毎回 PDF を送るので、同じ PDF に何度も質問するなら帯域の無駄になります。Files APIは、先に client.files.upload() でアップロードして URI を受け取り、以後はその URI だけを渡す方法で、1 ファイル 2 GB・プロジェクトあたり 20 GB、保存は 48 時間、利用は無料です。今回は 265 KB と 160 KB の PDF に 1 回ずつ質問するだけなので、インラインで渡します。
Interactions API での渡し方
#1 で決めたとおり、この連載のコードは Interactions API で書きます。Document understanding のページの Python 例は、2026-09 時点でそのまま Interactions API の形になっていて、input のリストに {"type": "document", "data": <base64>, "mime_type": "application/pdf"} を入れ、その後ろに {"type": "text", "text": "質問"} を置きます。Files API を使う場合は data の代わりに uri です。同ページの Best practices に「1 ページだけ渡すときは、テキストのプロンプトをページの後に置く」とあるので、今回も 文書を先・質問を後の順にします。
generateContent(legacy・サポート継続)でも PDF は渡せますが、公式が新規プロジェクトに推奨し、新機能が先に載るのは Interactions API なので、迷う理由はありません。
Media resolution のページには「Gemini 3 では content item ごとに media_resolution を指定できる」とありますが、手元の google-genai 2.23.0 の DocumentContent 型が持つフィールドは data・mime_type・uri の 3 つだけで、resolution は ImageContent と VideoContent にしかありません(SDK のソース _gaos/types/interactions/documentcontent.py の定義)。今回の PDF は 既定(560 トークン/ページ相当)で渡します。SDK の更新で変わる可能性があります。
「引用を返させて、照合する」という考え方
LLM が返す数値は、測定値ではなく 主張です。データシートの数字を聞いたとき、返ってくる答えは 4 種類に分かれます。
| 答えの種類 | 例(2SC1815 のコレクタ損失) | 見分け方 |
|---|---|---|
| 渡した資料の値 | UTC 版の 625 mW | 引用が PDF 本文にあり、値も一致 |
| 別の資料の値 | 東芝版の 400 mW(IC実験室 #5の比較表) | 値は「どこかの 2SC1815」として正しいが、引用は PDF に無い |
| 無いものを「ある」と言う | 2SC1815 の蓄積時間の規格値 | PDF に規定が無い。引用があれば照合で落ちる |
| 「無い」と言える | 「この PDF には記載なし」 | specified=false。これも正しい答え |
引用が PDF 本文に一致すれば、少なくとも「そこを読んだ」ことの証拠になります。 一致しなければ、値が偶然合っていても採用しません(別のメーカーの値、または記憶で埋めた値だからです)。ただし、引用が一致していても 解釈が間違うことはあります。たとえば VCE(sat) の行を正しく引用しながら、TYP と MAX を入れ替える、測定条件を落とす、といったことです。だから引用だけでなく、値・単位・条件を別々のフィールドで返させ、条件まで人間が読んだ値と比べます。
やっていることは、回路の測定と同じです。オシロの画面をそのまま信じるのではなく、測定条件(プローブの倍率・カップリング・トリガ)を揃えてから比べる。AI の答えも、条件を揃えて(同じ質問・同じ PDF・同じスキーマ)、根拠(引用)まで返させてから比べる。14 項目の引用を人間が PDF を開いて目で探すより、pypdf で本文を取り出して機械的に照合したほうが速く、何度でも同じ結果が出ます。
構造化出力で「値・単位・条件」を分ける理由
hFE を例にします。UTC 2SC1815 のデータシートには、hFE の数字が 3 つあります。
| 数字 | 何の値か | 条件 |
|---|---|---|
| 70〜700 | hFE1 の全体範囲(全ランク) | VCE=6 V, IC=2 mA |
| 120〜240 | Y ランクの範囲 | 同上(CLASSIFICATION OF hFE1) |
| 25 以上 | hFE2(大電流側) | VCE=6 V, IC=150 mA |
「hFE はいくらですか」と条件抜きで聞くと、答えは定まりません。どれを答えても間違いではないからです。VCE(sat) も同じで、MAX 0.25 V は IC=100 mA, IB=10 mA の条件です。IC実験室 #5 で測った 67 mV は IC=16.8 mA, IB=0.83 mA でしたから、「規格の 0.25 V より小さい」と並べて眺めることはできても、同じ条件での比較ではありません。実測の列にも、この条件を必ず書きます。
だからスキーマは、value・unit・condition・quote・page を別フィールドにし、さらに specified(規定があるか)を false にできる出口を作ります。「無い」と言える出口が無いスキーマは、モデルに無理に埋めさせる圧力になります。
なぜこの 2 枚の PDF か
IC実験室で読み込んだデータシートの中から、性格の違う 2 枚を選びました。
| UTC 2SC1815(QW-R201-006.P) | HTC NE555(Jul. 2019_R1.0) | |
|---|---|---|
| ページ数・サイズ | 4 ページ・265,332 バイト | 7 ページ・160,552 バイト |
| 規格表の場所 | 絶対最大定格・電気的特性・hFE ランク表が すべて 2 ページ目に集まっている | 絶対最大定格と推奨動作条件が 1 ページ目、電気的特性が 5 ページ目に分かれている |
| テキスト埋め込み | あり(pypdf で抽出できる) | あり |
| 3〜4 ページ目 | 特性グラフ(画像)と免責文 | 6 ページ目の APPLICATION INFORMATION が T.B.D.、7 ページ目は改版注記 |
| 「書いていないこと」 | スイッチング時間(td/tr/ts/tf)の規定が無い(IC実験室 #5 の比較表のとおり)。一方 Storage Temperature(保存温度)はある | 無安定動作の周波数式が載っていない(応用情報のページが T.B.D.) |
14 項目のうち 2 項目は、意図的に「この PDF に書いていないこと」を聞きます。2SC1815 の 蓄積時間と、NE555N の 無安定の周波数式です。蓄積時間のほうは、PDF に “Storage Temperature” という似た語があるので、そこを引用してしまうかどうかも見どころです。周波数式のほうは、555 の一般式 f=1.44/((R1+2R2)C) は Gemini が知っているはずですが、「この PDF には無い」と言えるか、知識で埋めて引用まで作ってしまうかが分かれ目になります。
🧰 準備:#1 の環境に pypdf を足し、PDF を落とす
依存の追加とリポジトリ構成
#1 でクローンした google-ai-lab に、02-datasheet-qa/ を足します。新しく増える依存は pypdf(6.19.0・2026-09-16 公開)だけです。pyproject.toml の dependencies に 1 行足して uv sync します。
dependencies = [
    "google-genai>=2.23.0,<3",
    "python-dotenv>=1.2.3,<2",
    "pypdf>=6.19.0,<7",
]
cd google-ai-lab
git pull
uv sync
構成はこうなります。datasheets/ と out/ は .gitignore 済みで、リポジトリには入りません。
google-ai-lab/
├── 01-setup/                 # #1 のまま(.env もここ)
├── 02-datasheet-qa/
│   ├── spec_qa.py            # 質問 14 項目・回答スキーマ・PDF の定義(共有モジュール)
│   ├── download_datasheets.py  # 秋月の URL から PDF を datasheets/ に取得し sha256 を表示
│   ├── ask_without_pdf.py    # 実験 1:PDF なし(知識だけ)
│   ├── ask_with_pdf.py       # 実験 2:PDF あり・構造化出力・count_tokens
│   ├── verify_quotes.py      # 実験 3:引用を pypdf で PDF 本文と照合
│   ├── score.py              # 実験 4:4 列の表を Markdown で出力
│   ├── measured.json         # 人間が読んだデータシートの値と、IC実験室の実測値
│   └── datasheets/           # PDF の置き場所(.gitignore)
└── out/                      # 実出力 JSON・Markdown(.gitignore)
.env は #1 の 01-setup/.env をそのまま使います。各スクリプトは load_dotenv() のあとに 01-setup/.env も読むので、コピーは要りません(リポジトリ直下に .env を置いてもよく、.gitignore の .env はどの階層にも効きます)。
データシート PDF を URL から取得する
2 本の PDF は、秋月電子の商品ページ(2SC1815L-Y-T92 106475・NE555N 116062)からリンクされている メーカーのデータシートです。2026-09-19 に curl -I で確認したところ、どちらも HTTP 200・Content-Type: application/pdf で、Last-Modified は 2023 年 9 月でした。
UTC の PDF の末尾には “Reproduction in whole or in part is prohibited without the prior written consent of the copyright owner.” とあります。PDF はリポジトリに入れず、読者にも URL から取得してもらいます。 そのためのスクリプトが download_datasheets.py で、取得したファイルの sha256 を記事執筆時の値と比べて、PDF が差し替わっていれば知らせます。
"""秋月電子の商品ページからリンクされているデータシート PDF を datasheets/ に落とし、sha256 とページ数を表示する(Google AI 実験室 #2)

PDF は各メーカーの著作物なのでリポジトリには入れない。必ずこのスクリプトで URL から取得する。
"""

import hashlib
import sys
import urllib.request

from pypdf import PdfReader

from spec_qa import DATASHEET_DIR, DATASHEETS

sys.stdout.reconfigure(errors="replace")  # cp932 のコンソールに µ などが混ざっても落とさない
DATASHEET_DIR.mkdir(exist_ok=True)

for part, ds in DATASHEETS.items():
    dest = DATASHEET_DIR / ds["file"]
    req = urllib.request.Request(ds["url"], headers={"User-Agent": "Mozilla/5.0"})
    with urllib.request.urlopen(req, timeout=60) as resp:
        content_type = resp.headers.get("Content-Type", "")
        data = resp.read()
    dest.write_bytes(data)
    digest = hashlib.sha256(data).hexdigest()
    pages = len(PdfReader(dest).pages)
    same = "OK (記事執筆時と同一)" if digest == ds["sha256"] else "DIFFERENT (PDF が更新されている。値を読み直すこと)"
    print(f"[{part}] {ds['url']}")
    print(f"  -> {dest.name}  {len(data):,} bytes  {content_type}  {pages} pages")
    print(f"  sha256 {digest}  {same}")
uv run 02-datasheet-qa/download_datasheets.py
[2SC1815] https://akizukidenshi.com/goodsaffix/2SC1815_unisonic.pdf
  -> 2SC1815_unisonic.pdf  265,332 bytes  application/pdf  4 pages
  sha256 17a154c2c214455f61f3ef146d4e8e37d5065356b17a70c293a47afd89d694dc  OK (記事執筆時と同一)
[NE555N] https://akizukidenshi.com/goodsaffix/ne555.pdf
  -> ne555.pdf  160,552 bytes  application/pdf  7 pages
  sha256 04b265ee75522a3161fc21bccac2874719d44183c50b255c5fc79be5b1451865  OK (記事執筆時と同一)
2 本とも OK、つまり記事執筆時に読んだ PDF と同じバイト列です。以降の実験はこの 2 本に対して行っています。
🔬 実験設計:4 本のスクリプトと 14 の質問
PDF 2 本を datasheets/ へ"] --> W["ask_without_pdf.py
実験 1:PDF なし"] D --> P["ask_with_pdf.py
実験 2:PDF あり・構造化出力"] P --> V["verify_quotes.py
実験 3:引用を PDF 本文と照合"] W --> S["score.py+measured.json
実験 4:4 列の表"] V --> S
質問 14 項目
質問は PDF あり/なしで同じ文面を投げます。項目は、IC実験室で実測した値と対応づけられるものを中心に、「この PDF に書いていないこと」を各 1 つ混ぜています。「データシートの所在」の列は、人間が PDF を開いて読んだ値とページで、採点表の 1 列目になります。
2SC1815(UTC 2SC1815L-Y-T92)
| id | 項目 | 質問の要点 | データシートの所在(人間が読んだ) | 対応する実測(IC実験室 #5) |
|---|---|---|---|---|
pinout |
ピン配置 | TO-92 のピン 1・2・3 は E・C・B のどれか | p.1 ORDERING INFORMATION:1=E・2=C・3=B | この並びで配線し、実験 1〜4 が動作 |
hfe_y |
Y ランクの hFE 範囲 | 範囲と測定条件(VCE・IC) | p.2:120〜240(VCE=6 V, IC=2 mA) | 6 本で 227〜244(平均 234)。部品テスターの条件は非同一 |
vce_sat |
VCE(sat) | TYP・MAX と条件 | p.2:TYP 0.1 V/MAX 0.25 V(IC=100 mA, IB=10 mA) | 67 mV(IC=16.8 mA, IB=0.83 mA) |
pc |
コレクタ損失 | 絶対最大定格 | p.2:625 mW(TA=25 ℃) | 実験 1 の損失 ≈1.1 mW(定格の 0.2%) |
ft |
fT | 規格値と条件 | p.2:80 MHz MIN(VCE=10 V, IC=50 mA) | 未測定 |
vebo |
VEBO | 絶対最大定格 | p.2:5 V | 実験 3 でベースの負振り −3.04 V(電源 5 V) |
ts |
蓄積時間 | スイッチング特性の tstg(storage time) | 規定なし(Storage Temperature −55〜+150 ℃ はある) | 約 1.3 µs(RB=3.3 kΩ, IC=16.8 mA) |
NE555N(HTC・CMOS・DIP-8)
| id | 項目 | 質問の要点 | データシートの所在(人間が読んだ) | 対応する実測(IC実験室 #4) |
|---|---|---|---|---|
vcc |
電源電圧範囲 | 推奨動作条件の VCC | p.1 RECOMMENDED OPERATING RATINGS:2〜18 V | 5 V で動作 |
iout |
出力電流 | 絶対最大定格 | p.1:100 mA | 未測定 |
icc |
消費電流 | MAX と条件 | p.5:200 µA(VCC=2 V)/300 µA(VCC=18 V) | 未測定 |
fmax |
最大発振周波数 | 保証値と条件 | p.5:500 kHz MIN(VCC=5 V, astable) | 未測定(実験は約 5 Hz) |
vth_vtrig |
しきい値電圧 | VCC=5 V の THRESHOLD・TRIGGER | p.5:3.2〜3.5 V/1.55〜1.8 V | デューティ比 実測 66.62%(理論 66.7%) |
astable_f |
無安定の周波数式 | R1・R2・C から f を求める式 | 記載なし(p.6 APPLICATION INFORMATION は T.B.D.) | 計算 4.8 Hz・実測 5.083 Hz |
cmos_diff |
CMOS 版の相違点 | バイポーラ版より改善された点 | p.1 DESCRIPTION の列挙 | — |
共有モジュール spec_qa.py:質問・スキーマ・プロンプト
質問文・PDF の URL と sha256・回答スキーマ・システム指示を 1 か所に置き、4 本のスクリプトから読みます。同じ質問を PDF あり/なしで投げることを、ファイルの構造で保証するためです。
"""質問項目・回答スキーマ・データシートの定義(Google AI 実験室 #2)。ask_*.py / verify_quotes.py / score.py が共有する"""

from pathlib import Path

from pydantic import BaseModel, Field

HERE = Path(__file__).resolve().parent
DATASHEET_DIR = HERE / "datasheets"  # PDF の置き場所(.gitignore 済み。download_datasheets.py が作る)
OUT_DIR = HERE.parent / "out"  # 実出力の置き場所(.gitignore 済み)

# 秋月電子の商品ページからリンクされているメーカーのデータシート PDF(2026-09-19 取得・HEAD 200・application/pdf)
# sha256 は記事執筆時のもの。PDF が差し替わっていたら download_datasheets.py が知らせる
DATASHEETS = {
    "2SC1815": {
        "part": "2SC1815L-Y-T92",
        "maker": "UTC (Unisonic Technologies)",
        "shop": "https://akizukidenshi.com/catalog/g/g106475/",
        "url": "https://akizukidenshi.com/goodsaffix/2SC1815_unisonic.pdf",
        "file": "2SC1815_unisonic.pdf",
        "sha256": "17a154c2c214455f61f3ef146d4e8e37d5065356b17a70c293a47afd89d694dc",
    },
    "NE555N": {
        "part": "NE555N (CMOS, DIP-8)",
        "maker": "HTC Korea (TAEJIN TECHNOLOGY)",
        "shop": "https://akizukidenshi.com/catalog/g/g116062/",
        "url": "https://akizukidenshi.com/goodsaffix/ne555.pdf",
        "file": "ne555.pdf",
        "sha256": "04b265ee75522a3161fc21bccac2874719d44183c50b255c5fc79be5b1451865",
    },
}

# 質問。PDF あり/なしの両方で同じ文面を投げる。IC実験室 #4・#5 で実測した項目と、
# 「このデータシートには書いていないこと」を混ぜてある(何を根拠に答えるかを見るため)
QUESTIONS = {
    "2SC1815": [
        {"id": "pinout", "label": "ピン配置", "q": "TO-92 パッケージのピン 1・2・3 は、それぞれ E(エミッタ)・C(コレクタ)・B(ベース)のどれか"},
        {"id": "hfe_y", "label": "Y ランクの hFE 範囲", "q": "hFE ランク Y の範囲(最小〜最大)。あわせて、その hFE の測定条件(V_CE と I_C)"},
        {"id": "vce_sat", "label": "V_CE(sat)", "q": "コレクタ・エミッタ間飽和電圧 V_CE(sat) の TYP と MAX、およびその測定条件"},
        {"id": "pc", "label": "コレクタ損失", "q": "コレクタ損失(許容損失)P_C の絶対最大定格"},
        {"id": "ft", "label": "f_T", "q": "トランジション周波数 f_T の規格値と、その測定条件"},
        {"id": "vebo", "label": "V_EBO", "q": "エミッタ・ベース間電圧 V_EBO の絶対最大定格"},
        {"id": "ts", "label": "蓄積時間", "q": "スイッチング特性の蓄積時間 t_stg(storage time)の規格値"},
    ],
    "NE555N": [
        {"id": "vcc", "label": "電源電圧範囲", "q": "推奨動作条件としての電源電圧 V_CC の範囲(最小〜最大)"},
        {"id": "iout", "label": "出力電流", "q": "出力電流 I_O の絶対最大定格"},
        {"id": "icc", "label": "消費電流", "q": "消費電流(Supply Current)I_CC の MAX と、その条件"},
        {"id": "fmax", "label": "最大発振周波数", "q": "保証される最大発振周波数と、その条件"},
        {"id": "vth_vtrig", "label": "しきい値電圧", "q": "V_CC=5V のときの THRESHOLD 電圧と TRIGGER 電圧の範囲(MIN〜MAX)"},
        {"id": "astable_f", "label": "無安定の周波数式", "q": "無安定(astable)動作の発振周波数を R1・R2・C から求める式"},
        {"id": "cmos_diff", "label": "CMOS 版の相違点", "q": "バイポーラ版の SE/NE555 と比べて改善されている点として、データシートが挙げているもの"},
    ],
}


class SpecAnswer(BaseModel):
    """1 項目ぶんの回答。値・単位・条件・根拠を分けて返させる"""

    id: str = Field(description="質問の id をそのまま返す")
    specified: bool = Field(description="根拠となる規定(数値・式・記述)が資料にあるか。無い項目は false にして value/quote/page を null にする")
    value: str | None = Field(description="値。範囲は '120~240' のように書く。数値に単位を含めない。式や文章で答える項目はそのまま書く")
    unit: str | None = Field(description="単位(V, mA, mW, MHz, kHz, µA, % など)。無単位・式・文章なら null")
    condition: str | None = Field(description="その値が規定されている測定条件(例: V_CE=6V, I_C=2mA)。無ければ null")
    quote: str | None = Field(description="根拠となるデータシート本文の一節。資料に書かれている言語のまま、改変・翻訳・省略なしで 1 行以内。資料が無い/記載が無いときは null")
    page: int | None = Field(description="quote があるページ番号(1 始まり)。無ければ null")
    note: str | None = Field(description="補足。資料に記載が無いときは何を根拠にしたか(例: 一般的な 555 の式)。PDF なしのときは、どのメーカー・版のデータシートを念頭に置いたか")


class Answers(BaseModel):
    part: str = Field(description="対象部品の型番")
    answers: list[SpecAnswer]


SYSTEM_WITH_PDF = (
    "あなたは電子部品のデータシートを読む技術者です。添付の PDF だけを根拠に答えてください。"
    "PDF に規定が無い項目は specified=false とし、value・quote・page は null にしてください。一般知識で補わないでください。"
    "quote は PDF 本文の文字列を改変せず 1 行以内で抜き出してください(後で機械的に照合します)。"
)
SYSTEM_WITHOUT_PDF = (
    "あなたは電子部品のデータシートに詳しい技術者です。資料は渡しません。あなたの知識だけで答えてください。"
    "確信が無い項目は specified=false にしてください。quote と page は必ず null にし、"
    "note にどのメーカー・版のデータシートを念頭に置いたかを書いてください。"
)


def build_prompt(part: str) -> str:
    """質問一覧をひとつのプロンプトにまとめる(PDF あり/なしで共通)"""
    ds = DATASHEETS[part]
    lines = [
        f"対象部品: {ds['part']}({ds['maker']})。次の各項目について、値・単位・測定条件・根拠を JSON で答えてください。",
        "",
        "質問一覧(id: 質問):",
    ]
    lines += [f"- {q['id']}: {q['q']}" for q in QUESTIONS[part]]
    return "\n".join(lines)


def print_usage(u) -> None:
    """Interaction.usage を #1 と同じ形で表示し、モダリティ別の内訳も出す"""
    print(f"input  : {u.total_input_tokens or 0} tokens")
    print(f"thought: {u.total_thought_tokens or 0} tokens")
    print(f"output : {u.total_output_tokens or 0} tokens")
    print(f"total  : {u.total_tokens or 0} tokens")
    for m in u.input_tokens_by_modality or []:
        print(f"  input[{m.modality}]: {m.tokens or 0} tokens")
要点は 3 つです。
SpecAnswerのspecifiedが「無い」と言える出口です。false のときはvalue・quote・pageを null にするようにスキーマの説明文で指示しています。noteには、記載が無いときの根拠(一般式など)や、PDF なしのときに どのメーカー・版のデータシートを念頭に置いたかを書かせます- システム指示を 2 種類用意しています。PDF ありでは「添付の PDF だけを根拠に。一般知識で補わない。quote は改変せず 1 行以内(後で機械照合する)」、PDF なしでは「資料は渡さない。知識だけで。quote と page は必ず null」
DATASHEETSに 記事執筆時の sha256 を持たせているので、download_datasheets.pyが PDF の差し替えを検出できます。データシートは黙って改版されるものです
🔬 実験 1:PDF なしで聞く(ask_without_pdf.py)
まず、Gemini が 知識だけで何と答えるかを取っておきます。ここで正しい値が返っても、それは「どこかの 2SC1815 のデータシート」の記憶であって、手元の UTC 版とは限りません。
"""実験 1:PDF を渡さず、知識だけで同じ質問に答えさせる(Google AI 実験室 #2)"""

import json
import os
import sys
from pathlib import Path

from dotenv import load_dotenv
from google import genai

from spec_qa import DATASHEETS, OUT_DIR, SYSTEM_WITHOUT_PDF, Answers, build_prompt, print_usage

load_dotenv()  # 02-datasheet-qa/.env またはリポジトリ直下の .env
load_dotenv(Path(__file__).resolve().parents[1] / "01-setup" / ".env")  # #1 で作った .env をそのまま使う
MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
sys.stdout.reconfigure(errors="replace")
OUT_DIR.mkdir(exist_ok=True)

client = genai.Client()
for part in DATASHEETS:
    print(f"===== {part} (PDF なし) =====")
    interaction = client.interactions.create(
        model=MODEL,
        system_instruction=SYSTEM_WITHOUT_PDF,
        input=build_prompt(part),
        response_format={
            "type": "text",
            "mime_type": "application/json",
            "schema": Answers.model_json_schema(),
        },
        store=False,
    )
    answers = Answers.model_validate_json(interaction.output_text)  # スキーマどおりか検証
    for a in answers.answers:
        print(f"{a.id:<10} specified={a.specified!s:<5} value={a.value!r} unit={a.unit!r} cond={a.condition!r}")
        print(f"{'':<10} note={a.note!r}")
    print("---")
    print_usage(interaction.usage)

    record = {
        "part": part,
        "model": MODEL,
        "mode": "without_pdf",
        "usage": interaction.usage.model_dump(exclude_none=True),
        "answers": answers.model_dump(),
    }
    dest = OUT_DIR / f"02_{part}_without_pdf.json"
    dest.write_text(json.dumps(record, ensure_ascii=False, indent=2, default=str), encoding="utf-8")
    print(f"saved: {dest}")
    print()
uv run 02-datasheet-qa/ask_without_pdf.py | Tee-Object out/02_ask_without_pdf.txt
===== 2SC1815 (PDF なし) =====
pinout     specified=True  value='1: E, 2: C, 3: B' unit=None cond=None
           note='UTC (Unisonic Technologies) 2SC1815 データシート(TO-92パッケージのピン配置: 1: Emitter, 2: Collector, 3: Base)を念頭に置いています。'
hfe_y      specified=True  value='120~240' unit=None cond='V_CE=6V, I_C=2mA'
           note='UTC (Unisonic Technologies) 2SC1815 データシートの hFE 分類(Yランク: 120〜240)を念頭に置いています。'
vce_sat    specified=True  value='TYP 0.1, MAX 0.25' unit='V' cond='I_C=100mA, I_B=10mA'
           note='UTC (Unisonic Technologies) 2SC1815 データシートの電気的特性を念頭に置いています。'
pc         specified=True  value='400' unit='mW' cond='Ta=25°C'
           note='UTC (Unisonic Technologies) 2SC1815 データシートの絶対最大定格(Collector Dissipation)を念頭に置いています。'
ft         specified=True  value='80 (MIN)' unit='MHz' cond='V_CE=10V, I_C=1mA'
           note='UTC (Unisonic Technologies) 2SC1815 データシートの Transition Frequency を念頭に置いています。'
vebo       specified=True  value='5' unit='V' cond='Ta=25°C'
           note='UTC (Unisonic Technologies) 2SC1815 データシートの絶対最大定格(Emitter-Base Voltage)を念頭に置いています。'
ts         specified=False value=None unit=None cond=None
           note='UTC (Unisonic Technologies) 2SC1815 データシートにはスイッチング時間(t_stg を含む)の規定はありません。'
---
input  : 319 tokens
thought: 1274 tokens
output : 816 tokens
total  : 2409 tokens
  input[text]: 319 tokens
saved: E:\prog\google-ai-lab\out\02_2SC1815_without_pdf.json

===== NE555N (PDF なし) =====
vcc        specified=True  value='4.5~16' unit='V' cond=None
           note='HTC Korea (TAEJIN TECHNOLOGY) NE555 データシートの推奨動作条件(Recommended Operating Conditions)を念頭に置いています。'
iout       specified=True  value='±225' unit='mA' cond=None
           note='HTC Korea NE555 データシートの絶対最大定格(Absolute Maximum Ratings)における Output Current を念頭に置いています。'
icc        specified=True  value='15' unit='mA' cond='V_CC = 15V, R_L = ∞'
           note='HTC Korea NE555 データシートの電気的特性(Supply Current, MAX)を念頭に置いています(なお V_CC=5V 時の MAX は 5mA または 6mA)。'
fmax       specified=False value=None unit=None cond=None
           note='HTC Korea NE555 データシートの電気的特性には最大発振周波数の保証値(規格値)の規定はありません。'
vth_vtrig  specified=True  value='THRESHOLD: 2.7~3.5, TRIGGER: 1.45~1.9' unit='V' cond='V_CC = 5V'
           note='HTC Korea NE555 データシートの電気的特性における V_CC=5V での Threshold Voltage(typ 3.3V)および Trigger Voltage(typ 1.67V)の規定値を念頭に置いています。'
astable_f  specified=True  value='1.44 / ((R1 + 2 * R2) * C)' unit=None cond=None
           note='HTC Korea NE555 データシートの Astable 動作アプリケーション欄に記載されている基本計算式です(表記により R_A, R_B とされる場合もあります)。'
cmos_diff  specified=False value=None unit=None cond=None
           note='HTC KoreaのNE555はバイポーラプロセス製品であり、CMOS製品ではないため、バイポーラ版SE/NE555との差異や改善点に関する記述はありません。'
---
input  : 289 tokens
thought: 4752 tokens
output : 810 tokens
total  : 5851 tokens
  input[text]: 289 tokens
saved: E:\prog\google-ai-lab\out\02_NE555N_without_pdf.json
出力を見て気づいたことを、部品ごとに書きます。
2SC1815 は 7 項目中 5 項目が UTC 版と一致し、2 項目が「別の正しい値」でした。 note は 7 項目すべてが「UTC (Unisonic Technologies) 2SC1815 データシート…を念頭に置いています」で始まります。プロンプトにメーカー名を書いたので、そう答えるのは自然です。ところが値を見ると、コレクタ損失が 400 mW、fT の測定条件が IC=1 mA になっています。UTC 版の規格表は 625 mW と IC=50 mA で、400 mW と 1 mA は東芝版(JCET 版も同じ)の値です(IC実験室 #5の 3 社比較表)。primer で「別の正しい値」の例に挙げた 2 項目が、そのまま出ました。「UTC を念頭に」と自己申告しながら、中身の一部は東芝版の記憶で埋まっている。note の自己申告は、根拠にはなりません。 ピン配置(1=E・2=C・3=B)・Y ランクの hFE 120〜240(VCE=6 V, IC=2 mA)・VCE(sat) TYP 0.1/MAX 0.25 V(IC=100 mA, IB=10 mA)・VEBO 5 V の 4 項目は UTC 版と一致しています。specified=false にしたのは蓄積時間の 1 項目で、note は「スイッチング時間(t_stg を含む)の規定はありません」。“Storage Temperature” に釣られず、「無い」と言えています。
NE555N は 7 項目中、HTC 版と一致した項目が 0 でした。 電源電圧範囲 4.5〜16 V、出力電流 ±225 mA、消費電流 15 mA(VCC=15 V) は、HTC の CMOS 版ではなく バイポーラ版 NE555 の値です。HTC 版の PDF は 2〜18 V・100 mA・200〜300 µA で、IC実験室 #4でバイポーラ版と対比した表の、反対側の列の数字が出てきたことになります。しきい値電圧は THRESHOLD 2.7〜3.5 V/TRIGGER 1.45〜1.9 V で、HTC 版の 3.2〜3.5/1.55〜1.8 V より範囲が広い。最大発振周波数は specified=false(「保証値の規定はありません」)ですが、HTC 版の p.5 には 500 kHz MIN の保証値があります。これは「無い」と言えた例ではなく、あるものを「無い」と言った例です。無安定の周波数式は 1.44/((R1+2R2)C) を specified=true で返し、note に「HTC Korea NE555 データシートの Astable 動作アプリケーション欄に記載されている基本計算式です」と書きました。実際の p.6 は T.B.D. で、式はありません。式そのものは一般式として正しいのに、存在しない記載場所が付いています。そして CMOS 版の相違点は specified=false で、note は「HTC Korea の NE555 はバイポーラプロセス製品であり、CMOS 製品ではない」。HTC 版の p.1 DESCRIPTION には CMOS 版として改善された点が列挙されているので、部品の正体そのものを取り違えています。
2 つの部品で差が出た形は、はっきりしています。2SC1815 は、東芝のオリジナルが生産を終えたあとも UTC・JCET が同じ型番で作っている部品で、IC実験室 #5 の 3 社比較表でメーカー間の差として挙げた 2 項目(コレクタ損失・fT の条件)が、ちょうど東芝版の値になりました。NE555 という型番はバイポーラ版オリジナルの名前で、HTC の CMOS 版は「同じ名前の別物」です(IC実験室 #4 の主題)。どちらも、知識だけの答えは オリジナル(東芝版・バイポーラ版)の値に寄りました。思考トークンも NE555N の回が 4,752 で、4 回の呼び出しの中で最大でした(2SC1815 は 1,274)。数字は事実として書いておき、理由は断定しません。
🔬 実験 2:PDF を渡して構造化出力で聞く(ask_with_pdf.py)
本題です。PDF をインラインで渡し、14 項目を JSON で返させます。生成の前に count_tokens で PDF だけのトークン数を数える手順を挟んで、primer の「258 か 560 か」を自分の PDF で確かめます。
"""実験 2:データシート PDF を渡し、値・単位・条件・引用・ページを構造化出力で返させる(Google AI 実験室 #2)"""

import base64
import hashlib
import json
import os
import sys
from pathlib import Path

from dotenv import load_dotenv
from google import genai
from google.genai import types
from pypdf import PdfReader

from spec_qa import DATASHEET_DIR, DATASHEETS, OUT_DIR, SYSTEM_WITH_PDF, Answers, build_prompt, print_usage

load_dotenv()  # 02-datasheet-qa/.env またはリポジトリ直下の .env
load_dotenv(Path(__file__).resolve().parents[1] / "01-setup" / ".env")  # #1 で作った .env をそのまま使う
MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
sys.stdout.reconfigure(errors="replace")
OUT_DIR.mkdir(exist_ok=True)

client = genai.Client()
for part, ds in DATASHEETS.items():
    pdf_path = DATASHEET_DIR / ds["file"]
    pdf_bytes = pdf_path.read_bytes()
    pages = len(PdfReader(pdf_path).pages)
    print(f"===== {part} (PDF あり: {pdf_path.name}, {pages} pages, {len(pdf_bytes):,} bytes) =====")

    # 生成の前に、PDF だけのトークン数を count_tokens で数える(生成はしない。入力側のトークン数だけが返る)
    try:
        counted = client.models.count_tokens(
            model=MODEL,
            contents=[types.Part.from_bytes(data=pdf_bytes, mime_type="application/pdf")],
        ).total_tokens
        print(f"count_tokens(PDF only): {counted} tokens  ({(counted or 0) / pages:.0f} tokens/page)")
    except Exception as e:  # 数えられなくても本題(生成)は続ける
        counted = None
        print(f"count_tokens failed: {type(e).__name__}: {e}")

    # PDF は base64 のインラインデータで渡す(50MB/1000 ページ以下は Files API を使わなくてよい)。文書を先、質問を後に置く
    interaction = client.interactions.create(
        model=MODEL,
        system_instruction=SYSTEM_WITH_PDF,
        input=[
            {"type": "document", "data": base64.b64encode(pdf_bytes).decode("utf-8"), "mime_type": "application/pdf"},
            {"type": "text", "text": build_prompt(part)},
        ],
        response_format={
            "type": "text",
            "mime_type": "application/json",
            "schema": Answers.model_json_schema(),
        },
        store=False,
    )
    answers = Answers.model_validate_json(interaction.output_text)
    for a in answers.answers:
        print(f"{a.id:<10} specified={a.specified!s:<5} value={a.value!r} unit={a.unit!r} cond={a.condition!r}")
        print(f"{'':<10} p.{a.page} quote={a.quote!r}")
    print("---")
    print_usage(interaction.usage)

    record = {
        "part": part,
        "model": MODEL,
        "mode": "with_pdf",
        "pdf": {"file": pdf_path.name, "sha256": hashlib.sha256(pdf_bytes).hexdigest(), "pages": pages, "bytes": len(pdf_bytes)},
        "count_tokens_pdf_only": counted,
        "usage": interaction.usage.model_dump(exclude_none=True),
        "answers": answers.model_dump(),
    }
    dest = OUT_DIR / f"02_{part}_with_pdf.json"
    dest.write_text(json.dumps(record, ensure_ascii=False, indent=2, default=str), encoding="utf-8")
    print(f"saved: {dest}")
    print()
uv run 02-datasheet-qa/ask_with_pdf.py | Tee-Object out/02_ask_with_pdf.txt
===== 2SC1815 (PDF あり: 2SC1815_unisonic.pdf, 4 pages, 265,332 bytes) =====
count_tokens(PDF only): 2241 tokens  (560 tokens/page)
pinout     specified=True  value='1: E, 2: C, 3: B' unit=None cond=None
           p.1 quote='Note: Pin Assignment: E: Emitter C: Collector B: Base'
hfe_y      specified=True  value='120~240' unit=None cond='VCE=6V, IC=2mA'
           p.2 quote='RANGE 70~140 120~240 200~400 350~700'
vce_sat    specified=True  value='TYP 0.1, MAX 0.25' unit='V' cond='IC=100mA, IB=10mA'
           p.2 quote='Collector-Emitter Saturation Voltage VCE(SAT) IC=100mA, IB=10mA 0.1 0.25 V'
pc         specified=True  value='625' unit='mW' cond='TA=25°C'
           p.2 quote='Collector Power Dissipation (TA=25°C) PD 625 mW'
ft         specified=True  value='80' unit='MHz' cond='VCE=10V, IC=50mA'
           p.2 quote='Current Gain Bandwidth Product fT VCE=10V, IC=50mA 80 MHz'
vebo       specified=True  value='5' unit='V' cond='TA=25°C'
           p.2 quote='Emitter-Base Voltage VEBO 5 V'
ts         specified=False value=None unit=None cond=None
           p.None quote=None
---
input  : 2465 tokens
thought: 1772 tokens
output : 741 tokens
total  : 4978 tokens
  input[text]: 337 tokens
  input[image]: 2128 tokens
saved: E:\prog\google-ai-lab\out\02_2SC1815_with_pdf.json

===== NE555N (PDF あり: ne555.pdf, 7 pages, 160,552 bytes) =====
count_tokens(PDF only): 3921 tokens  (560 tokens/page)
vcc        specified=True  value='2~18' unit='V' cond=None
           p.1 quote='Supply Voltage VCC 2 18 V'
iout       specified=True  value='100' unit='mA' cond=None
           p.1 quote='Output Current IO - 100 mA'
icc        specified=True  value='200 (VCC = 2V), 300 (VCC = 18V)' unit='µA' cond='VCC = 2V, VCC = 18V'
           p.5 quote='VCC = 2V 200'
fmax       specified=True  value='500' unit='kHz' cond='VCC = 5V, astable mode'
           p.5 quote='Guaranteed Max Osc Freq. fMAX VCC = 5V, astable mode 500 kHz'
vth_vtrig  specified=True  value='VTH: 3.2~3.5, VTRIG: 1.55~1.8' unit='V' cond='VCC = 5V'
           p.5 quote='Threshold Voltage VTH VCC = 5V 3.2 3.5'
astable_f  specified=False value=None unit=None cond=None
           p.None quote=None
cmos_diff  specified=True  value='low supply current, wide operating supply voltage range, low THRESHOLD, TRIGGER and RESET currents, no crowbarring of the supply current during output transitions, higher frequency performance and no requirement to decouple CONTROL VOLTAGE for stable operation' unit=None cond=None
           p.1 quote='Improved parameters include low supply current, wide operating supply voltage range, low THRESHOLD,'
---
input  : 4031 tokens
thought: 1581 tokens
output : 756 tokens
total  : 6368 tokens
  input[image]: 3724 tokens
  input[text]: 307 tokens
saved: E:\prog\google-ai-lab\out\02_NE555N_with_pdf.json
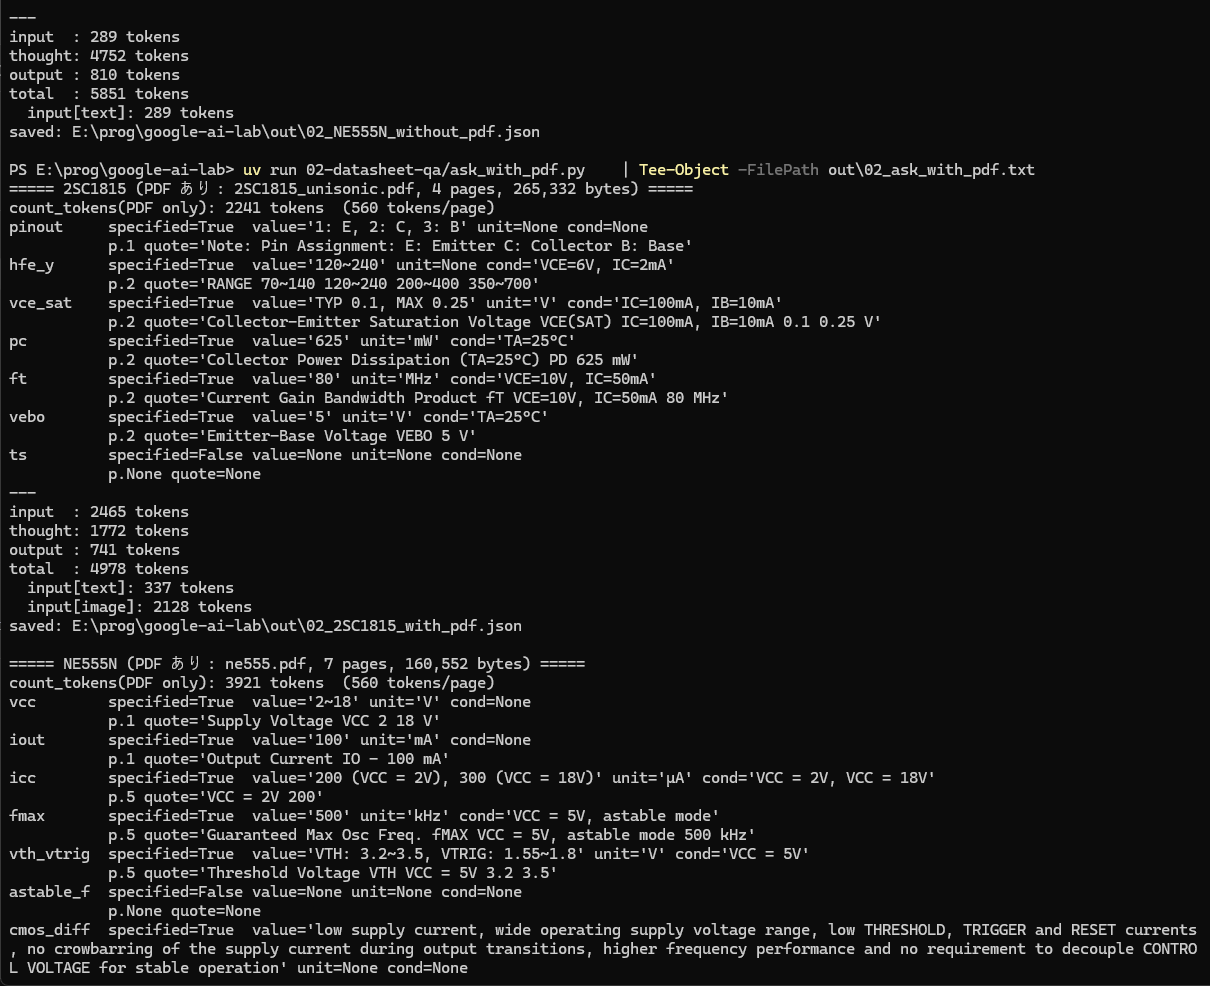
ask_with_pdf.py の実行画面。count_tokens は 560 トークン/ページ(4 ページで 2,241・7 ページで 3,921)、usage の入力の内訳は input[text] と input[image] の 2 行に分かれて出ている
コードの要点です。
{"type": "document", "data": base64, "mime_type": "application/pdf"}を先、質問を後に置きます。公式の例と Best practices の順です。base64 にすると 4/3 倍のサイズになりますが、265 KB の PDF なら問題になりませんclient.models.count_tokens(model=MODEL, contents=[types.Part.from_bytes(...)])は生成をしないので、PDF だけを渡せば「PDF が何トークンか」が生成前に分かります。料金表にcountTokensの行は無く、費用の自算には入れていません。ページ数で割った値が 258 か 560 に近いかを見ますinteraction.usage.input_tokens_by_modalityを表示しています。Document understanding のページは Gemini 3 では PDF のページ画像ぶんのトークンが IMAGE モダリティとして数えられると書き、料金ページの注記は DOCUMENT モダリティとして現れると書いています。どちらで返るかは、ここで分かります(結果はimageでした。上の実出力のinput[image]の行)- 実出力は
out/02_<部品>_with_pdf.jsonに、PDF の sha256・ページ数・count_tokensの値・usage・回答をまとめて保存します。次の照合はこのファイルを読みます
258 か 560 かは、560 で決まりました。 count_tokens は 4 ページの PDF で 2,241、7 ページで 3,921 を返しました。560×4=2,240、560×7=3,920 に、どちらも 1 を足した値です(画面の tokens/page は四捨五入で 560)。Media resolution のページに書かれた Gemini 3 の既定値どおりで、Document understanding ページの 258 ではありません。
input_tokens_by_modality は text と image の 2 つで返ってきました。document というモダリティは現れていません。料金ページの注記が言う「DOCUMENT モダリティ」ではなく、Document understanding ページの説明どおり PDF のページは画像トークン(image)として数えられています。その image の値は 4 ページで 2,128、7 ページで 3,724 で、count_tokens の 2,241・3,921 より 113・197 だけ少ない(ページ数で割るとどちらも約 28 トークン/ページ)。生成前に数えた値と、生成時に内訳として現れた値が一致しない理由は、公式ドキュメントに説明を見つけていないので、ここでは事実だけを書いておきます。text は 337・307 で質問文の側です(PDF なしのときの 319・289 より、どちらも 18 多い)。
14 項目の specified は、ts(2SC1815 の蓄積時間)と astable_f(NE555N の無安定の周波数式)の 2 つだけが false、残り 12 項目が true でした。狙って混ぜた「この PDF に書いていないこと」2 項目が、そのまま false になっています。ts の note は「データシートにスイッチング時間の蓄積時間(t_stg/ts)の規定はありません」、astable_f は「データシートに発振周波数の計算式に関する記載なし(APPLICATION INFORMATION は T.B.D.)」。p.6 が T.B.D. であることまで読んで、「無い」と言っています。 p.2 の Storage Temperature(Tstg −55〜+150 ℃)の行を蓄積時間として引用することもありませんでした。
PDF なしで 400 mW だったコレクタ損失は 625 mW(note「データシート内の表記記号は PD となっています」)、IC=1 mA だった fT の条件は IC=50 mA に変わりました。NE555N の 7 項目も、電源電圧 2〜18 V・出力電流 100 mA・消費電流 200 µA(VCC=2 V)/300 µA(18 V)・最大発振周波数 500 kHz(VCC=5 V, astable mode)・しきい値 3.2〜3.5/1.55〜1.8 V と、PDF の値に置き換わっています。CMOS 版の相違点は p.1 DESCRIPTION の “Improved parameters include …” を引用して 6 点を列挙しました。値が人間が読んだ値と揃っているかは実験 4 の表で、引用が本当に PDF にあるかは次の実験 3 で確かめます。
🔬 実験 3:引用を PDF 本文と照合する(verify_quotes.py)
Gemini が返した quote を、pypdf で取り出した各ページの本文から探します。判定は 3 段階で、どこで一致したかを記録します。
そのまま含まれる?"} E -->|yes| EX["exact ○"] E -->|no| NS{"空白を全部除いて
含まれる?"} NS -->|yes| NSP["nospace ○"] NS -->|no| PA{"引用の語の 8 割以上が
同じページにある?"} PA -->|yes| PT["partial △"] PA -->|no| NO["none ×(根拠なし)"] Q -.->|"quote が null"| NQ["no_quote -"]
pypdf が取り出すテキストは、PDF の内部の描画順に並ぶので、表のセルが 1 行に潰れたり、V CBO のように記号の途中に空白が入ったりします。exact で落ちても、空白を除けば一致する(nospace)ことがよくあるので 2 段目を用意し、それでも落ちるものは「語の一致率」で部分一致を拾います。8 割という閾値は、表の 1 行を引用したときに単位や記号の 1〜2 語が欠けても拾える程度、という置き方です。閾値を厳しくすれば「根拠なし」が増え、緩めれば見逃しが増えます。
"""実験 3:Gemini が返した引用(quote)が PDF 本文に本当にあるかを pypdf で機械的に照合する(Google AI 実験室 #2)

照合は 3 段階。exact(空白を詰めた上で完全一致)→ nospace(空白を全部除いて一致)→ partial(引用の語の 8 割以上が同じページにある)。
どれにも当たらなければ none。quote が null なら no_quote。
"""

import json
import re
import sys
import unicodedata

from pypdf import PdfReader

from spec_qa import DATASHEET_DIR, DATASHEETS, OUT_DIR, QUESTIONS

sys.stdout.reconfigure(errors="replace")


def normalize(text: str) -> str:
    """表記ゆれを寄せる:NFKC(µ/μ・全角)、ダッシュ類、大文字小文字、連続空白"""
    text = unicodedata.normalize("NFKC", text)
    text = re.sub(r"[\u2010-\u2015\u2212]", "-", text)  # ‐ ‑ ‒ – — ― − → -
    text = text.casefold()
    return re.sub(r"\s+", " ", text).strip()


def match_quote(quote: str, pages: list[str]) -> tuple[str, int | None, float]:
    """(判定, 見つかったページ, 語の一致率) を返す"""
    q = normalize(quote)
    for i, page in enumerate(pages, 1):
        if q in page:
            return "exact", i, 1.0
    q_nospace = q.replace(" ", "")
    for i, page in enumerate(pages, 1):
        if q_nospace in page.replace(" ", ""):
            return "nospace", i, 1.0
    words = re.findall(r"[0-9a-zμ°%.+~/-]{2,}", q)
    best_ratio, best_page = 0.0, None
    for i, page in enumerate(pages, 1):
        page_nospace = page.replace(" ", "")
        hits = sum(1 for w in words if w in page or w in page_nospace)
        ratio = hits / len(words) if words else 0.0
        if ratio > best_ratio:
            best_ratio, best_page = ratio, i
    return ("partial" if best_ratio >= 0.8 else "none"), best_page, best_ratio


for part, ds in DATASHEETS.items():
    src = OUT_DIR / f"02_{part}_with_pdf.json"
    record = json.loads(src.read_text(encoding="utf-8"))
    pages = [normalize(p.extract_text() or "") for p in PdfReader(DATASHEET_DIR / ds["file"]).pages]
    labels = {q["id"]: q["label"] for q in QUESTIONS[part]}

    print(f"===== {part}: {src.name} vs {ds['file']} ({len(pages)} pages) =====")
    print(f"{'id':<10} {'specified':<9} {'match':<8} {'page':<12} {'words':<6} quote")
    results = []
    for a in record["answers"]["answers"]:
        if a["quote"]:
            verdict, found_page, ratio = match_quote(a["quote"], pages)
        else:
            verdict, found_page, ratio = "no_quote", None, 0.0
        page_ok = a["page"] is not None and a["page"] == found_page
        results.append({
            "id": a["id"], "label": labels.get(a["id"], a["id"]), "specified": a["specified"],
            "claimed_page": a["page"], "found_page": found_page, "page_ok": page_ok,
            "match": verdict, "word_ratio": round(ratio, 2), "quote": a["quote"],
        })
        page_str = f"{a['page']}->{found_page}" + ("" if page_ok or verdict in ("no_quote", "none") else " (page NG)")
        print(f"{a['id']:<10} {a['specified']!s:<9} {verdict:<8} {page_str:<12} {ratio:<6.2f} {(a['quote'] or '')[:60]}")

    summary = {k: sum(1 for r in results if r["match"] == k) for k in ("exact", "nospace", "partial", "none", "no_quote")}
    print(f"summary: {summary}")
    dest = OUT_DIR / f"02_{part}_verify.json"
    dest.write_text(json.dumps({"part": part, "pdf": ds["file"], "summary": summary, "results": results}, ensure_ascii=False, indent=2), encoding="utf-8")
    print(f"saved: {dest}")
    print()
uv run 02-datasheet-qa/verify_quotes.py | Tee-Object out/02_verify_quotes.txt
===== 2SC1815: 02_2SC1815_with_pdf.json vs 2SC1815_unisonic.pdf (4 pages) =====
id         specified match    page         words  quote
pinout     True      exact    1->1         1.00   Note: Pin Assignment: E: Emitter C: Collector B: Base
hfe_y      True      exact    2->2         1.00   RANGE 70~140 120~240 200~400 350~700
vce_sat    True      nospace  2->2         1.00   Collector-Emitter Saturation Voltage VCE(SAT) IC=100mA, IB=1
pc         True      exact    2->2         1.00   Collector Power Dissipation (TA=25°C) PD 625 mW
ft         True      nospace  2->2         1.00   Current Gain Bandwidth Product fT VCE=10V, IC=50mA 80 MHz
vebo       True      nospace  2->2         1.00   Emitter-Base Voltage VEBO 5 V
ts         False     no_quote None->None   0.00
summary: {'exact': 3, 'nospace': 3, 'partial': 0, 'none': 0, 'no_quote': 1}
saved: E:\prog\google-ai-lab\out\02_2SC1815_verify.json

===== NE555N: 02_NE555N_with_pdf.json vs ne555.pdf (7 pages) =====
id         specified match    page         words  quote
vcc        True      exact    1->1         1.00   Supply Voltage VCC 2 18 V
iout       True      exact    1->1         1.00   Output Current IO - 100 mA
icc        True      exact    5->5         1.00   VCC = 2V 200
fmax       True      exact    5->5         1.00   Guaranteed Max Osc Freq. fMAX VCC = 5V, astable mode 500 kHz
vth_vtrig  True      exact    5->5         1.00   Threshold Voltage VTH VCC = 5V 3.2 3.5
astable_f  False     no_quote None->None   0.00
cmos_diff  True      exact    1->1         1.00   Improved parameters include low supply current, wide operati
summary: {'exact': 6, 'nospace': 0, 'partial': 0, 'none': 0, 'no_quote': 1}
saved: E:\prog\google-ai-lab\out\02_NE555N_verify.json
page の列は Gemini が答えたページ->本文で見つかったページ で、食い違えば (page NG) を付けます。値と引用が正しくても ページ番号だけ外すことはありうるので、別に数えます。
summary は 2SC1815 が exact 3・nospace 3・no_quote 1、NE555N が exact 6・no_quote 1。partial と none は 0 でした。引用を返した 12 項目すべてで、引用文が PDF 本文に見つかっています。no_quote の 2 つは specified=false の ts と astable_f で、引用が無いのは正しい挙動です。ページ番号も 12 項目すべてで Gemini が答えたページ->見つかったページ が一致し、(page NG) は 0 件でした。
nospace の 3 件(VCE(sat)・fT・VEBO)は、pypdf の抽出テキストが v ce(sat)・f t・v ebo のように記号と添え字の間に空白を入れていた行です。Gemini は VCE(SAT)・fT・VEBO と詰めて引用したので exact では落ち、空白を除いた 2 段目で一致しました。primer で予想した「V CBO のような空白挿入」がそのまま起きています。同じ p.2 でもコレクタ損失の行の PD・TA は抽出テキストでも詰まっていたので、こちらは exact でした。照合の 2 段目を用意していなければ、正しい引用 3 件が「根拠なし」側に落ちていたことになります。
引用の長さには差があります。NE555N の消費電流は VCC = 2V 200 という 3 語の引用で、value に書かれた 300 µA(VCC=18 V)側は引用に含まれていません。CMOS 版の相違点は DESCRIPTION の 1 文の途中 “low THRESHOLD,” までで切れています。「1 行以内」という指示に従った結果で、照合には十分ですが、引用が短いほど「その行を読んだ」ことの証明力は弱くなります。
🔬 実験 4:4 列に並べる(measured.json・score.py)
最後に、人間が読んだデータシートの値と IC実験室の実測値を measured.json に置き、実験 1〜3 の出力と合わせて 1 枚の表にします。正解・不正解の判定はコードではしません。 並べるところまでをコードがやり、判断は表を見た人がします。
measured.json の値は、IC実験室 #4・#5 で公開した値と、PDF を開いて読んだ値です。実測の列には 測定条件を必ず添えています(hFE の 6 本は部品テスターの条件、VCE(sat) は IC=16.8 mA/IB=0.83 mA)。
{
  "sources": {
    "2SC1815": {
      "datasheet": "UTC 2SC1815 (QW-R201-006.P)",
      "measured_in": "IC実験室 #5 https://electwork.net/posts/2sc1815-transistor-lab/"
    },
    "NE555N": {
      "datasheet": "HTC NE555 (Jul. 2019_R1.0)",
      "measured_in": "IC実験室 #4 https://electwork.net/posts/ne555n-cmos-timer-ic-experiments/"
    }
  },
  "parts": {
    "2SC1815": {
      "items": {
        "pinout": {
          "datasheet": "1=E・2=C・3=B(TO-92。印字面を手前に左から)",
          "page": 1,
          "measured": "E・C・B の並びで配線し、実験 1〜4 の回路がすべて動作"
        },
        "hfe_y": {
          "datasheet": "120〜240(hFE1:V_CE=6V, I_C=2mA。全ランクでは 70〜700)",
          "page": 2,
          "measured": "6 本で 229・234・238・244・234・227(平均 234)。部品テスター FNIRSI LCR-P1、I_E 2.06〜2.22mA、逆算 I_B≈9µA、V_CE は不明"
        },
        "vce_sat": {
          "datasheet": "TYP 0.1 V/MAX 0.25 V(I_C=100mA, I_B=10mA)",
          "page": 2,
          "measured": "67 mV(I_C=16.8mA, I_B=0.83mA、強制 hFE≈20)"
        },
        "pc": {
          "datasheet": "625 mW(T_A=25℃)",
          "page": 2,
          "measured": "実験 1 のコレクタ損失 ≈1.1 mW(0.067V×16.8mA)。定格の 0.2%"
        },
        "ft": {
          "datasheet": "80 MHz MIN(V_CE=10V, I_C=50mA)",
          "page": 2,
          "measured": "-(未測定)"
        },
        "vebo": {
          "datasheet": "5 V(絶対最大定格)",
          "page": 2,
          "measured": "実験 3(2 石マルチバイブレータ・電源 5.0V)でベースの負振り −3.04 V。定格 5 V の内側"
        },
        "ts": {
          "datasheet": "規定なし(t_d/t_r/t_s/t_f の記載なし。Storage Temperature −55〜+150℃ はある)",
          "page": null,
          "measured": "約 1.3 µs(R_B=3.3kΩ、I_C 16.8mA、OFF エッジのカーソル読み。続く立ち上がりは 0.15 µs)"
        }
      }
    },
    "NE555N": {
      "items": {
        "vcc": {
          "datasheet": "2〜18 V(RECOMMENDED OPERATING RATINGS。絶対最大定格は 0〜18 V)",
          "page": 1,
          "measured": "V_CC=5 V で無安定動作を確認"
        },
        "iout": {
          "datasheet": "100 mA(絶対最大定格)",
          "page": 1,
          "measured": "-(未測定)"
        },
        "icc": {
          "datasheet": "MAX 200 µA(V_CC=2V)/300 µA(V_CC=18V)",
          "page": 5,
          "measured": "-(未測定)"
        },
        "fmax": {
          "datasheet": "500 kHz MIN(V_CC=5V, astable mode。FEATURES にも 500KHz guaranteed)",
          "page": 5,
          "measured": "-(実験は約 5 Hz)"
        },
        "vth_vtrig": {
          "datasheet": "THRESHOLD 3.2〜3.5 V/TRIGGER 1.55〜1.8 V(V_CC=5V)",
          "page": 5,
          "measured": "デューティ比 実測 66.62%(理論 66.7%。しきい値が 2/3・1/3 なら R1=R2 で 2/3 になる)"
        },
        "astable_f": {
          "datasheet": "記載なし(APPLICATION INFORMATION は T.B.D.)。一般式は f=1.44/((R1+2R2)C)",
          "page": 6,
          "measured": "R1=R2=10kΩ、C=10µF:計算 4.8 Hz、実測 5.083 Hz"
        },
        "cmos_diff": {
          "datasheet": "low supply current/wide operating supply voltage range/low THRESHOLD, TRIGGER and RESET currents/no crowbarring of the supply current during output transitions/higher frequency performance/no requirement to decouple CONTROL VOLTAGE(DESCRIPTION)",
          "page": 1,
          "measured": "-"
        }
      }
    }
  }
}
"""実験 4:データシート(人間が読んだ値)/Gemini(PDF なし)/Gemini(PDF あり+引用の照合結果)/実測 を 1 枚の Markdown 表にする(Google AI 実験室 #2)

正解・不正解の判定はしない。並べるところまでをコードがやり、判断は表を見た人がする。
"""

import json
import sys
from pathlib import Path

from spec_qa import DATASHEETS, OUT_DIR, QUESTIONS

sys.stdout.reconfigure(errors="replace")
MEASURED = json.loads((Path(__file__).resolve().parent / "measured.json").read_text(encoding="utf-8"))
MARK = {"exact": "○", "nospace": "○", "partial": "△", "none": "×", "no_quote": "-"}


def cell(text: str | None) -> str:
    return (text or "-").replace("|", "|").replace("\n", " ")


def answer_cell(a: dict | None) -> str:
    if a is None:
        return "(回答なし)"
    if not a["specified"]:
        return "規定なし" + (f"/{a['note']}" if a.get("note") else "")
    text = " ".join(x for x in (a["value"], a["unit"]) if x)
    if a.get("condition"):
        text += f"({a['condition']})"
    return text


def load_json(name: str) -> dict:
    path = OUT_DIR / name
    return json.loads(path.read_text(encoding="utf-8")) if path.exists() else {}


lines = []
for part in DATASHEETS:
    without = {a["id"]: a for a in load_json(f"02_{part}_without_pdf.json").get("answers", {}).get("answers", [])}
    with_pdf = {a["id"]: a for a in load_json(f"02_{part}_with_pdf.json").get("answers", {}).get("answers", [])}
    verify = {r["id"]: r for r in load_json(f"02_{part}_verify.json").get("results", [])}
    items = MEASURED["parts"][part]["items"]

    lines += [f"### {part}({DATASHEETS[part]['part']})", ""]
    lines += ["| 項目 | データシート(人間が読んだ値) | Gemini(PDF なし) | Gemini(PDF あり)+引用の照合 | 実測(IC実験室) |", "|:---|:---|:---|:---|:---|"]
    for q in QUESTIONS[part]:
        qid = q["id"]
        with_cell = answer_cell(with_pdf.get(qid))
        if qid in verify:
            v = verify[qid]
            with_cell += f" {MARK[v['match']]}"
            if v["claimed_page"] is not None:
                with_cell += f" p.{v['claimed_page']}" + ("" if v["page_ok"] or v["match"] in ("no_quote", "none") else f"→実際は p.{v['found_page']}")
        m = items.get(qid, {})
        lines.append(f"| {q['label']} | {cell(m.get('datasheet'))} | {cell(answer_cell(without.get(qid)))} | {cell(with_cell)} | {cell(m.get('measured'))} |")
    lines.append("")

lines.append("引用の照合: ○ = PDF 本文に一致(空白の違いは無視)/△ = 語の 8 割以上が同じページにある/× = 見つからない/- = 引用なし。p. は Gemini が答えたページ")
markdown = "\n".join(lines)
print(markdown)
dest = OUT_DIR / "02_score.md"
dest.write_text(markdown + "\n", encoding="utf-8")
print(f"\nsaved: {dest}")
uv run 02-datasheet-qa/score.py | Tee-Object out/02_score.txt
📊 採点表:データシート/PDF なし/PDF あり/実測
score.py が出した Markdown をそのまま貼ります(out/02_score.md)。○△×- は引用の照合結果、p. は Gemini が答えたページです。
2SC1815(2SC1815L-Y-T92)
| 項目 | データシート(人間が読んだ値) | Gemini(PDF なし) | Gemini(PDF あり)+引用の照合 | 実測(IC実験室) |
|---|---|---|---|---|
| ピン配置 | 1=E・2=C・3=B(TO-92。印字面を手前に左から) | 1: E, 2: C, 3: B | 1: E, 2: C, 3: B ○ p.1 | E・C・B の並びで配線し、実験 1〜4 の回路がすべて動作 |
| Y ランクの hFE 範囲 | 120〜240(hFE1:V_CE=6V, I_C=2mA。全ランクでは 70〜700) | 120~240(V_CE=6V, I_C=2mA) | 120~240(VCE=6V, IC=2mA) ○ p.2 | 6 本で 229・234・238・244・234・227(平均 234)。部品テスター FNIRSI LCR-P1、I_E 2.06〜2.22mA、逆算 I_B≈9µA、V_CE は不明 |
| V_CE(sat) | TYP 0.1 V/MAX 0.25 V(I_C=100mA, I_B=10mA) | TYP 0.1, MAX 0.25 V(I_C=100mA, I_B=10mA) | TYP 0.1, MAX 0.25 V(IC=100mA, IB=10mA) ○ p.2 | 67 mV(I_C=16.8mA, I_B=0.83mA、強制 hFE≈20) |
| コレクタ損失 | 625 mW(T_A=25℃) | 400 mW(Ta=25°C) | 625 mW(TA=25°C) ○ p.2 | 実験 1 のコレクタ損失 ≈1.1 mW(0.067V×16.8mA)。定格の 0.2% |
| f_T | 80 MHz MIN(V_CE=10V, I_C=50mA) | 80 (MIN) MHz(V_CE=10V, I_C=1mA) | 80 MHz(VCE=10V, IC=50mA) ○ p.2 | -(未測定) |
| V_EBO | 5 V(絶対最大定格) | 5 V(Ta=25°C) | 5 V(TA=25°C) ○ p.2 | 実験 3(2 石マルチバイブレータ・電源 5.0V)でベースの負振り −3.04 V。定格 5 V の内側 |
| 蓄積時間 | 規定なし(t_d/t_r/t_s/t_f の記載なし。Storage Temperature −55〜+150℃ はある) | 規定なし/UTC (Unisonic Technologies) 2SC1815 データシートにはスイッチング時間(t_stg を含む)の規定はありません。 | 規定なし/データシートにスイッチング時間の蓄積時間(t_stg/ts)の規定はありません。 - | 約 1.3 µs(R_B=3.3kΩ、I_C 16.8mA、OFF エッジのカーソル読み。続く立ち上がりは 0.15 µs) |
NE555N(NE555N (CMOS, DIP-8))
| 項目 | データシート(人間が読んだ値) | Gemini(PDF なし) | Gemini(PDF あり)+引用の照合 | 実測(IC実験室) |
|---|---|---|---|---|
| 電源電圧範囲 | 2〜18 V(RECOMMENDED OPERATING RATINGS。絶対最大定格は 0〜18 V) | 4.5~16 V | 2~18 V ○ p.1 | V_CC=5 V で無安定動作を確認 |
| 出力電流 | 100 mA(絶対最大定格) | ±225 mA | 100 mA ○ p.1 | -(未測定) |
| 消費電流 | MAX 200 µA(V_CC=2V)/300 µA(V_CC=18V) | 15 mA(V_CC = 15V, R_L = ∞) | 200 (VCC = 2V), 300 (VCC = 18V) µA(VCC = 2V, VCC = 18V) ○ p.5 | -(未測定) |
| 最大発振周波数 | 500 kHz MIN(V_CC=5V, astable mode。FEATURES にも 500KHz guaranteed) | 規定なし/HTC Korea NE555 データシートの電気的特性には最大発振周波数の保証値(規格値)の規定はありません。 | 500 kHz(VCC = 5V, astable mode) ○ p.5 | -(実験は約 5 Hz) |
| しきい値電圧 | THRESHOLD 3.2〜3.5 V/TRIGGER 1.55〜1.8 V(V_CC=5V) | THRESHOLD: 2.7~3.5, TRIGGER: 1.45~1.9 V(V_CC = 5V) | VTH: 3.2~3.5, VTRIG: 1.55~1.8 V(VCC = 5V) ○ p.5 | デューティ比 実測 66.62%(理論 66.7%。しきい値が 2/3・1/3 なら R1=R2 で 2/3 になる) |
| 無安定の周波数式 | 記載なし(APPLICATION INFORMATION は T.B.D.)。一般式は f=1.44/((R1+2R2)C) | 1.44 / ((R1 + 2 * R2) * C) | 規定なし/データシートに発振周波数の計算式に関する記載なし(APPLICATION INFORMATION は T.B.D.) - | R1=R2=10kΩ、C=10µF:計算 4.8 Hz、実測 5.083 Hz |
| CMOS 版の相違点 | low supply current/wide operating supply voltage range/low THRESHOLD, TRIGGER and RESET currents/no crowbarring of the supply current during output transitions/higher frequency performance/no requirement to decouple CONTROL VOLTAGE(DESCRIPTION) | 規定なし/HTC KoreaのNE555はバイポーラプロセス製品であり、CMOS製品ではないため、バイポーラ版SE/NE555との差異や改善点に関する記述はありません。 | low supply current, wide operating supply voltage range, low THRESHOLD, TRIGGER and RESET currents, no crowbarring of the supply current during output transitions, higher frequency performance and no requirement to decouple CONTROL VOLTAGE for stable operation ○ p.1 | - |
引用の照合: ○ = PDF 本文に一致(空白の違いは無視)/△ = 語の 8 割以上が同じページにある/× = 見つからない/- = 引用なし。p. は Gemini が答えたページ
表の読み方
採点の言葉は、表を見てから付けます。項目ごとに、次の順で読みます。
- PDF ありの値は、人間が読んだ値と一致しているか(値・単位・条件の 3 つとも)
- 引用の照合は ○ か。○ なら「読んだ上での答え」。× なら値が合っていても根拠なし
- PDF なしの値と、PDF ありの値は違うか。違えば、知識と資料が食い違った項目。同じなら、資料が無くても答えられた項目
- 書いていないことを聞いた 2 項目(
ts・astable_f)で、specified=falseと言えたか - 実測と並べて、どう読めるか。hFE の 6 本が Y ランクの範囲に入っているか、VCE(sat) 67 mV と規格 MAX 0.25 V の条件の違い、5.083 Hz と一般式の 4.8 Hz の差
この順で読んだ結果を、項目ごとにまとめます。PDF ありの列は、14 項目すべてが人間が読んだ値と一致するか、「規定なし」と正しく答えたかのどちらかで、引用の照合は ○ か -(引用なし)だけでした。食い違いは PDF なしの列に集まっています。
2SC1815
| 項目 | PDF なし | PDF あり+引用 | 実測と並べて |
|---|---|---|---|
| ピン配置 | 一致 | 一致・○ p.1 | この並びで IC実験室 #5 の 4 つの回路が動いた |
| Y ランクの hFE | 一致(条件も一致) | 一致・○ p.2 | 6 本は 227〜244。5 本が 120〜240 の中、1 本(244)が上限の外。ただし部品テスターの条件(IB≈9 µA・VCE 不明)は規格の条件(VCE=6 V, IC=2 mA)と同一ではないので、規格外とは言えない |
| VCE(sat) | 一致 | 一致・○ p.2 | 67 mV は MAX 0.25 V の内側。ただし IC=16.8 mA/IB=0.83 mA で、規格の 100 mA/10 mA と条件が違う |
| コレクタ損失 | 食い違い(400 mW=東芝版の値) | 一致(625 mW)・○ p.2 | 実験 1 の 1.1 mW は 400 mW でも 625 mW でも 1% 未満。この実験では差が効かないが、放熱ぎりぎりの設計なら 1.5 倍以上の差 |
| fT | 値は一致・条件が食い違い(IC=1 mA=東芝版・JCET 版の条件) | 一致(IC=50 mA)・○ p.2 | 未測定 |
| VEBO | 一致 | 一致・○ p.2 | 負振り −3.04 V は定格 5 V の内側 |
| 蓄積時間 | 「無い」と言えた | 「無い」と言えた(-) | 規格が無いので比べる相手がいない。実測 1.3 µs は「規格に無いから測った」値 |
NE555N
| 項目 | PDF なし | PDF あり+引用 | 実測と並べて |
|---|---|---|---|
| 電源電圧範囲 | 食い違い(4.5〜16 V=バイポーラ版の値) | 一致(2〜18 V)・○ p.1 | 5 V はどちらの範囲にも入る。3.3 V で動かすなら答えの違いが効く |
| 出力電流 | 食い違い(±225 mA) | 一致(100 mA)・○ p.1 | 未測定 |
| 消費電流 | 食い違い(15 mA。桁が違う) | 一致(200/300 µA)・○ p.5 | 未測定 |
| 最大発振周波数 | あるのに「無い」と言った | 一致(500 kHz MIN)・○ p.5 | 実験は約 5 Hz で、保証値の 5 桁下 |
| しきい値電圧 | 食い違い(2.7〜3.5/1.45〜1.9 V。範囲が広い) | 一致(3.2〜3.5/1.55〜1.8 V)・○ p.5 | デューティ比 66.62%(理論 66.7%)は、しきい値が 2/3・1/3 VCC の近くにあることと矛盾しない |
| 無安定の周波数式 | 無いのに「ある」と言った(式は一般式として正しいが、記載場所が架空) | 「無い」と言えた(T.B.D. まで読んだ・-) | 一般式の 4.8 Hz に対して実測 5.083 Hz。IC実験室 #4 では部品の誤差(±10〜20%)の範囲内としている。式は PDF の外から持ってくる必要がある |
| CMOS 版の相違点 | 食い違い(「CMOS ではない」と部品の正体を取り違え) | 一致(6 点を列挙)・○ p.1 | — |
数えると、PDF あり:一致 12・「無い」と言えた 2・食い違い 0・根拠なし(×)0。PDF なし:一致 5(うち「無い」と言えた 1)・食い違い 7・あるのに「無い」1・無いのに「ある」1。食い違い 7 のうち 5 つ(400 mW・IC=1 mA・4.5〜16 V・±225 mA・15 mA)は東芝版・バイポーラ版の値、つまり「別の部品の正しい値」で、残る 2 つはしきい値の範囲が広い方向に外れたものと、部品の正体の取り違えです。
実測との比較で書けるのは次のとおりです。hFE の 6 本(227〜244)は 5 本が Y ランクの 120〜240 の中、1 本(244)が上限 240 の外にありますが、部品テスターの測定条件は規格の条件と同一ではないので、規格外とは断定しません(IC実験室 #5 と同じ立場です)。VCE(sat) 67 mV は MAX 0.25 V より小さいですが、これも条件が違う比較です。NE555N の 5.083 Hz は、PDF に無い一般式から出した 4.8 Hz より約 6% 高く、IC実験室 #4 では R・C の誤差の範囲内としています。実測の列は、Gemini の答えが「規格の中か外か」を判定するためのものではなく、規格の数字が自分の回路でどう見えるかを並べるためのものです。
💡 分かったこと(事実)
- PDF のトークン数は 560/ページで、258 ではなかった。
count_tokensは 4 ページで 2,241・7 ページで 3,921(560×ページ数+1)。生成時のusageではimageモダリティとして 2,128・3,724 が現れ、count_tokensより 113・197 少なかった。モダリティ名はimageで、documentは現れなかった - PDF ありの 14 項目は、値・単位・条件が人間が読んだ値と一致した 12 項目と、「規定なし」と正しく答えた 2 項目で、食い違いは 0。 PDF なしで 400 mW だったコレクタ損失は 625 mW に、IC=1 mA だった fT の条件は 50 mA に、バイポーラ版の値だった NE555N の 5 項目は HTC 版の値に置き換わった
- 引用の照合は exact 9・nospace 3・partial 0・none 0・no_quote 2。 引用を返した 12 項目すべてが PDF 本文で見つかり、ページ番号も 12 項目すべてで一致した。nospace の 3 件は pypdf の抽出テキストが記号と添え字の間に空白を入れていた行(
v ce(sat)・f t・v ebo) - PDF なしは 14 項目中 5 項目だけが一致。 2SC1815 ではコレクタ損失 400 mW(UTC 版は 625 mW)と fT の条件 IC=1 mA(UTC 版は 50 mA)という東芝版の値が出た。NE555N では電源電圧 4.5〜16 V・出力電流 ±225 mA・消費電流 15 mA というバイポーラ版の値が出て、しきい値の範囲も広く、7 項目で一致は 0。
noteは 14 項目すべてで「UTC/HTC のデータシートを念頭に」と書いていた - 「無い」と言えたのは、PDF ありでは 2 項目とも(
ts・astable_f。いずれもspecified=false・quote=null、astable_fのnoteは p.6 の T.B.D. に触れている)。PDF なしではtsは「無い」と言えたが、astable_fは一般式に「データシートの Astable 動作アプリケーション欄に記載」という存在しない出典を付けてspecified=trueにし、逆に PDF にある最大発振周波数 500 kHz を「規定なし」、CMOS 版の相違点を「CMOS 製品ではない」とした - 費用は 4 回で 19,606 トークン・約 $0.052(約 8.3 円)。 思考トークンが 9,379 で全体の 48%。うち PDF なしの NE555N 1 回が 4,752 と最大で、PDF ありの 2 回は 1,772・1,581 だった
💭 所感:「根拠を出せ」はテストベンチの話だった
データシートの数字を AI に聞くとき、いちばん怖いのは「間違った値」ではなく、「別の正しい値」です。東芝版の 400 mW も UTC 版の 625 mW も、どちらも本物の 2SC1815 のデータシートに書いてある数字で、どちらかが嘘なわけではありません。手元の石が UTC 製なら 625 mW が正解で、400 mW は「隣の部品の正解」です。IC実験室 #5 で「手元の石のメーカーのデータシートを見ろ」と書いたのと同じことが、AI に聞くときにも、より強く当てはまります。どの資料を根拠にしたかを答えさせない限り、正しい値と隣の正解は区別できません。
それを区別する道具が「引用を返させて、機械で照合する」でした。書いてみると、これはオシロで波形を見るときに「プローブは 10:1 か、カップリングは DC か」を先に揃えるのと同じ種類の作業でした。測定条件を揃えないで比べた数字は、合っていても外れていても意味が薄い。 AI の答えも、根拠(引用)とその位置(ページ)を同じスキーマで返させ、pypdf という別の経路で同じ PDF を読んで照合する。2 系統で測って一致を見る、というだけの話です。
もうひとつ。「この PDF には書いていない」と言える出口(specified=false)をスキーマに作るのは、回路で言えば 入力を開放にしないのと同じでした。出口が無いと、モデルは空欄を埋めようとします。それは「AI が嘘をつく」のではなく、埋めろというスキーマをこちらが渡しているからです。設計の責任はこちら側にあります。
結果を見て、線はこう引きました。引用が ○ で、値・単位・条件が揃っている項目は、自分で PDF を開いて見に行く手間を省いてよい。 今回はそれが 12 項目で、照合で落ちたものは 0 でした。一方、PDF なしの答えは、note に「UTC を念頭に」「HTC を念頭に」と書いてあっても 14 項目中 9 項目が手元の PDF と違っていて、その多くが東芝版の 400 mW やバイポーラ版の 4.5〜16 V のように 別の部品の正しい値でした。自己申告は根拠にならず、根拠になるのは、こちらが別経路で照合できる引用だけです。「無い」と言えるかどうかも、出口を作った上で PDF を渡したときは 2 項目とも言えて、渡さなければ「ある」と「無い」が両方向に外れました。
💰 費用:PDF のページ数からの見積りと、実測
生成前に分かる分:PDF のページ数
PDF の画像経路のトークン数は、生成する前にページ数から見積もれます。Gemini 3 の既定(560 トークン/ページ)と、Document understanding ページの 258 トークン/ページの両方で計算しておきます。
| ページ数 | 560/ページ | 258/ページ | |
|---|---|---|---|
| UTC 2SC1815 | 4 | 2,240 | 1,032 |
| HTC NE555 | 7 | 3,920 | 1,806 |
| 合計 | 11 | 6,160 | 2,838 |
入力単価 $0.75/100 万トークン(gemini-3.8-flash・Paid Tier・2026-12-31 まで)を掛けると、PDF 11 ページぶんは 560 のとき $0.0046、258 のとき $0.0021 です。これに質問文(14 項目で 2 回×約 400 トークン)と、PDF なしの 2 回ぶんが乗ります。出力と思考トークンは、JSON が 14 項目×2 部品×2 回なので、#1 の 1 発(思考 628・出力 81)より桁で多くなるはずですが、生成前には分かりません。
実測
4 回の呼び出しの usage(各 JSON の total_input_tokens/total_thought_tokens/total_output_tokens/total_tokens)と、生成前の count_tokens です。
| 呼び出し | 入力 | 思考 | 出力 | 合計 | count_tokens(PDF のみ) |
|---|---|---|---|---|---|
| 2SC1815・PDF なし | 319 | 1,274 | 816 | 2,409 | — |
| NE555N・PDF なし | 289 | 4,752 | 810 | 5,851 | — |
| 2SC1815・PDF あり | 2,465 | 1,772 | 741 | 4,978 | 2,241 |
| NE555N・PDF あり | 4,031 | 1,581 | 756 | 6,368 | 3,921 |
| 合計 | 7,104 | 9,379 | 3,123 | 19,606 | 6,162 |
入力の内訳(input_tokens_by_modality)は、PDF なしが text だけ(319・289)、PDF ありが text 337+image 2,128(2SC1815)と text 307+image 3,724(NE555N)です。PDF 11 ページぶんの image は合計 5,852 で、生成前の見積り 6,160(560/ページ)と count_tokens の合計 6,162 より 5% 少ない値でした。思考トークンは合計の 48% を占め、PDF なしの NE555N 1 回(4,752)だけで全体の 4 分の 1 です。
単価は料金ページ(2026-09-16 更新)の gemini-3.8-flash Paid Tier で、入力 $0.75、出力(思考トークン込み)$3.75/100 万トークン。料金ページの注記には「DOCUMENT モダリティのトークン(PDF など)は画像トークンの単価で課金」とあり、gemini-3.8-flash の料金表は入力単価が 1 行だけでモダリティ別の行が無いので、PDF ぶんも同じ入力単価で自算します(実際の usage に現れたモダリティ名は document ではなく image でしたが、単価が 1 行なので計算は変わりません)。円換算は #1 と同じ ¥159.4/$(Developer Program のクレジット表示 $10=¥1,594 から)です。
自算は次のとおりです。入力 7,104 トークンに $0.75、思考と出力を合わせた 12,502 トークンに $3.75(いずれも 100 万トークンあたり)を掛けます。
\frac{7104 \times 0.75 + (9379 + 3123) \times 3.75}{10^{6}} = 0.00533 + 0.04688 \approx 0.0522約 $0.0522、¥159.4/$ で約 8.3 円です。入力側は $0.0053 で全体の 1 割、残りの 9 割は思考と出力です。PDF 11 ページぶんの画像トークン(5,852)だけを取り出すと $0.0044 で、生成前の見積り $0.0046 とほぼ同じでした。countTokens は料金表に行が無いので入れていません。2027-01-01 以降の単価(入力 $1.50・出力 $7.50)では 2 倍の 約 $0.104、約 16.6 円になります。
gemini-3.8-flash の Paid Tier は 2027-01-01 から入力 $1.50・出力 $7.50 になります(料金ページに 2 段で記載)。この記事の円換算は 2026 年内の単価です。
⚠️ できないこと・確認していないこと
- 判定はしていません。
score.pyは 4 列を並べるだけで、「正解」「不正解」の判定は表を見た人間がしています。閾値(語の一致率 8 割)を変えれば △ と × の境目は動きます - 引用の照合は「本文にその文字列があるか」だけを見ています。引用が一致していても、値の解釈(TYP と MAX の取り違え、条件の落とし)は照合では捕まりません。だから値・単位・条件を人間が読んだ値と別に比べています
- pypdf の抽出テキストに依存しています。テキスト層の無いスキャン PDF では照合できません(Gemini 側は画像として読めます)。今回の 2 本はテキスト層があることを確認して選んでいます
- 1 回ずつしか実行していません。 同じ質問を複数回投げたときの揺れ(
seedを固定しない既定の設定での再現性)は見ていません。google-genai2.23.0 の Interactions API 用generation_configにtemperatureは無く、seedはありますが今回は使っていません media_resolutionは既定のままです。SDK 2.23.0 のDocumentContentにresolutionフィールドが無いため、low/medium/high でトークン数と答えがどう変わるかは試していません- Files API は使っていません。 インラインで渡せる大きさだったためです。同じ PDF に何度も質問する場合の使い勝手(48 時間の保存・URI の再利用)は未検証です
- 実測値は IC実験室 #4・#5 で公開した値の転記で、この記事のために追加の測定はしていません。hFE の 6 本は部品テスターの条件(IB≈9 µA・VCE 不明)で、データシートの条件(VCE=6 V, IC=2 mA)とは同一ではありません
- HTC NE555 のデータシートのピン説明には、5 番 CONTROL VOLTAGE が “Timing capacitor upper voltage sense input”、6 番 THRESHOLD が “Timing capacitor lower voltage sense input” と書かれています。一般的な 555 の説明(THRESHOLD が 2/3 VCC の上側しきい値)とは記述の対応が異なりますが、この記事ではピン説明を質問項目に入れておらず、解釈もしていません
- 無料枠では実行していません。
gemini-3.8-flashは Free Tier で入出力トークンが無料なので同じコードは動くはずですが、#1 の方針どおり Tier 1 の記事専用プロジェクトで実行しています - 258 トークン/ページの記述がどの世代の値かは、Document understanding のページに注記が無く、確認できていません。今回の
count_tokensは 560×ページ数+1(2,241・3,921)で、258 側の値は出ませんでした count_tokensとusageのimageの差(4 ページで 113、7 ページで 197)の理由は分かっていません。生成前に PDF だけを数えた値と、生成時に内訳として現れた値が一致しない、という事実だけを書いています。費用の自算はusageの値で計算していますusageの JSON には、SDK 2.23.0 のUsage型に定義の無いフィールドも入っていました。model_dump()した結果にraw_prompt_token(1,109/1,079/4,534/6,876)とmodel_invocation_token_countsが含まれ、raw_prompt_tokenはtotal_input_tokens(319/289/2,465/4,031)より大きい値です(差は PDF なしの 2 回がどちらも 790、PDF ありが 2,069・2,845)。Token counting のページ(2026-09-17 更新)にこのフィールドの説明は無く、どちらが課金の入力側に当たるかは料金表からも読めません。この記事の自算は、SDK の型に定義があるtotal_input_tokensで計算しています。仮にraw_prompt_tokenで計算し直すと入力側が $0.0102 になり、合計は約 $0.057(約 9.1 円)です
✅ まとめ
- Gemini は PDF を ページ画像(Gemini 3 の既定で 560 トークン/ページ・課金)と埋め込みテキスト(課金されない)の 2 経路で読む。上限は 50 MB/1,000 ページ。インラインは 50 MB まで、Files API は 2 GB・48 時間保存・無料
- Interactions API では
{"type": "document", "data": base64, "mime_type": "application/pdf"}を質問の前に置く。SDK 2.23.0 では PDF のmedia_resolutionを個別指定できない - 値・単位・条件・引用・ページを別フィールドにし、
specified=falseの出口を作る。hFE のように条件で値が変わる項目は、条件抜きの質問に定まった答えが無い - 引用を pypdf で PDF 本文と照合すると、「読んだ上での答え」と「知識で埋めた答え」を機械的に分けられる。一致しても解釈ミスは残るので、値と条件の比較は別にやる
- 「この PDF に書いていないこと」(2SC1815 の蓄積時間・NE555N の無安定の周波数式)を混ぜて、「無い」と言えるかを見る。PDF ありでは 2 項目とも
specified=falseと言えた。PDF なしでは、無い式に架空の出典を付け、ある規格値(500 kHz MIN)を「無い」と言った - 4 列の採点表では、PDF あり 14 項目が一致 12・「規定なし」正答 2・食い違い 0・根拠なし 0(引用照合 exact 9・nospace 3・no_quote 2・ページ外れ 0)。PDF なしは一致 5・食い違い 7・あるのに「無い」1・無いのに「ある」1 で、食い違いの多くは東芝版・バイポーラ版という「別の部品の正しい値」
- 費用は 4 回で 19,606 トークン・約 $0.052(約 8.3 円)。PDF 11 ページぶんの入力は生成前に $0.0046(560/ページ)と見積もれ、実測の
count_tokensは 2,241+3,921=6,162 で見積りどおりだった。usageのimageは 5,852 とやや少ない。2027-01-01 から単価は 2 倍
よくある質問(FAQ)
Q: PDF を渡すと、何トークンかかりますか?
A: Gemini 3 世代では、PDF の各ページが画像として 既定 560 トークン(media_resolution を low にすれば 280、high なら 1,120)で数えられ、PDF に埋め込まれたテキストは抽出して渡されますが課金されません(Media resolution・Document understanding の各ページ)。生成する前に client.models.count_tokens() に PDF だけを渡せば、自分の PDF が何トークンかを確かめられます。この記事では 4 ページと 7 ページの PDF で 2,241 と 3,921(560×ページ数+1)でした。生成時の usage では image モダリティとして 2,128・3,724 が現れ、count_tokens より少し少ない値でした。
Q: Files API を使わなくてよいのですか?
A: PDF が 50 MB 以下(リクエスト全体で 100 MB 以下)ならインラインで渡せます。Files API(client.files.upload())は、大きいファイルや、同じファイルに何度も質問する場合に向いていて、1 ファイル 2 GB・プロジェクト 20 GB まで、保存は 48 時間、利用は無料です。今回は 265 KB と 160 KB の PDF に 1 回ずつ質問するだけなので、インラインにしました。
Q: 引用が PDF 本文と一致していれば、その答えは正しいと言えますか?
A: 「その箇所を読んだ上での答え」とは言えますが、値の解釈が正しいことまでは保証しません。TYP と MAX を入れ替える、測定条件を落とす、といった間違いは引用の照合では捕まりません。だからこの記事では、引用の照合とは別に、値・単位・条件を人間が読んだ値と比べています。逆に、引用が一致しないのに値が合っている場合は、別の資料(別メーカーの同名部品)の値や記憶で埋めた値の可能性があるので、根拠なしとして扱います。
Q: generateContent でも同じことができますか?
A: できます。generateContent は legacy 扱いですがサポートは続いていて、PDF は Part.from_bytes(data=..., mime_type="application/pdf") で渡せます(この記事の count_tokens はまさにその形です)。ただし公式が新規プロジェクトに推奨し、新機能が先に載るのは Interactions API で、Document understanding のページの例も Interactions API の形になっています。
Q: データシートの PDF をリポジトリに入れて配ってはいけないのですか?
A: データシートは各メーカーの著作物です。UTC の PDF には「著作権者の書面による事前の同意なしに全体または一部を複製することを禁止する」旨の一文があります。この記事では PDF をリポジトリに入れず、秋月電子の商品ページからリンクされている URL から読者自身に取得してもらう形(download_datasheets.py)にしました。本文中の引用は、照合の説明に必要な 1〜2 行に留めています。
Q: スキャンした(テキスト層の無い)データシートでも動きますか?
A: Gemini 側はページを画像として読むので、質問には答えられるはずです(この記事では試していません)。一方、verify_quotes.py の照合は pypdf が取り出すテキスト層に依存するので、テキスト層が無い PDF では照合できません。その場合は OCR でテキスト層を付けてから照合する、という手順が要ります。
Q: 無料枠でもできますか?
A: gemini-3.8-flash は Free Tier で入出力トークンが無料なので、同じコードが動くはずです。ただし規約上、無料枠に投げた内容は Google の製品改善に使われます。今回投げるのは公開されているデータシートと質問文だけなので問題は小さいですが、この連載は #1 で決めたとおり Tier 1 の記事専用プロジェクトで実行しています。
関連記事
- 【Google AI 実験室 #1】準備編|Google AI Studio で記事専用プロジェクトを作り、API キーを発行して Gemini を最初に呼ぶまで:この記事の環境(プロジェクト・
.env・uv・Interactions API・構造化出力)はここで作ったもの - 【連載】Google AI 実験室 ― Gemini・Gemma・Google Labs を一つずつ、手を動かして確かめる:この連載のハブ
- 2SC1815で学ぶトランジスタの基本|スイッチ・増幅・発振を1個の石で【IC実験室 #5】:hFE 6 本・VCE(sat) 67 mV・蓄積時間 1.3 µs・VEBO と負振り −3.04 V の実測はここ。東芝/UTC/JCET の規格表の違いも
- NE555N(CMOS版555タイマーIC)の使い方|Lチカ回路と動作原理、バイポーラ版との違い:4.8 Hz の計算と 5.083 Hz の実測、デューティ比 66.62% はここ
- 【連載】IC実験室 ― 部品を一個ずつ、データシートから実測まで味わい尽くす:データシートと実測を突き合わせる「型」の出どころ
参考
一次ドキュメントの取得日は 2026-09-19 です。
- Document understanding(ai.google.dev):PDF のインライン/Files API の渡し方(Interactions API 形)・50 MB/1,000 ページ・「各ページ 258 トークン」・Gemini 3 の Native text(課金されない)と IMAGE モダリティ・3,072/768 px のスケーリング・Best practices(Last updated 2026-09-17)
- Media resolution(ai.google.dev):Gemini 3 の PDF トークン数(unspecified 560・low 280・medium 560・high 1,120+Native Text)・PDF は medium 推奨(Last updated 2026-09-18)
- File input methods(ai.google.dev):インライン 100 MB(PDF 50 MB)・Files API 2 GB/20 GB/48 時間・外部 URL(Last updated 2026-09-17)
- Files API(ai.google.dev):48 時間の自動削除・プロジェクト 20 GB(Last updated 2026-09-17)
- Interactions API(ai.google.dev):GA・
generateContentは legacy でサポート継続・store・対応モデル(Last updated 2026-09-17) - Structured outputs(ai.google.dev):
response_format・対応する JSON Schema のサブセット(null型・anyOf・$ref)・Pydantic の例・「値の妥当性はアプリ側で検証」(Last updated 2026-09-17) - Understand and count tokens(ai.google.dev):
count_tokensとusageの各フィールド(Last updated 2026-09-17) - Gemini Developer API pricing(ai.google.dev):
gemini-3.8-flashの単価と 2027-01-01 改定・「Document token billing」の注記(Last updated 2026-09-16) - python-genai(GitHub):
DocumentContent(data/mime_type/uri)・Usage.input_tokens_by_modalityの定義(google-genai2.23.0 のソースで確認) - pypdf(PyPI):6.19.0(2026-09-16)
- トランジスター 2SC1815L-Y-T92(秋月電子通商)/UTC 2SC1815 データシート PDF:4 ページ・QW-R201-006.P(2026-09-19 取得・HTTP 200・application/pdf)
- タイマーIC NE555N(秋月電子通商)/HTC NE555 データシート PDF:7 ページ・Jul. 2019_R1.0(2026-09-19 取得・HTTP 200・application/pdf)
- google-ai-lab(GitHub):この記事のコード全文(
02-datasheet-qa/)