はじめに
米国時間2026年11月9日(日本時間では10日)、Anthropic が Claude Fable 5.2 と Claude Mythos 5.2 を公開しました。9月1日の Fable 5.1 から約10週間での更新です。
5.1 のときに動いた価格はキャッシュ読み取りの1行だけでした。今回は違います。変わったのは次の3つです。
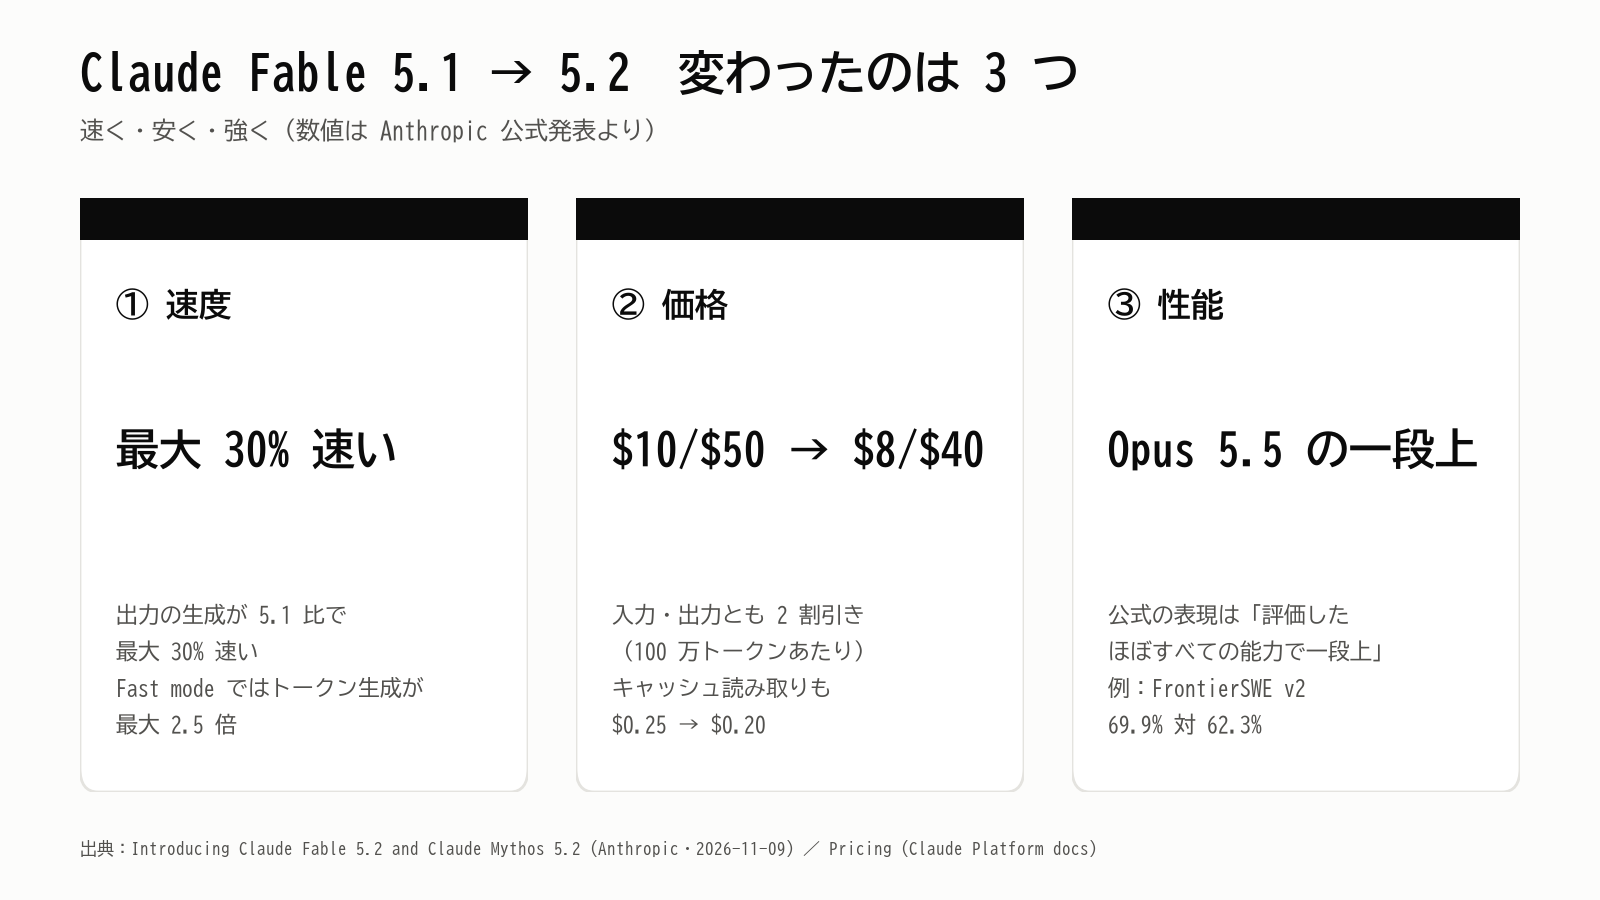
図1:5.1 → 5.2 の変更点。どれも同じ1Mトークンのコンテキストと同じAPIのままで起きている
図1で見てほしいのは、速度・価格・性能の3つが同じ方向に動いている点です。新しいモデルは速くなれば高くなる、強くなれば遅くなる、ということが多いのですが、今回は出力の生成が 5.1 より最大30%速く、入力・出力の単価はともに2割下がり、そのうえで公式の評価表では一つ下の段にあたる Opus 5.5 を主要な評価で上回っています。
公式の発表には、電子工作をする人なら目が止まる一文もあります。リリース前のテストで Fable 5.2 は基板と3Dプリントの筐体とソフトウェアを備えた電子機器を3つ、ゼロから設計し、3つとも電気的な手直しなしで動いた、というものです。
この記事では、Anthropic の公式発表・公式ドキュメント・料金表を根拠に、次の6つを整理します。
- Fable と Mythos とは何か(同じモデルで、入口と安全装置が違う)
- 5.1 から 5.2 で何が変わったか(変更点・ベンチマーク・公式の事例)
- 価格と提供(API 単価、プランでの使える量、プラットフォーム)
- 安全装置はどう変わったか(ブロックの減り方と、ブロックされたときの返り方)
- 開発者が移行で気をつけること(破壊的変更4件)
- どのモデルを使うか(公式の推奨と使い分けの勘所)
数値はすべて Anthropic の発表値で、第三者による独立検証ではありません。
1. 🧬 Fable と Mythos とは——同じモデルに、2つの入口
Claude Fable は Anthropic のモデル群の最上段にあたるシリーズです。公式はこれを「もっとも困難な技術的課題に取り組むために設計されたモデル」と位置づけ、普段使いの主力である Claude Opus より一段上の、何時間も走らせる長いエージェント作業や深い調査向けとしています。
そして Claude Mythos は、Fable と同じ中身のモデルです。公式発表は「Claude Fable と Claude Mythos は同じ基盤モデルである」と明記しています。違うのは2つだけです。
- 安全装置:Fable にはサイバーセキュリティと生物学の悪用を防ぐ強い安全装置が付いている。だから誰にでも提供できる
- 入口:Mythos はその安全装置の一部を外した構成で、Anthropic の審査を通った組織だけが使える
Anthropic が Mythos を提供する相手を審査する枠組みです。サイバーセキュリティ向けの Cyber Verification Program(防御・認可された侵入テストなどの専門家向け)と、生命科学研究向けの Life Sciences Verification Program があります。用途に合うプログラムに申し込み、通った組織だけが claude-mythos-5-2 を呼べます。Claude Enterprise の契約者は、審査を通っていなくても、Mythos 5.2 を含むモデル群で動く脆弱性スキャン製品 Claude Security を使えます。
(同じ重み)"] M --> F["Fable 5.2
誰でも使える
安全装置つき"] M --> Y["Mythos 5.2
審査を通った
組織だけ"] F -->|高リスク| R["拒否を返す
(アプリでは
別モデルが応答)"] Y --> V["Verification
Program で申請"]
図2は、同じモデルが2つの入口に分かれる様子です。見てほしいのは、Fable 側にだけ「高リスク」と判定されたときの矢印があることです。モデルの中身は同じで、違うのは安全装置と入口だけ、という関係がここに出ています。ブロックされたときに何が起きるかは4章で詳しく書きます。
Fable と Mythos の関係が生まれた経緯(Fable 5 の公開直後の停止と再展開)と、5.1 の時点での整理は Claude Fable 5.1 の記事の「Fable と Mythos とは」にまとめています。
2. 📊 5.1 から 5.2 で何が変わったか
2-1. 変更点の一覧
| 項目 | Claude Fable 5.1 | Claude Fable 5.2 |
|---|---|---|
| 入力 / 出力の単価 | $10 / $50 | $8 / $40 |
| キャッシュ読み取り | $0.25 | $0.20(乗数は同じ 0.025倍) |
| 出力の生成速度 | — | 5.1 比で最大30%速い |
| Fast mode | — | トークン生成が最大2.5倍($16 / $80) |
| コンテキスト / 最大出力 | 1M / 128K | 1M / 128K(据え置き) |
| 思考の方式 | adaptive thinking 常時オン | 同じ(据え置き) |
| effort の API 既定値 | high |
high(据え置き) |
| 安全装置のブロック | — | 5.1 比で約55%減 |
| レート制限 | Fable 5 と共有 | 5.2 単独の枠 |
単価は100万トークン(MTok)あたりの米ドルです。
adaptive thinking は、モデルが答える前に「考える」量を、モデル自身が問題に応じて決める方式です。Fable 5.2 では常にオンで、切ることはできません(thinking を disabled にしたり、考える量を budget_tokens で直接指定したりすると 400 エラーになります)。
その代わりに使うのが effort というパラメータで、low / medium / high / xhigh / max の5段階から「どれだけ深く考えさせるか」を選びます。上げるほど賢くなりやすい一方、時間とトークン(=料金)が増えます。API の既定値は high で、Claude のアプリと Claude Code では medium が既定です。公式ドキュメントは「能力の伸びの大半は high で得られる。最難関の長いコーディングやエージェント作業で効果を測れたときだけ xhigh へ、max は上限の測定やまれな用途に」と勧めています。
2-2. 「最大30%速い」は何が速いのか
公式の言い方は「Claude Fable 5.1 より最大30%速く出力を生成する」です。ここで速くなるのはトークンを生み出す速さで、課題が早く終わるかどうかはそれだけでは決まりません。答えるまでの時間は「考える量(effort で決まる)+出力の長さ」で決まるからです。
そのうえで公式は、トークン数そのものも減ったと書いています。Claude アプリと Claude Code の既定である medium では「Fable 5.1 より少ないトークンで難しい課題をこなせる」。生成が速く、使うトークンが少ないなら、体感の待ち時間は両方の効果で縮みます。
さらに速さが欲しいときのために Fast mode があります。
同じモデルのまま、トークンの生成速度を上げる有料オプションです。Fable 5.2 ではトークン生成が最大2.5倍になり、単価は入力 $16・出力 $80(標準の2倍)です。Claude API ではリクエストに speed: "fast" を付けて使います。Batch API とは併用できません。Claude Code・Claude Platform・Google Cloud・Microsoft Foundry(Anthropic がホストする構成)で使えます。
2-3. ベンチマーク:Opus 5.5 との比較
公式発表の表から、一般提供モデル同士(Fable 5.2・Opus 5.5・Fable 5.1)の数字を抜き出しました。
| 評価(測るもの) | Fable 5.2 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|
| FrontierCode 2.0(OSSに取り込まれるコード変更) | 49.1% | 45.5% | 32.4% |
| FrontierSWE v2(超長期のソフト開発) | 69.9% | 62.3% | 56.3% |
| AutomationBench(業務ワークフロー) | 51.4% | 42.5% | 31.4% |
| Terminal-Bench-Science 0.1(科学研究の作業) | 74.6% | 58.7% | 52.6% |
| WANDR(大量のデータ収集) | 82.1% | 72.3% | 68.7% |
| OSWorld 2.1(パソコン操作) | 89.3% | 87.2% | 83.5% |
| RoboDojo Sim(2本腕ロボットの制御) | 64.9% | 39.4% | 27.6% |
| Remote Labor Index(知識労働) | 41.3% | 21.3% | 17.9% |
| Humanity’s Last Exam(ツールあり) | 74.2% | 67.7% | 65.6% |
| Chartography(グラフの読み取り) | 73.4% | 64.4% | 44.8% |
条件は公式の脚注どおりで、安全装置はオン、各モデルの最大 effort です(FrontierCode 2.0 の Fable 5.2 と 5.1 は xhigh、Remote Labor Index の Fable 5.2 は high と表に注記あり)。WANDR は relaxed score、OSWorld 2.1 はオフラインセットの部分集合での値と表のラベルにあります。RoboDojo Sim は Anthropic の社内実行です。
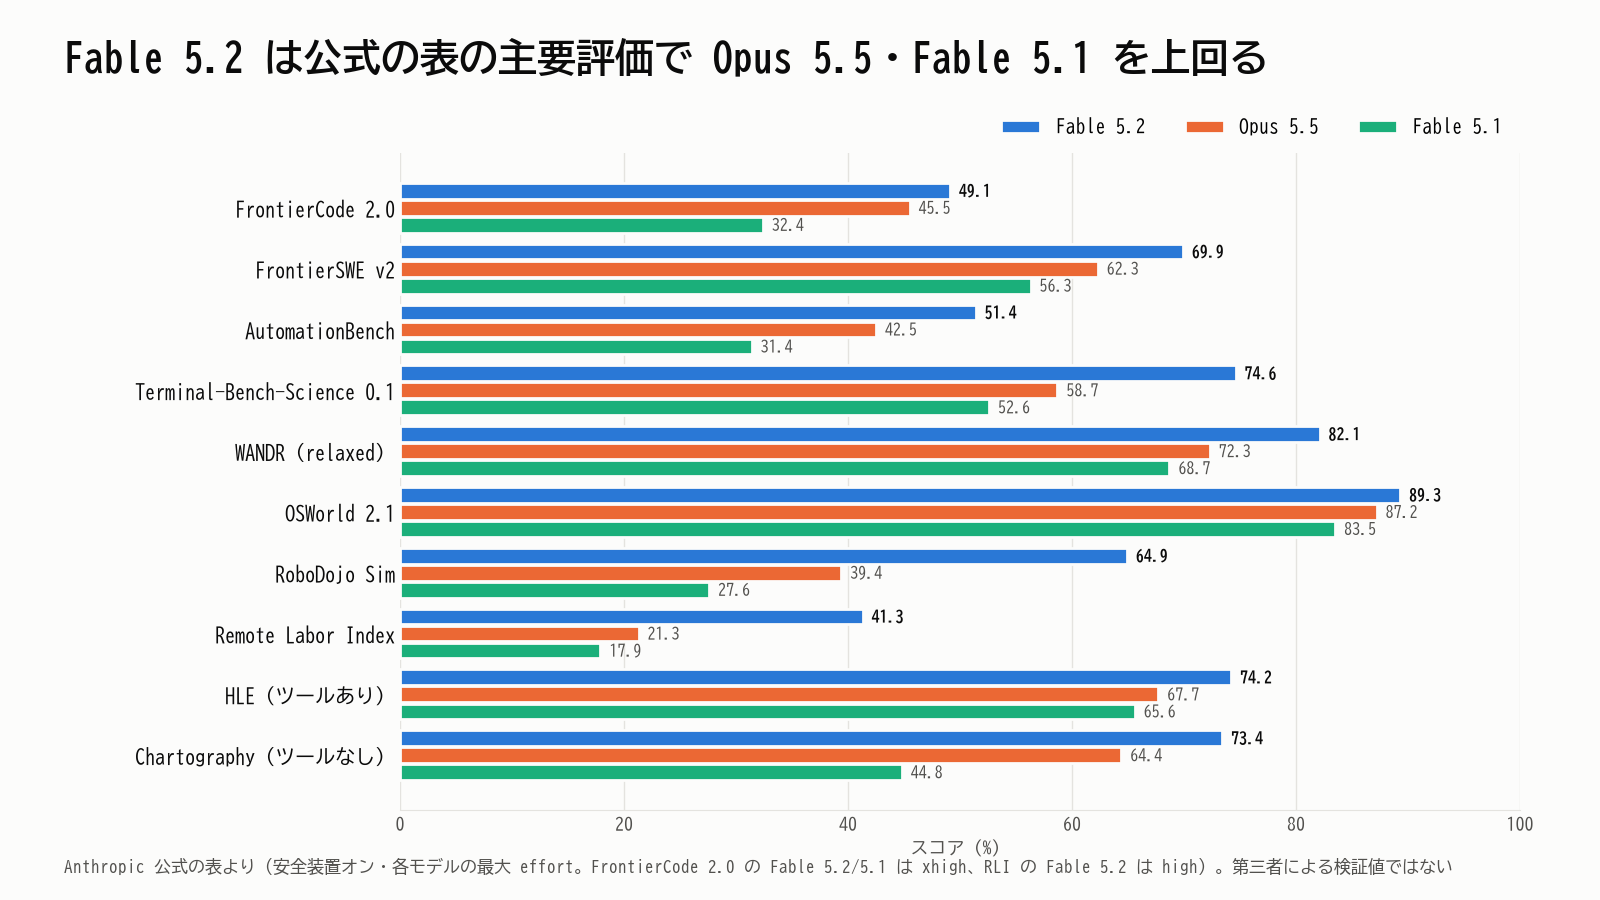
図3:公式の表の主要評価。青(Fable 5.2)がどの行でもいちばん長い。伸び幅が大きいのはロボット制御と在宅業務
図3で見てほしいのは、青と橙の差が行によって大きく違うことです。パソコン操作の OSWorld 2.1 では 2.1 ポイント差しかないのに、RoboDojo Sim(カメラ画像から2本腕ロボットを動かす)では 39.4% → 64.9%、Remote Labor Index(知識労働の評価)では 21.3% → 41.3% と、ほぼ倍に開いています。画面やカメラ越しに状況をつかみ、長い手順を最後までやり切る種類の課題ほど差が大きい、というのが表の読み方です。
公式の言い方は「評価したほぼすべての能力で Opus 5.5 の一段上」で、「すべて」ではありません。同じ表を他社モデルまで含めて見ると、AutomationBench では Gemini 4 Carbon が 53.9% で Fable 5.2 を上回り、知識労働の AA-Briefcase v1.1 は採点基準のスコアでは Fable 5.2 が上(66.1% 対 61.2%)でも、対戦形式の Elo では Opus 5.5 が上(1800 対 1785)です。
同じ点数をどれだけ安く出せるかも公式は示しています。FrontierCode 2.0 では Fable 5.2 の high が Opus 5.5 の最高点(max)とほぼ同点(45.3% 対 45.5%)で、1課題あたりのコストはおよそ半分。Humanity’s Last Exam では Fable 5.2 の low が Opus 5.5 の最高点に並び、コストは10分の1未満、とされています。単価は Opus 5.5 の2倍でも、少ない effort で同じところに届くなら、1課題あたりでは安くなる場合がある、ということです。
2-4. 公式が挙げた事例
数字だけでは何ができるのか分かりにくいので、公式発表に出てくる事例を3つ挙げます。いずれも Anthropic の説明で、外部の検証を経たものではありません。
電子機器を3つ、ゼロから設計した。 1段落のプロンプトで、自前の基板・3Dプリントの筐体・ソフトウェアをもつ電子機器を3つ設計・製作させた、という実験です。作ったのは家庭用の音声アシスタントのハブ、USB スピーカーフォン、手のひらサイズの電子ペット。基板の設計・製造を手がける Diode 社との共同です。Claude は仕様を自分で書き、米国の部品商社から入手可能な部品を選び、4層基板を配線し、筐体を CAD でモデリングし、ソフトウェアを書きました。どの基板も1日未満・人の手をほとんど借りずに製造できる状態になり、Diode 社が基板を作ったあとは Claude が同社のエンジニアに試験と組み立てを手引きし、3つとも電気的な手直しなしで動いた、とされています。ハードウェア設計を測る BenchCAD 2.1(参照の形状・回路にどれだけ近い設計を出せるか)では、max effort で Fable 5.2 が 83.5、Opus 5.5 が 65.3、Fable 5.1 が 44.4 です。
本番サービスを Python から Rust へ移した。 Fable 5.2 の開発途中の版で動くエージェントのチームが、重要な本番サービスを Python から Rust に移植し、そのサービスは効率と信頼性が上がり、起動が約26倍速くなったとのこと。また、空のフォルダから OS のプロトタイプを作らせた実験では、1,000を超えるサブエージェントを束ねて8日間休みなく書き・試し・見直し、ノートパソコンで起動し、ディスク・キーボード・ネットワークのドライバ、ファイル保存、ウィンドウ、ログイン画面、インストーラまで備えた OS ができた、と書かれています。
フェルマーの最終定理の形式化が30時間に。 形式化とは、数学の証明をコンピュータが1ステップずつ検査できる言語(ここでは Lean)に書き直す作業です。9月7日の記事で扱った最初の形式化は、未公開の研究版 Claude が専用の仕組みと研究者の指導のもとで11日かけたものでした。今回は1,000体の Fable 5.2 エージェントが、人の介入をほとんど受けずに30時間で完了。必要な行動トークンは最初の形式化の3分の1、出来上がった証明は7分の1の長さだったそうです。同じ1,000体構成の Opus 5.5 は、18時間で全体の26%しか進まなかったと公式は書いています。
ほかにも、Fable 5.2 がブラックホールに関する理論物理の未解決問題2つを解いた、Mythos 5.2 がウイルスの殻(カプシド)全体の立体構造を既存の予測モデルを組み合わせて予測する方法を見つけた(34件中28件を正確にモデル化)、といった事例が並んでいます。
3. 💰 価格と提供
3-1. API の単価
| 課金の種類 | Fable 5.1 | Fable 5.2 | Opus 5.5 |
|---|---|---|---|
| 入力 | $10 | $8 | $4 |
| キャッシュ書き込み(5分) | $12.50 | $10 | $5 |
| キャッシュ書き込み(1時間) | $20 | $16 | $8 |
| キャッシュ読み取り | $0.25 | $0.20 | $0.20 |
| 出力 | $50 | $40 | $20 |
| Batch(入力 / 出力) | $5 / $25 | $4 / $20 | $2 / $10 |
| Fast mode(入力 / 出力) | — | $16 / $80 | $8 / $40 |
単価は100万トークンあたりの米ドル(Claude Platform の料金表、2026年11月10日時点)。Mythos 5.2 は Fable 5.2 と同額です。
プロンプトキャッシュは、毎回同じ長い前置き(システムプロンプト、ツール定義、資料など)を送るときに、その部分をサーバー側に取っておいて再利用する仕組みです。初回は「書き込み」として少し高く課金され、2回目以降は「読み取り」として大幅に安くなります。Fable 5.2 の読み取りは基本入力の 0.025倍($0.20)で、通常のモデルの 0.1倍より安い設定が 5.1 から引き継がれました。
Batch(Message Batches API)は、急がない大量のリクエストをまとめて投げ、結果を後で受け取る方式です。待つ代わりに入力・出力とも半額になります。
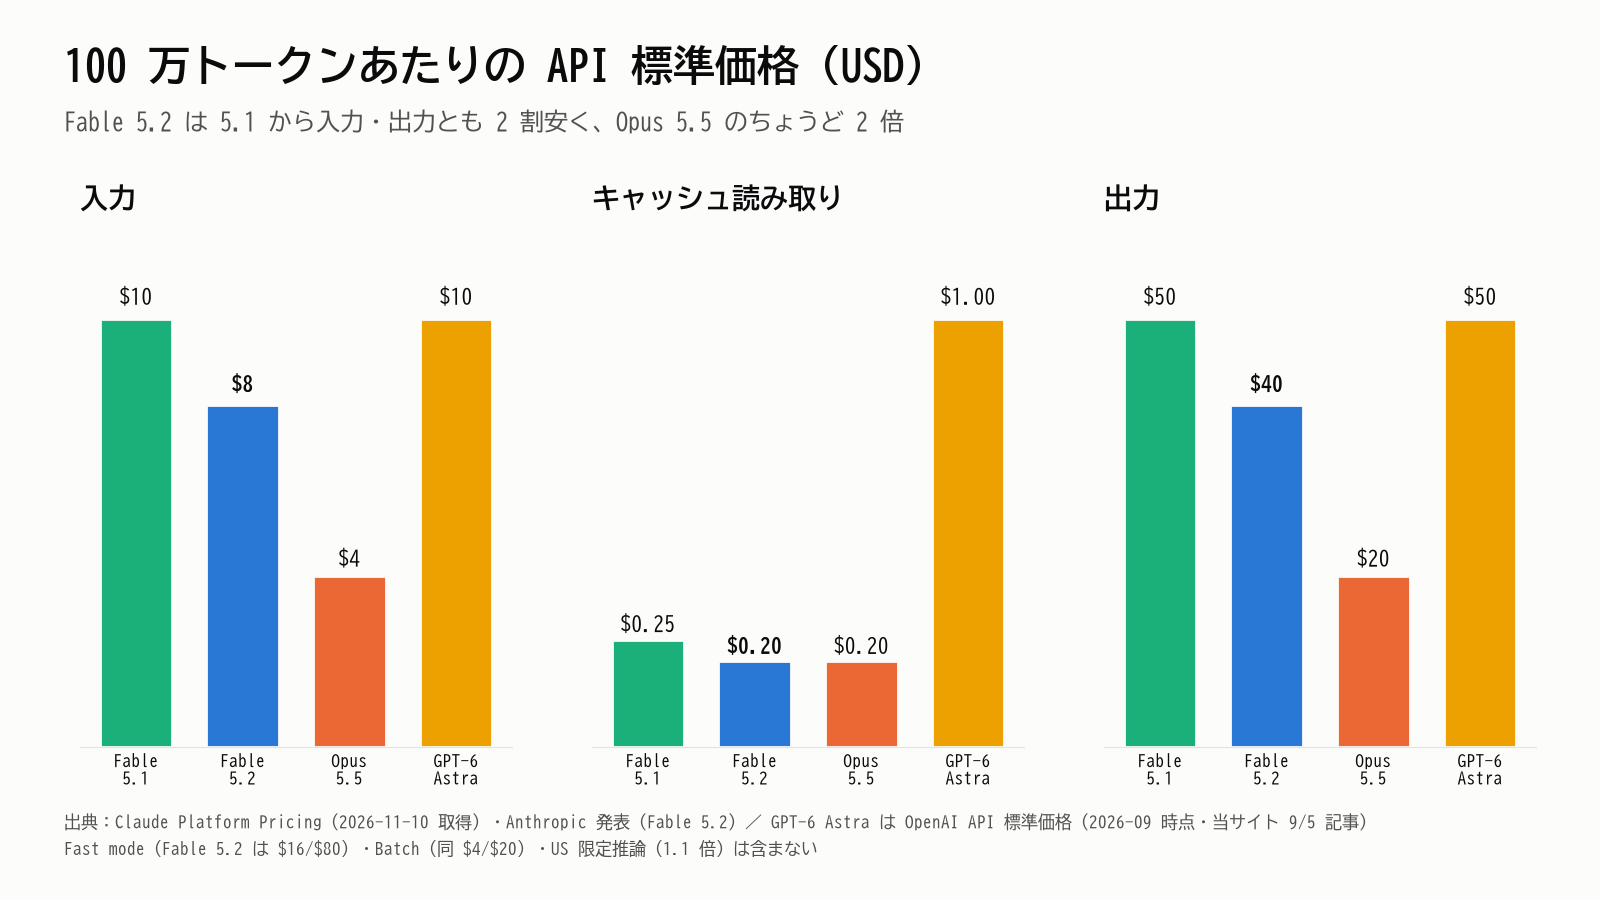
図4:100万トークンあたりの API 標準価格。Fable 5.2 はキャッシュ読み取りだけ Opus 5.5 と同額で、GPT-6 Astra の5分の1
図4で見てほしいのは、真ん中のキャッシュ読み取りの列です。入力と出力では Fable 5.2 は Opus 5.5 の2倍ですが、キャッシュ読み取りは両者とも $0.20 で同額です。長い資料を前置きに固定して何十ターンも往復する使い方では、Fable 5.2 と Opus 5.5 の差は見かけより小さくなります。
比較に入れた OpenAI の GPT-6 Astra は、9月の公開時点の API 標準価格が入力 $10・キャッシュ入力 $1・出力 $50 で、Fable 5.1 と同額でした(GPT-6 Astra の記事)。Fortune はこの点を取り上げ、Fable と Mythos の新モデルは「GPT-6 Astra より20%安い」と見出しで報じています。
もう一つ面白いのは、Opus 5.5 の Fast mode($8 / $40)が Fable 5.2 の標準価格と同額になったことです。同じ単価で「速い Opus」と「強い Fable」のどちらを買うか、という選択肢ができました。
米国内だけで推論させる指定(inference_geo: "us")を付けると、全項目が1.1倍になります。これは Claude 4.6 以降のモデル共通のルールです。
3-2. 使える場所と、プランでの扱い
API では全顧客が申請なしで使えます。モデル ID は次のとおりです。
| 提供先 | Fable 5.2 のモデル ID |
|---|---|
| Claude API/Claude Platform on AWS | claude-fable-5-2 |
| Amazon Bedrock | anthropic.claude-fable-5-2 |
| Google Cloud(Anthropic 運用・Google 運用) | claude-fable-5-2 |
| Microsoft Foundry(Anthropic 基盤) | claude-fable-5-2(Fast mode は claude-fable-5-2-fast) |
Mythos 5.2 は claude-mythos-5-2(Bedrock は anthropic.claude-mythos-5-2)で、Claude Platform on AWS には載っていません。どちらも提供終了は2027年11月9日より前にはしない、とされています。
Claude のサブスクリプションには、公開記念の期間限定の扱いがあります(Claude Help Center)。
- Pro と Team の標準席:11月9日から16日(米国太平洋時間)の1週間、Fable 系モデルを週の利用上限の最大50%まで追加料金なしで使える。加えて Fable の利用分を戻す「リセット」が1回
- Max・Ultra・Team のプレミアム席など:加入期間に応じてリセットが1〜3回(6か月未満は1回、6〜12か月は2回、12か月超は3回。期限は2027年3月8日)
リセットは上限を引き上げるものではなく、それまでに Fable に使った分の週次の利用量を戻す仕組みです。Help Center は「Fable のモデルは他の Claude モデルより速く上限を消費する」とも注意しています。
3-3. 運用面の条件
レート制限は、1分あたりに送れるリクエスト数やトークン数の上限です。Fable 5.2 は Fable 5.1・Fable 5 と共有だった枠から外れ、単独の枠を持ちます。Opus 5.5 からの移行では、各段階のトークン上限が Opus 5.5 より低い点に注意が要ります。
ZDR(Zero Data Retention) は、Anthropic 側にリクエストの中身を保存させない契約です。Fable 5.2 と Mythos 5.2 は安全監視のために30日間のデータ保持が必須で、Anthropic が明示的に認めた場合を除き ZDR では使えません(保持設定のない組織から呼ぶと 400 エラー)。公式は、顧客側の基盤に保存したデータで安全監視を回す Enterprise Frontier Safeguards を非公開ベータで始めており、これを使えば ZDR と両立できるとしています。
CMEK(customer-managed encryption keys) は、保存データの暗号鍵を顧客自身が管理する設定です。CMEK の組織では、Fable 5.2 で構造化出力(スキーマどおりの JSON を返させる機能)が使えません。
4. 🛡️ 安全装置はどう変わったか——普通の開発で引っかかりにくく
Fable 系モデルには、高リスクなサイバー活動(侵入テスト、エクスプロイトの生成、バイナリからの脆弱性探しなど)と、研究レベルの生物学の大半をブロックする分類器が付いています。この部分の守りの強さは 5.1 と同等のまま、不要なブロックを減らしたのが 5.2 の変更です。
- claude.ai・Claude Code・Cowork での初期テストで、ブロックは Fable 5.1 比で約55%減
- 内訳はサイバーで約60%減、生物学で約40%減
コーディング中に、たまたまセキュリティ寄りの単語が並んだだけで止められる場面が減る、ということです。セキュアコーディングや設定の見直しのような防御側の作業ほど恩恵があります。
ブロックされたらどう返ってくるか
API では、拒否は HTTP 200 のまま stop_reason: "refusal" で返り、stop_details にどの方針の領域で止まったかが入ります。エラーではないので、例外処理だけを見ていると気づけません。
stop_reasonが"refusal"かどうかを必ず分岐する- 拒否されたリクエストを別のモデルで再実行したい場合は、サーバー側フォールバック(ベータ)で
fallbacks: "default"を指定するか、SDK のミドルウェアか自前の再試行で行う。Fable 5.2 の振り替え先として認められているのは Claude Opus 4.8 と Claude Opus 5 - 出力前の拒否が課金されるかは拒否の種類によるが、レート制限にはどちらにせよ数えられる
ブロックされた場合、利用者にはサイバーなら Opus 4.8、生物学なら Opus 5 からの応答が返る、と公式発表は説明しています。
その他の安全面の数字
- 蒸留対策:蒸留(distillation)とは、強いモデルの出力を大量に集めて別のモデルを訓練し、能力を抜き取る行為です。Anthropic は数千の偽の Claude アカウントで行われることが多いと説明しており、Fable 5.2 には同社のモデルでもっとも強い対策を入れ、収集されるデータを90〜99%減らしたとしています。また、保存された思考(preserved thinking)が全アカウントに適用されるようになり、蒸留者が Claude の以前の文脈を編集して推論を抜き取るのを防ぐ、とされています(後述する「前方の編集チェック」と同じ仕組みです)。蒸留の基礎は蒸留攻撃とは何かの記事にまとめています
- Mythos 5.2 のサイバー能力:公式は Mythos 5.2 を「サイバーセキュリティ工学でもっとも有能なモデル」としています。公開済みの CVE(ソフトウェアの脆弱性に振られる共通の識別番号)を、修正前のソースから独力で見つけ直せるかを測る社内評価 CVE Rediscovery(1,829件)では、Mythos 5.2 が 89.6%、安全装置なしの Opus 5.5 が 81.3%、Mythos 5.1 が 78.3%。発見数で Opus 5.5 より10.2%、Mythos 5.1 より14.4%多い計算です。ただし公式は脚注で、自社の別の評価では脆弱性の特定は Opus 5.5 とおおむね同等だとも書いています
- サンドボックス脱出:意図的に弱点を仕込んだサンドボックスで、多くが脱出しないと解けない1,800以上のシナリオを用意した評価で、Mythos 5.2 がサンドボックス外に置いた資格情報やファイルを使ったのは3.1%。Opus 5.5 の3.3%とほぼ同じで、Sonnet 5.5 の5.1%より少なく、Mythos 5 の39%・Mythos 5.1 の21%から大きく下がっています
公式はリスク評価として「高リスクな場面で安全でない振る舞いをするリスクは、最近の他のモデルと同様に低い」としています。同時に、Fable 5.2 と Mythos 5.2 は「評価されているのでは」と口にする頻度が最近のモデルでもっとも高く、評価だけで実環境の振る舞いを見積もる難しさが増している、とも率直に書いています。詳細は System Card(PDF)にあります。
5. 🔧 開発者に効くところ——移行の注意
Fable 5.1 からの移行は、公式ドキュメントの言葉で「ほぼそのまま差し替え」です。モデル名を claude-fable-5-2 に変えれば動く場合がほとんどですが、4つの変更がコードを壊しうると明記されています。
adaptive thinking が考えた中身は、応答の中に thinking ブロックとして返ってきます。次のリクエストでは、このブロックを会話履歴に入れて送り返すことで、モデルは前のターンの考えを引き継げます。
このとき API は、ブロックが作られた時点からそれより前の部分(システムプロンプト・ツール定義・それ以前のメッセージ)が書き換えられていないかを検査します(prefix check)。書き換えがあると、そのブロックは「別の会話に属する」とみなされます。
全アカウントで有効に"] B --> C["③ computer_20251124 を
computer_toolset_20260801 へ"] C --> D["④ advisor を
Fable 5.2 か Mythos 5.2 へ"] D --> E["⑤ レート制限・effort・
コストを測り直す"]
図5は、5.1 から移るときに上から順に確かめる項目です。見てほしいのは②で、ここだけは「自分のアカウントでは今まで問題なかった」が通用しません。
| # | 破壊的変更 | 起きること | 対処 |
|---|---|---|---|
| 1 | 前方の編集チェックが全アカウントで有効 | 履歴を書き換えて thinking ブロックを送り返すと 400 | 履歴は追記だけにする。調査中は drop_block で一時回避 |
| 2 | 5.2 の thinking ブロックは 5.2 と Mythos 5.2 しか読めない | 5.2 から別モデルへ切り替えると、その思考は捨てられる | エラーにはならない。切り替え直後のコストと遅延を見込む |
| 3 | computer_20251124 が使えない |
Bedrock 以外で 400 | computer_toolset_20260801 に移す |
| 4 | advisor ツールの組み合わせ | Fable 5.2 の実行役には Fable 5.2 か Mythos 5.2 の助言役しか付けられない | advisor の model を同時に変える(新しい会話で) |
1 について補足します。5.1 では、このチェックは2026年8月31日以降に作られたアカウントにしか既定で効いていませんでした。そのため古いアカウントでは、5.1 で通っていたコードが 5.2 で 400 になることがあります。一方で、Claude Code・claude.ai・Claude Managed Agents・Claude Agent SDK が履歴を組み立てている場合は何も変わりません。影響を受けるのは、messages の配列を自前のコードで組み立て、途中で古いメッセージを書き換えたり、ツール一覧を会話の途中で差し替えたりしている場合です。会話途中でツールを足し引きしたいときのために、tools を書き換えずに済む「会話途中のツール変更(ベータ)」と、古いターンを要約に置き換えるタイミングを自分で決める「Compaction on demand(ベータ)」が用意されています。
5.1 から変わっていない制約もまとめておきます。tool_choice でツール呼び出しを強制する指定、アシスタント応答の先頭を埋めておく prefill、temperature・top_p・top_k の指定は、いずれも 5.1 と同じく使えません。Priority Tier(優先処理の契約枠)にも対応していません。
振る舞いの違いとして公式が挙げているものもあります。
- 「考えずにすぐ答えて」のような指示では、
medium以上の effort で考えるのを止められない。軽い質問が遅い・高いと感じたら、指示ではなく effort を下げる - そのため
max_tokensを小さくしていると、思考だけで上限に達して本文が出ないことがある xhighやmaxでは、自分の作業をサブエージェントに見直させることがある。サブエージェントがセッションのコストの大きな部分を占めうる- 長い多段の作業で、残りの作業のリストを出して止まることがある(
lowとmediumで多い)
Claude Code を使っているなら、移行作業そのものを任せる方法が公式の移行ガイドの冒頭に載っています。
/claude-api migrate this project to claude-fable-5-2
6. 🪜 どのモデルを使うか
公式の推奨ははっきりしています。
多くのコーディングと知識作業では、まず最強の普段使いモデルである Claude Opus 5.5 から始め、作業の範囲と複雑さに応じて、上の Fable・Mythos へ、または下の Sonnet 5.5・Haiku 5.5 へ切り替える
開発者向けのドキュメントはさらに具体的で、「high 以上の effort にした Opus でも評価が要求に届かないときに Fable 5.2 へ」と書いています。
審査を通った組織のみ"] F["Fable 5.2 $8 / $40
高い effort の Opus でも
足りないとき"] O["Opus 5.5 $4 / $20
まずここから(公式推奨)"] S["Sonnet 5.5 $2 / $10
速さ重視の作業"] H["Haiku 5.5 $0.10 / $0.50〜
大量・軽い処理"] Y --- F F ---|足りなければ上へ| O O ---|軽くてよければ下へ| S S --- H
図6は、Anthropic の現行モデルを価格順に並べた梯子です(価格は入力 / 出力、100万トークンあたり)。見てほしいのは、出発点が真ん中の Opus 5.5 だという点です。最上段の Fable から下げていくのではなく、Opus 5.5 で試して足りないところだけ上げる、というのが公式の考え方です。
公式発表は、Fable 5.2 を単独で使う以外の組み合わせも挙げています。Haiku・Sonnet・Opus が難問のときだけ相談する 助言役(Advisor) と、簡単な作業を小さなモデルに配る 指揮役(Orchestrator) です。
- 迷ったら Opus 5.5。effort を
high・xhighと上げても足りない課題だけ Fable 5.2 に回す - 単価ではなく1課題あたりのコストで比べる。Fable 5.2 の
highは FrontierCode 2.0 で Opus 5.5 のmaxと同点、コストは約半分だった(公式値) - 長い前置きを固定して何十ターンも回すならキャッシュが効く。キャッシュ読み取りは Fable 5.2 も Opus 5.5 も $0.20
- 待ち時間が問題なら Fast mode も候補。Opus 5.5 の Fast mode は Fable 5.2 の標準と同じ単価
- 大量の軽い処理は Haiku 5.5 に配る。Fable 5.2 を指揮役・助言役に置く構成もある
- サイバー・生命科学の研究用途で Fable の安全装置が妨げになるなら、Verification Program を通じて Mythos 5.2 を申し込む
effort と段の選び方の基礎は Claude Sonnet 5.5 の記事、小型モデルにサブエージェントを任せる勘定は Claude Haiku 5.5 の記事で詳しく扱っています。
発表のタイミングについて
CNBC は、この公開が Anthropic の IPO(新規株式公開)に向けた準備の中で行われ、上場が早ければ来週にもありうると報じました。Anthropic の財務の中身は、S-1(上場申請書類)を一次資料で読んだ記事と決算報道の記事にまとめています。
発表を読んでいちばん手が止まったのは、ベンチマークの表ではなく「電子機器を3つ作った」の段落でした。部品を選んで、4層基板を配線して、筐体を CAD で起こして、ファームを書く。筆者が ESP32-S3 のセンサー基板や RP2040 のロジックアナライザで何週間もかけた工程を、1段落のプロンプトから1日未満で製造可能なところまで運び、3台とも電気的な手直しなしで動いた、と書かれています。公式の主張であって筆者が確かめたものではありませんが、試作基板の1回目でパターンカットやジャンパ線が要らないことがどれだけ珍しいかは、基板を起こしたことのある人なら知っているはずです。8月の MHS(AI エージェントが実機を操作するための規格)と合わせて、Anthropic がハードウェアをはっきり守備範囲に入れてきたことが分かります。
一方、日々の作業に効くのは地味な数字のほうだと思っています。筆者は Claude Code のスキルから ESP-IDF を直接叩かせていて、毎ターン読み直させる前置き(プロジェクトの規約、ボードのピン配置、データシートの抜粋)がとにかく長い。その使い方では、効くのは入力の単価よりキャッシュ読み取りの単価で、そこが Opus 5.5 と同じ $0.20 になった、というのが今回の価格表でいちばん大きな行に見えます。ただし筆者は Fable 5.2 を API の従量課金で長時間回した実測をまだ持っていないので、ここは料金表から読める構造の話です。
試してみたいのは「Opus 5.5 で始めて、詰まったら Fable 5.2」という公式の勧めどおりの運用です。データシートの数百ページを読ませてレジスタ設定を起こすような作業は Opus 5.5 の high で十分なことが多く、Fable が要るのは、たとえば複数の Claude Code を並べて回すような長い作業の指揮役のほうかもしれません。Claude Code の既定 effort が medium である点と、medium 以上では「考えずに答えて」が効かない点は、移行した初日に気をつけたいところです。
まとめ
| 観点 | 内容 |
|---|---|
| 発表 | 米国時間2026年11月9日(日本時間10日)、Claude Fable 5.2 と Claude Mythos 5.2 |
| 関係 | 同じモデル。Fable は安全装置つきで誰でも、Mythos は審査を通った組織だけ |
| 速度 | 出力の生成が 5.1 比で最大30%速い。Fast mode はトークン生成が最大2.5倍 |
| 価格 | 入力 $8・出力 $40(5.1 の $10・$50 から2割減)。キャッシュ読み取り $0.20 |
| 性能 | 公式の表の主要評価で Opus 5.5 を上回る(「ほぼすべての能力で一段上」) |
| 安全装置 | 守りは 5.1 と同等で、ブロックは約55%減(サイバー約60%減・生物約40%減) |
| 移行 | 破壊的変更4件。履歴を自前で組む場合は前方の編集チェックに注意 |
| 使い分け | まず Opus 5.5。高い effort でも足りないときに Fable 5.2 |
5.1 のときは「1行しか動かない値下げ」でしたが、5.2 は速度・価格・性能のすべてが前に進んだ更新です。それでも公式自身が「まず Opus 5.5 から」と言っているのは、Fable の2倍の単価に見合う課題が限られていることを分かったうえでの勧めでしょう。自分の課題で effort を振って測り、足りないところだけ一段上げる。その一段が、今回で速く・安くなりました。
よくある質問(FAQ)
Q. Claude Fable 5.2 は誰でも使えますか?
はい。Claude API では全顧客が申請なしで claude-fable-5-2 を使えます。Amazon Bedrock(anthropic.claude-fable-5-2)、Google Cloud、Microsoft Foundry、Claude Platform on AWS でも提供されています。ただし30日間のデータ保持が必須で、ZDR(データを保存しない契約)の組織では Anthropic の明示的な許可がない限り使えません。Claude Mythos 5.2 は Cyber Verification Program などの審査を通った組織だけが使えます。
Q. Fable 5.1 からどれくらい安くなりましたか?
入力は100万トークンあたり $10 から $8、出力は $50 から $40 へ、ともに2割下がりました。キャッシュ読み取りは $0.25 から $0.20、Batch は $4 / $20 です。Fast mode は $16 / $80 で、トークン生成が最大2.5倍になります。Opus 5.5($4 / $20)と比べると入力・出力は2倍ですが、キャッシュ読み取りは同じ $0.20 です。
Q. Fable 5.2 と Opus 5.5 はどちらを使えばいいですか?
公式は、多くのコーディングと知識作業でまず Opus 5.5 から始め、effort を上げた Opus でも足りないときに Fable 5.2 へ切り替えることを勧めています。Fable 5.2 は単価が2倍ですが、少ない effort で同じ点数に届く場合があり、公式の FrontierCode 2.0 の例では Fable 5.2 の high が Opus 5.5 の最高点とほぼ同点で、1課題あたりのコストは約半分でした。
Q. Fable 5.1 から移行すると何が壊れますか?
公式が挙げる破壊的変更は4つです。前に返した思考の部分より前を書き換えると 400 になるチェックが全アカウントで有効になったこと、Fable 5.2 の思考ブロックを Fable 5.1 などが読めないこと、旧来の computer use ツール computer_20251124 が Bedrock 以外で 400 になること、advisor ツールの助言役を Fable 5.2 か Mythos 5.2 にする必要があることです。Claude Code や Claude Agent SDK が会話履歴を管理している場合、1つ目の影響はありません。
Q. 安全装置で止められることは減りましたか?
公式の初期テストでは、claude.ai・Claude Code・Cowork でのブロックが Fable 5.1 より約55%減りました(サイバーで約60%減、生物学で約40%減)。守りの強さは 5.1 と同等とされています。API では拒否が HTTP 200 のまま stop_reason “refusal” として返るので、アプリ側でこの値を確認する必要があります。
Q. Claude Code ではどう使えばいいですか?
Claude Code では Fable 5.2 が使え、既定の effort は medium です。medium 以上では「考えずに答えて」といった指示で思考を止められないので、軽い作業が遅いと感じたら effort を下げます。既存のプロジェクトを API ごと移すときは、Claude Code に /claude-api migrate this project to claude-fable-5-2 と頼む方法が公式の移行ガイドに載っています。
関連記事
- Claude Fable 5.1 公開|キャッシュ読み取り75%減と5→5.1の差分:一つ前の版。「Fable と Mythos とは」とシステムカードの読み方はこちら
- GPT-6 Astra 公開|KiCadで基板を配線、サイバーは初の Critical:価格比較に使った OpenAI 側のフロンティアモデル
- フェルマーの最終定理をClaudeがLeanで形式化|証明済みの定理をなぜ機械で検証したのか:11日かかった最初の形式化。今回の30時間と比べて読める
- Claude Sonnet 5.5 公開|モデルの「段」と effort の選び方、1 タスクあたりコストの読み方:effort と段の選び方の基礎
- Claude Haiku 5.5 公開|入力 $0.10 の小型モデルとサブエージェントの勘定:梯子の最下段と、サブエージェントのコスト
- Anthropic「MHS」発表|AIエージェントが物理機器を安全に操作する規格:AI が実機を扱うための規格。ハードウェア設計の事例と合わせて
- Anthropic の S-1 を一次資料で読む|損失の正体と計算資源の調達構造:IPO 前の財務の中身
- Claude Code スキルで ESP32 開発を自動化:所感で触れた、長い前置きを毎ターン読み直させる使い方
参考
- Introducing Claude Fable 5.2 and Claude Mythos 5.2(Anthropic 公式・2026年11月9日)
- What’s new in Claude Fable 5.2(Claude Platform 公式ドキュメント)
- Claude Fable 5.2 and Claude Mythos 5.2 migration guide(Claude Platform 公式ドキュメント)
- Claude Fable 5.2 モデル概要(Claude Platform 公式ドキュメント)
- Claude Mythos 5.2 モデル概要(Claude Platform 公式ドキュメント)
- Pricing(Claude Platform 公式ドキュメント)
- Claude Fable 5.2 launch offers(Claude Help Center)
- Claude Fable 5.2 and Claude Mythos 5.2 System Card(Anthropic 公式・PDF)
- Anthropic releases first frontier models since Amodei’s call for slowdown as IPO buzz builds(CNBC・2026年11月9日)
- Anthropic debuts updated Claude Fable and Mythos models, priced 20% below OpenAI’s GPT-6 Astra(Fortune・2026年11月9日)